Répondre aux enjeux de souveraineté et de pénurie de GPU par l’inférence homomorphe des LLM
Nous avons testé l’inférence homomorphe assistée par un client, de GPT-2 à Qwen3.6-35B-A3B, avec un client CPU de confiance séparé. Méthodologie, débit mesuré, limites de confidentialité et leçons pour une IA confidentielle.
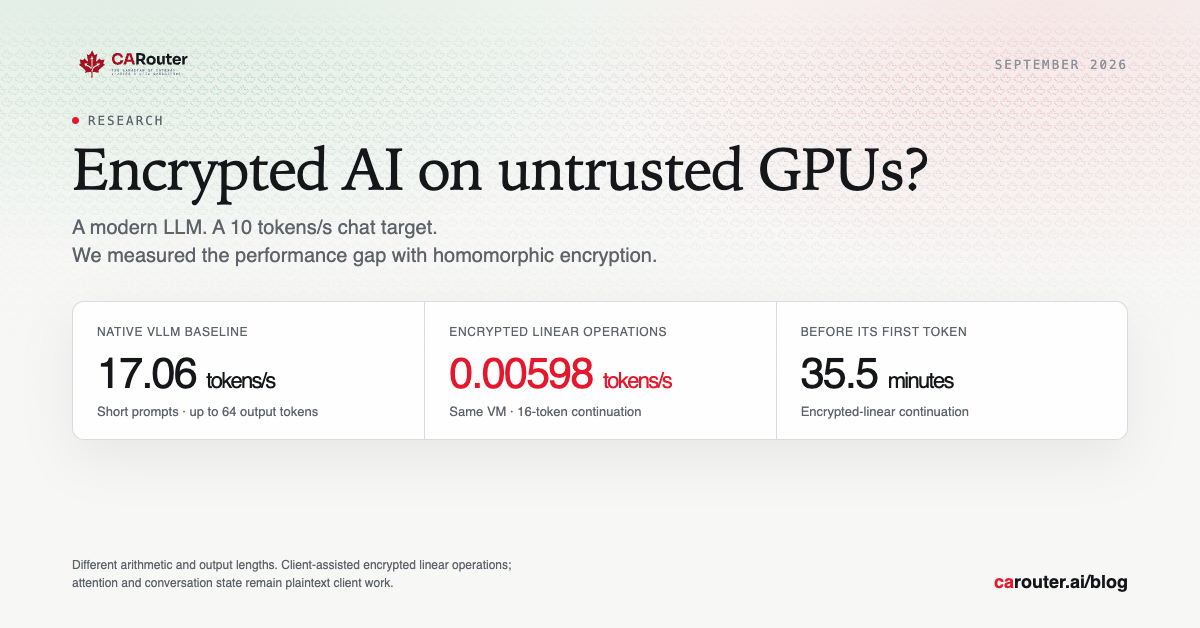
CARouter pourrait-elle utiliser des GPU exploités par des personnes auxquelles nous ne faisons pas confiance, tout en protégeant les requêtes de ses clients? Le chiffrement homomorphe rend cette question intéressante. Nous avons commencé avec GPT-2 sur un H100, puis testé Qwen/Qwen3.6-35B-A3B sur un A100 de Denvr doté de 80 Go de mémoire GPU. Ce deuxième essai porte sur un modèle beaucoup plus représentatif d’un service d’IA.
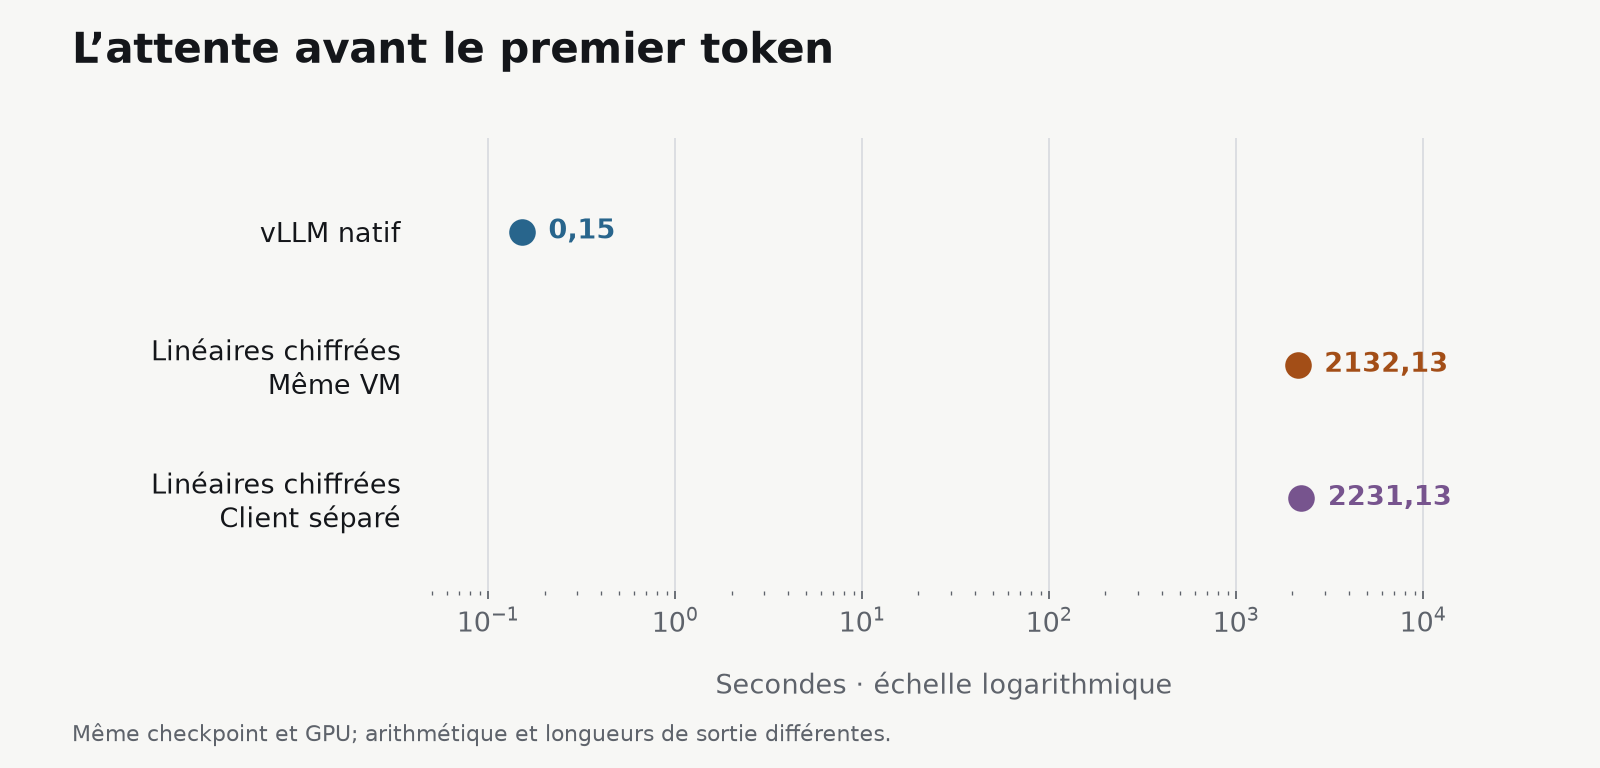
Notre seuil pour une conversation interactive était d’au moins 10 tokens sortants par seconde et par requête. La génération validée de 16 tokens avec calcul linéaire chiffré a atteint 0,00598 tokens/s, après 35,5 minutes d’attente avant le premier token : un débit environ 1 673 fois inférieur au seuil. Un token est un petit fragment de texte, souvent une partie de mot. Nous ne bâtirions pas un service de conversation confidentielle interactive sur cette implémentation.
Merci à Denvr : son programme AI Ascend a accordé à CARouter 1 000 $ en crédits de calcul, qui ont rendu ces expériences possibles. Ces crédits ont financé les essais GPU du modèle moderne et le contrôleur CPU dédié. Nous remercions Denvr pour ce soutien matériel; les mesures et les conclusions sont les nôtres.
Le problème de confidentialité commence en mémoire
Le chiffrement protège une connexion ou un disque, mais l’inférence ordinaire manipule toujours les requêtes et l’état de la conversation en clair dans la mémoire de travail. L’administrateur d’un hôte classique peut avoir accès à cette mémoire, y compris au cache KV. Chiffrer un volume au démarrage ne l’en empêche pas, et supprimer une VM ne prouve pas que son propriétaire a effacé toutes les copies.
Le chiffrement homomorphe permet à une machine de calculer sur des valeurs chiffrées et de renvoyer un résultat chiffré. Le chiffrement entièrement homomorphe, ou FHE, étend ce principe au calcul général. Il faut un moteur de calcul compatible : Terraform et dstack peuvent gérer le cycle de vie des VM, mais placer vLLM dans un conteneur chiffré ne rend pas ses calculs homomorphes.
Du petit modèle exploratoire au checkpoint moderne
Le premier essai sur H100 utilisait GPT-2 pour vérifier que nous pouvions générer du texte avec des opérations linéaires chiffrées et contrôler les résultats. La meilleure variante validée pour une requête, avec les poids préparés en cache, a atteint 0,16 tokens/s et environ 33,2 secondes avant le premier token. Ces essais courts, après échauffement, ont permis de tester le mécanisme. GPT-2 ne représente toutefois pas la qualité de modèle attendue aujourd’hui.
Pour l’expérience chez Denvr, nous avons fixé les versions du checkpoint public BF16, du tokenizer et des logiciels. Nous avons utilisé PyTorch 2.9.1+cu128, Transformers 5.17.0 et Concrete ML Extensions 0.1.9 de Zama. La bibliothèque de Zama assurait les opérations linéaires chiffrées; les autres calculs du modèle s’exécutaient côté client. Nous avons d’abord vérifié le chargement du vrai checkpoint, sans paramètres manquants ou incompatibles dans le modèle de texte. Les essais sur un minuscule modèle aléatoire ne validaient que l’intégration; ils n’ont fourni aucun chiffre de performance du modèle cible.
Le modèle repose sur un mélange d’experts : chaque token n’active que certains réseaux experts. Nous avons intercepté les produits linéaires fonctionnels en plus des modules linéaires ordinaires, pour inclure les projections des experts sélectionnés et celle du vocabulaire de sortie. L’attention, les opérations non linéaires, l’état récurrent, les embeddings et la sélection des tokens restaient en clair côté client. Il s’agit d’une inférence linéaire chiffrée assistée par un client, et non d’un transformer entièrement chiffré.
Comment nous avons mesuré les performances
Nous avons établi une référence de service avec vLLM, une référence de génération native dans le même framework, puis une référence quantifiée en clair utilisant les mêmes calculs que l’adaptateur chiffré. Celui-ci quantifie les activations et les poids en valeurs signées sur 8 bits; la mention BF16 du checkpoint ne signifie donc pas que les calculs chiffrés se font en BF16. La référence de service utilisait une génération déterministe, le raisonnement désactivé et une exécution sans graphes CUDA, avec des requêtes courtes et longues répétées ainsi qu’un groupe simultané. Les préfixes pouvaient être réutilisés; nous ne cherchions pas la capacité maximale.
Pour la génération chiffrée, les requêtes synthétiques publiques contenaient 21 tokens après mise en forme conversationnelle. La requête longue demandait pourquoi le chiffrement est important; la courte demandait combien font deux plus deux. Nous avons mesuré séparément l’attente du premier token, le décodage suivant et la durée totale de la requête. Le débit de décodage exclut le premier token. Le chargement du modèle, la création des clés, l’envoi de la clé publique et le démarrage des VM sont exclus de ces durées.
Le premier déploiement plaçait le client et l’évaluateur sur la même VM GPU pour mesurer le calcul. Son propriétaire pouvait lire la clé du client et sa mémoire en clair. Nous avons ensuite séparé l’évaluateur et un client limité à 4 CPU et 12 Gio de mémoire. La clé privée restait dans la mémoire du processus CPU; le GPU recevait une clé publique de compression et des activations chiffrées. L’attention et l’état KV restaient sur la VM CPU.
Résultats mesurés avec le modèle moderne
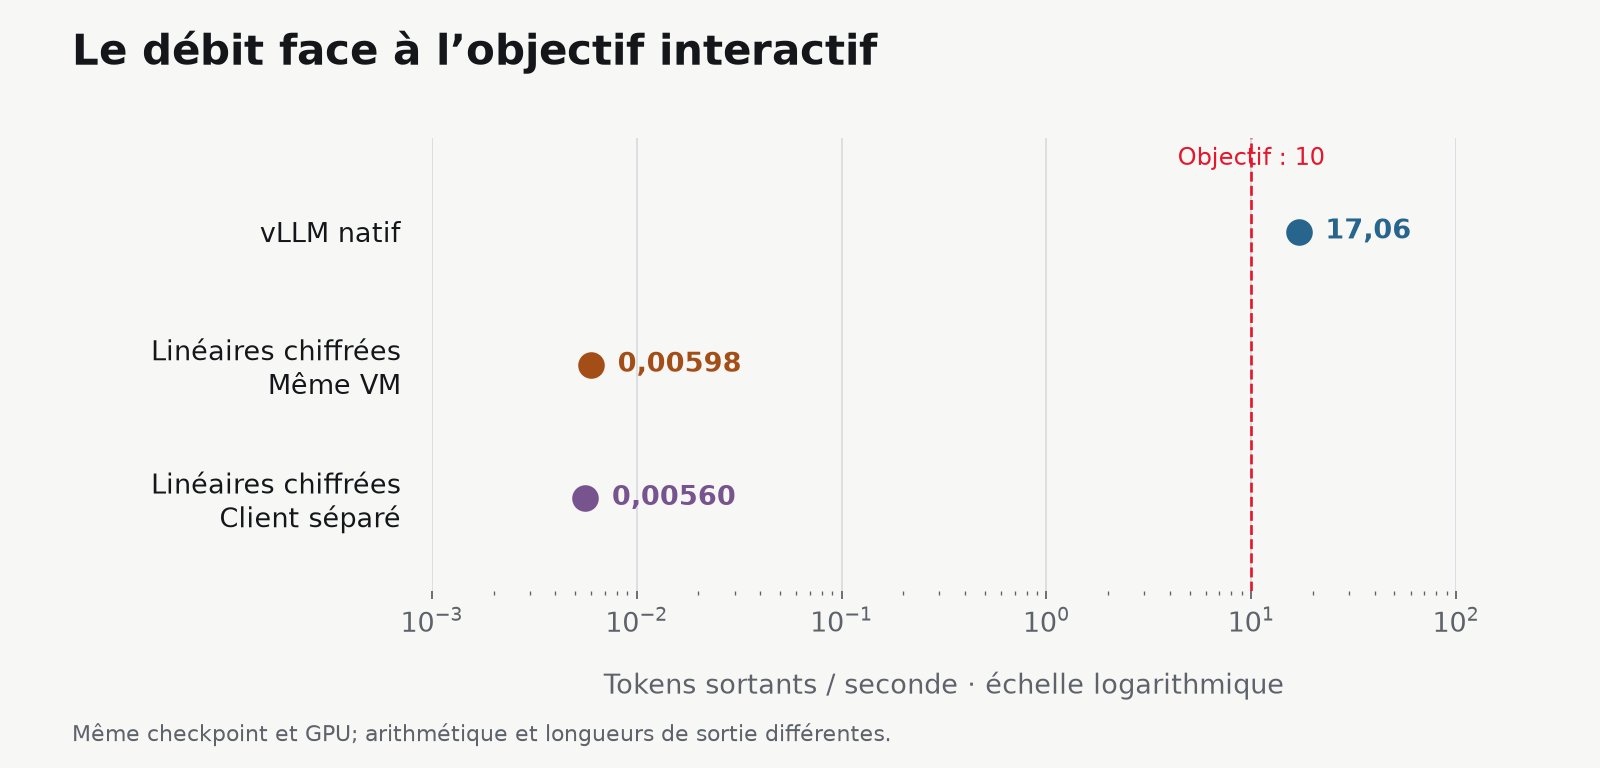
| Mode d’exécution | Tokens sortants | Tokens sortants/s | Premier token (s) |
|---|---|---|---|
| vLLM natif, requêtes courtes | Jusqu’à 64 | 17,06 | 0,15 |
| Opérations linéaires chiffrées, même VM | 16 | 0,00598 | 2 132,13 |
| Opérations linéaires chiffrées, client CPU séparé | 2 (dont fin de séquence) | 0,0056 | 2 231,13 |
La génération chiffrée longue s’est terminée et tous les scores de sortie conservés correspondaient exactement à la référence quantifiée. Elle a atteint sa limite de longueur au milieu d’un paragraphe; il ne s’agissait pas d’une évaluation de la qualité d’une réponse complète. Nous avons volontairement arrêté la répétition supplémentaire après validation indépendante de la requête terminée. Elle n’ajoute aucun échantillon de débit.
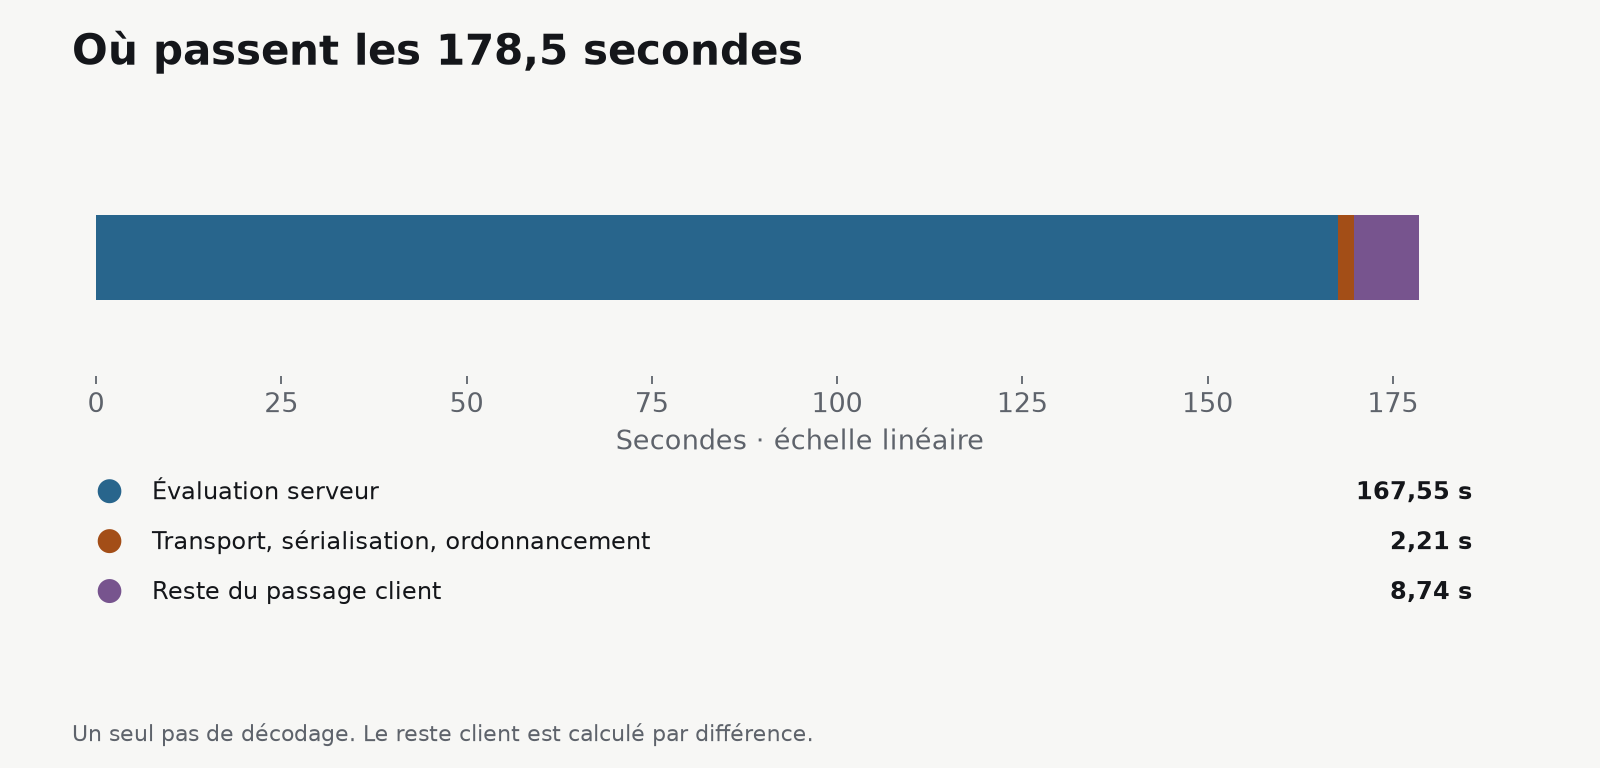
L’essai avec client séparé a renvoyé « 4 », puis le token de fin de séquence. Tous deux comptent dans sa sortie de deux tokens, ce qui laisse une seule étape de décodage après le traitement de la requête. Cette étape a pris 178,5 secondes. C’est un essai réseau court, pas une estimation du débit sur une longue conversation. Tous ses scores conservés correspondaient eux aussi exactement à la référence.
La référence de service native a atteint environ 17,06 tokens/s par requête courte. Cela montre que le matériel loué peut servir ce checkpoint; les calculs diffèrent toutefois de ceux de l’adaptateur quantifié. Le débit natif simultané et les lots de matrices synthétiques ne constituent pas des mesures du débit chiffré du modèle par lots, que nous n’avons pas mesuré ici.
Les débits natifs sont estimés à partir du contenu diffusé et du nombre de tokens déclaré; la colonne du premier token correspond au premier contenu reçu. Les modes chiffrés chronomètrent chaque passage du modèle et la sélection du token. Nous conservons ces conventions et les échantillons bruts de service dans nos archives de benchmark.
La justesse avant la vitesse
Nos premiers essais de précision ont révélé des réglages qui généraient du texte sans réussir la comparaison numérique. Les essais du modèle moderne ont repris les précisions supérieures validées pour le stockage des chiffrés et le changement de clé. Nous avons contrôlé les produits entiers chiffrés lors de l’audit du modèle complet, puis enregistré et relu indépendamment les tenseurs de scores de chaque requête chiffrée terminée. La tolérance est restée à 0,005; l’écart maximal observé était nul.
Cela établit l’accord avec la référence quantifiée testée. Cela ne prouve pas une qualité de réponse égale à celle du checkpoint original : les suites de texte natives et quantifiées différaient. Nous n’avons mené ni évaluation de qualité sur un ensemble de tâches, ni examen cryptographique indépendant. Les échecs de configuration, l’erreur de sérialisation et les interruptions volontaires restent dans les archives, sans être comptés comme des inférences réussies.
Le réseau n’était pas la principale source d’attente
L’étape de décodage avec client séparé a passé 167,5 secondes dans le traitement chronométré par l’évaluateur. L’écart avec le temps aller-retour mesuré côté client était de 2,2 secondes, regroupant transport, sérialisation et ordonnancement. Ce n’est pas une mesure de latence réseau pure. Le calcul chiffré et le traitement des poids dominaient le délai; changer d’orchestrateur de VM ne supprimerait pas ce travail.
L’essai réseau a transféré 53,3 Mo de données applicatives pendant cette étape de décodage, au fil de 1 031 appels linéaires séquentiels. L’envoi initial de la clé publique de compression a ajouté 536,9 Mo et pris 2,09 secondes, séparément de l’inférence. Ces volumes excluent le surdébit HTTP, SSH et TCP. La comparaison avec l’essai sur une seule VM n’isole pas non plus le réseau : l’exécution côté client et les contrôles de produits entiers différaient aussi.
Nous avons testé séparément la mise en cache des poids préparés sur le GPU. Elle a amélioré certains temps de calcul sur une seule ligne, mais ce microbenchmark ne générait pas de texte avec le modèle complet et ses poids en cache. L’accélération d’un noyau isolé ne peut pas être présentée comme un nouveau débit du modèle.
Ce que coûte une réponse
Au tarif GPU relevé de 1,45 $/heure, la génération longue a consommé environ 1,87 $ de temps d’exécution mesuré. Son débit de décodage correspondrait à environ 67 394 $ par million de tokens sortants, sans traitement initial de la requête ni préparation. En incluant la VM CPU séparée, la requête réseau courte a consommé environ 1,24 $ de temps d’exécution. Il s’agit de calculs selon le tarif, pas de factures ni de tests de capacité sur un million de tokens.
Le calcul estimé pour l’expérience chez Denvr, en incluant les tentatives échouées, le provisionnement et la durée de vie du contrôleur, s’élève à 7,75 $. Cette estimation repose sur les périodes d’allocation et les tarifs horaires; elle exclut le stockage, le réseau, les arrondis de facturation et les taxes. Nous n’avons pas consommé la totalité de la subvention. Les crédits ont permis de répondre à la question technique avant d’investir dans un système plus vaste.
Ce que cela implique pour l’inférence confidentielle de CARouter
Avec le moteur et la configuration testés, le seuil de performance interactive n’a pas été atteint. Ce résultat déconseille de bâtir aujourd’hui l’orchestration de production autour de cette implémentation; il ne prouve pas que tous les schémas homomorphes ou toutes les optimisations futures seront lents. Un autre moteur devra démontrer une vitesse utile, une qualité de réponse acceptable et une protection complète sur la charge de travail visée.
Le client séparé laisse aussi des hypothèses de confiance explicites. L’évaluateur voit les identifiants des experts sélectionnés, les dimensions des tenseurs et les durées. La VM CPU ordinaire suppose que son propre exploitant est digne de confiance. Nos requêtes synthétiques figuraient dans le code public des essais : l’expérience ne démontre donc pas que leur texte était inconnu de l’hôte GPU. Elle ne rend pas n’importe quelle machine communautaire sûre pour des requêtes clients.
Pour l’inférence native, une autre piste est le calcul confidentiel avec protection compatible du CPU et du GPU, attestation et remise des clés liée à la charge de travail vérifiée. Nous n’avons ni déployé ni mesuré cette architecture ici. Le nom d’un modèle de GPU ne suffit pas à établir ces protections. La confidentialité ne certifie pas non plus l’emplacement d’une machine et ne remplace pas les règles de résidence et de consentement aux fournisseurs de CARouter.
Un contrôleur CPU indépendant gérait les échéances des allocations et recueillait les résultats : une déconnexion du portable ne commandait donc pas la facturation GPU. Nous avons récupéré le code et les preuves, vérifié leurs empreintes et confirmé par l’API de Denvr la suppression de toutes les VM de l’expérience, y compris le contrôleur contenant les identifiants du compte. Les tenseurs de sortie sont conservés pour les vérifications futures, mais pas les poids des modèles ni les binaires compilés. Une suppression confirmée par API reste un constat opérationnel, pas une preuve d’effacement physique ni une protection contre un hôte ayant déjà vu des données en clair.
Où en est la technologie aujourd’hui
En septembre 2026, des systèmes de recherche s’attaquent aux caches KV chiffrés et à l’exécution hybride combinant chiffrement homomorphe et calcul confidentiel. Ce sont des pistes concrètes, mais les résultats dépendent de la taille du modèle, des hypothèses de confiance et de la nature des chiffres : génération réellement mesurée ou estimation à partir de composants. Nous n’avons pas reproduit ces systèmes; leurs vitesses annoncées ne valident donc pas notre charge de travail.
Face aux enjeux mondiaux de souveraineté, le chiffrement peut réduire la dépendance à la capacité ou à la volonté d’un exploitant distant de protéger les données en clair. Il n’établit pas à lui seul la souveraineté. La maîtrise des clés et du client de confiance, les lieux de calcul autorisés, l’exposition des métadonnées, l’intégrité du modèle et la continuité du service restent des exigences distinctes. Un calcul confidentiel à l’étranger ne respecte pas automatiquement la politique de résidence d’un client.
Face à la pénurie de GPU, la mesure pertinente est le nombre de réponses utiles par unité de calcul. Le chiffrement pourrait rendre utilisable un plus grand ensemble de machines jusque-là inadaptées, mais son surcoût doit rester inférieur à la capacité ainsi débloquée. Le moteur testé consomme beaucoup plus de temps de calcul par réponse. Ajouter des machines sans modifier cette implémentation séquentielle ne démontrerait pas une conversation individuelle plus rapide.
Notre constat : les briques cryptographiques existent, mais les preuves que nous avons examinées n’établissent pas encore un service généraliste d’inférence chiffrée de LLM modernes, économiquement utile sur des GPU communautaires quelconques. Pour l’immédiat, nous privilégions le calcul de confiance et l’évaluation séparée de déploiements confidentiels attestés. Nous réexaminerons l’inférence homomorphe communautaire lorsqu’un système complet démontrera le débit requis par requête, la qualité des réponses, la protection de l’état et des métadonnées, ainsi qu’un fonctionnement capable de reprendre après incident. Cela répondrait à une partie du problème de souveraineté; son intérêt face à la pénurie de GPU resterait à démontrer.
Obtenir les fichiers du benchmark
Ces conclusions décrivent nos expériences de septembre 2026. Nous conservons les mesures détaillées et les fichiers sources pour les travaux de suivi. L’essai H100 initial utilisait un autre modèle et un autre matériel; ces résultats ne comparent donc pas les générations de GPU.
Contactez-nous pour obtenir les données du benchmark et les fichiers sources.