Nemotron 3.5 Bolt E4B face à Qwen3.6 35B-A3B : banc d'essai sur un DGX Spark
Le nouveau Nemotron 3.5 Bolt E4B de NVIDIA est un petit modèle pour assistants vocaux : sur un DGX Spark à 4 bits, il pèse trois fois moins que le Qwen3.6 35B-A3B que nous servons. Il appelle les outils aussi bien et commence plus tôt la réponse d'un assistant, mais n'écrit pas plus vite pour une requête sans son modèle brouillon, et ne répond juste qu'à 56 % des questions scientifiques, contre 83 %.
NVIDIA a publié Nemotron 3.5 Bolt E4B le 23 octobre. C'est le Gemma 4 E4B de Google, entraîné plus avant par NVIDIA pour les assistants vocaux, les personnages interactifs et les appareils qui doivent répondre vite.
NVIDIA le publie à 4 bits, sous la forme d'un fichier de 5.8 Gio pour llama.cpp, le moteur qui sert à faire tourner un modèle sur son propre ordinateur. Nous l'avons comparé à Qwen3.6 35B-A3B, le modèle derrière le point d'accès de programmation de CARouter Cloud, sur la puce du NVIDIA DGX Spark. C'est aussi celle de notre propre serveur.
Le dernier modèle testé de cette façon : LFM2.5 24B-A2B face à Qwen3.6 35B-A3B.
En bref
- Taille. À 4 bits, Bolt pèse 5.8 Gio, contre 19.0 Gio pour Qwen dans le même format.
- Vitesse pour une requête. Ici, petit ne veut pas dire rapide. Sur llama.cpp, Bolt écrit 57 tokens par seconde et Qwen 65. Avec le modèle brouillon fourni par NVIDIA, Bolt atteint 135, le meilleur résultat de tout ce que nous avons mesuré.
- Vitesse à plusieurs. Avec seize requêtes à la fois, Bolt totalise 445 tokens par seconde sur llama.cpp, contre 229 pour Qwen. Son modèle brouillon coûte alors plus qu'il ne rapporte : 107.
- La réponse d'un assistant. Avec le raisonnement activé, Bolt commence sa réponse au bout de 1.5 seconde, ou de 0.8 avec son brouillon, contre 1.9 pour Qwen tel que nous le servons. Sans raisonnement, les deux commencent en moins d'un quart de seconde.
- Qualité. Bolt appelle les outils aussi bien que Qwen, 84 % contre 81 %, et suit les consignes aussi bien, 91 % contre 89 %. Il répond juste à bien moins de questions scientifiques, 56 % contre 83 %, et programme un peu moins bien.
- Notre décision. CARouter Cloud garde Qwen3.6 35B-A3B pour la programmation et les agents. Bolt est candidat à un autre rôle : un petit modèle rapide pour les assistants.
Petit, mais pas léger à chaque token
Bolt compte 8 milliards de paramètres, dont environ 4 milliards travaillent sur chaque token. NVIDIA parle de 4 milliards effectifs. Qwen3.6 35B-A3B en compte 35 milliards, mais seuls 3 milliards environ travaillent sur chaque token.
Sur le GB10, écrire un token, c'est lire en mémoire les paramètres qui y travaillent. Bolt en lit plus que Qwen à chaque token : il n'est donc pas plus rapide pour une requête. En revanche, il occupe bien moins de mémoire. Avec seize conversations ouvertes sur llama.cpp, Bolt occupait 7.9 Gio et Qwen 25.0 Gio.
Vitesse
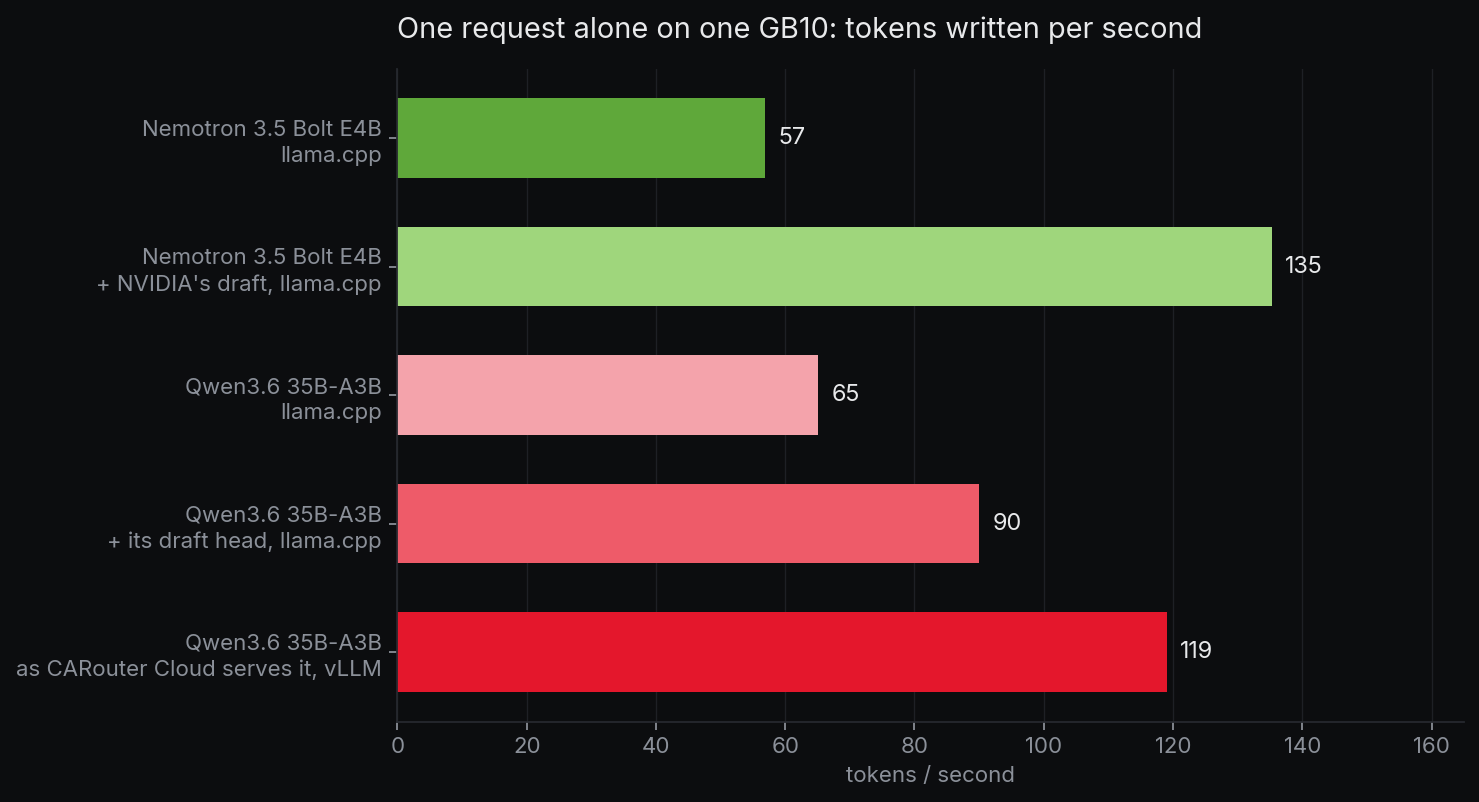
Un modèle brouillon est un petit modèle qui devine les quelques tokens suivants. Le modèle principal les vérifie ensuite d'un seul coup. NVIDIA en fournit un pour Bolt, et Qwen3.6 a le sien intégré. Avec son brouillon, Bolt est la configuration la plus rapide que nous ayons mesurée pour une requête seule.
Le gain dépend du texte. Sur notre requête de programmation, le brouillon a plus que doublé la vitesse de Bolt. Sur une courte histoire, il a beaucoup moins apporté : 67 tokens par seconde contre 59, car la prose se devine moins bien.
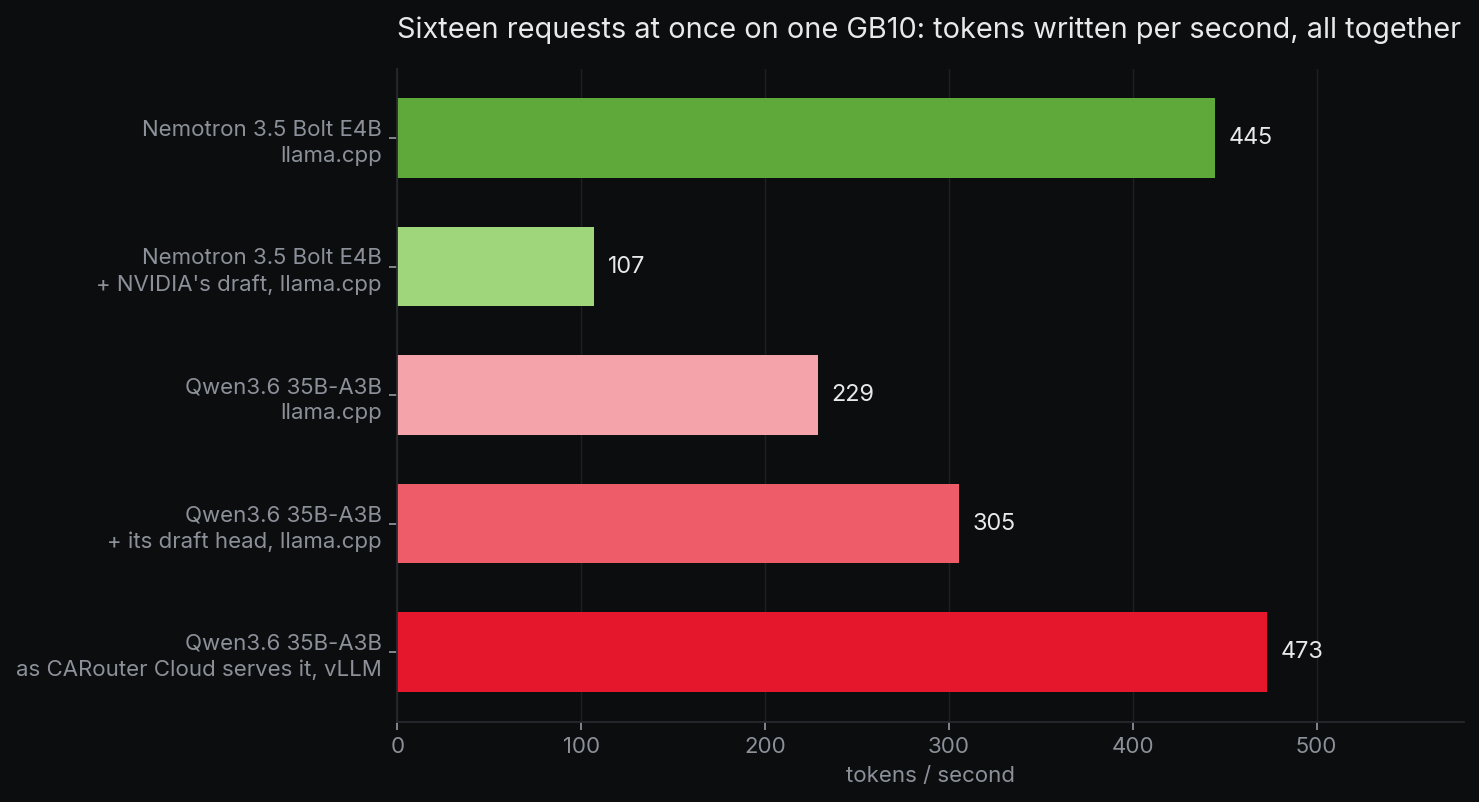
À plusieurs, le tableau change. Sans brouillon, Bolt totalise 445 tokens par seconde avec seize requêtes à la fois, presque deux fois Qwen sur le même moteur.
Avec son brouillon, il tombe à 107. Le brouillon de Bolt ne rapporte que pour une requête seule, et l'exemple de NVIDIA lui-même ne sert qu'une requête à la fois. La tête de brouillon de Qwen, elle, aide encore avec seize requêtes : 305 contre 229.
Bolt lit aussi vite une requête : environ 5 000 tokens par seconde sur llama.cpp, contre 2 900 pour Qwen sur le même moteur et 6 500 sur vLLM.
Un assistant vocal
Bolt est fait pour les assistants, alors nous en avons écrit un : le haut-parleur de cuisine d'une famille d'Ottawa, avec quatre outils pour la météo, une minuterie, les lumières et la liste d'épicerie. Une personne lui a demandé douze choses, l'une après l'autre, dont la moitié exigeait un outil.
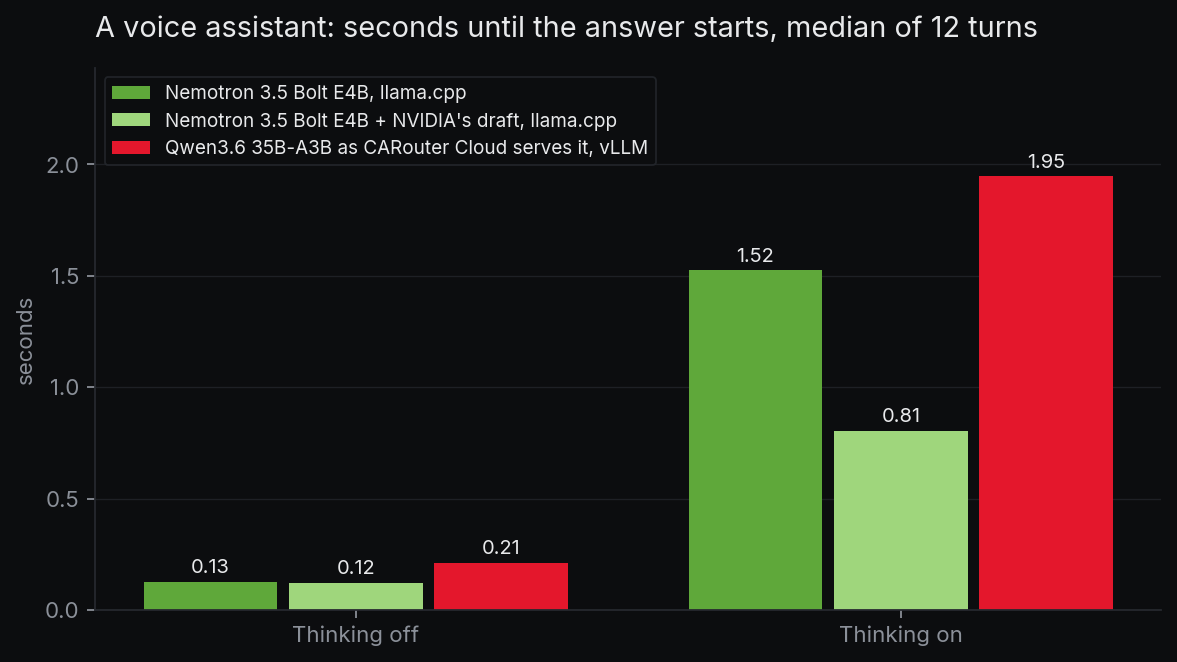
Les deux modèles ont choisi le bon outil, ou aucun, aux douze tours, avec et sans raisonnement. Sans raisonnement, les deux commencent à répondre en moins d'un quart de seconde : aucun auditeur ne le remarquerait.
Avec raisonnement, Bolt écrit environ 100 tokens par tour, raisonnement compris, là où Qwen en écrit environ 215. Sa réponse commence au bout de 1.5 seconde, ou de 0.8 avec son brouillon. Celle de Qwen, tel que nous le servons, commence au bout de 1.9 seconde.
Qualité
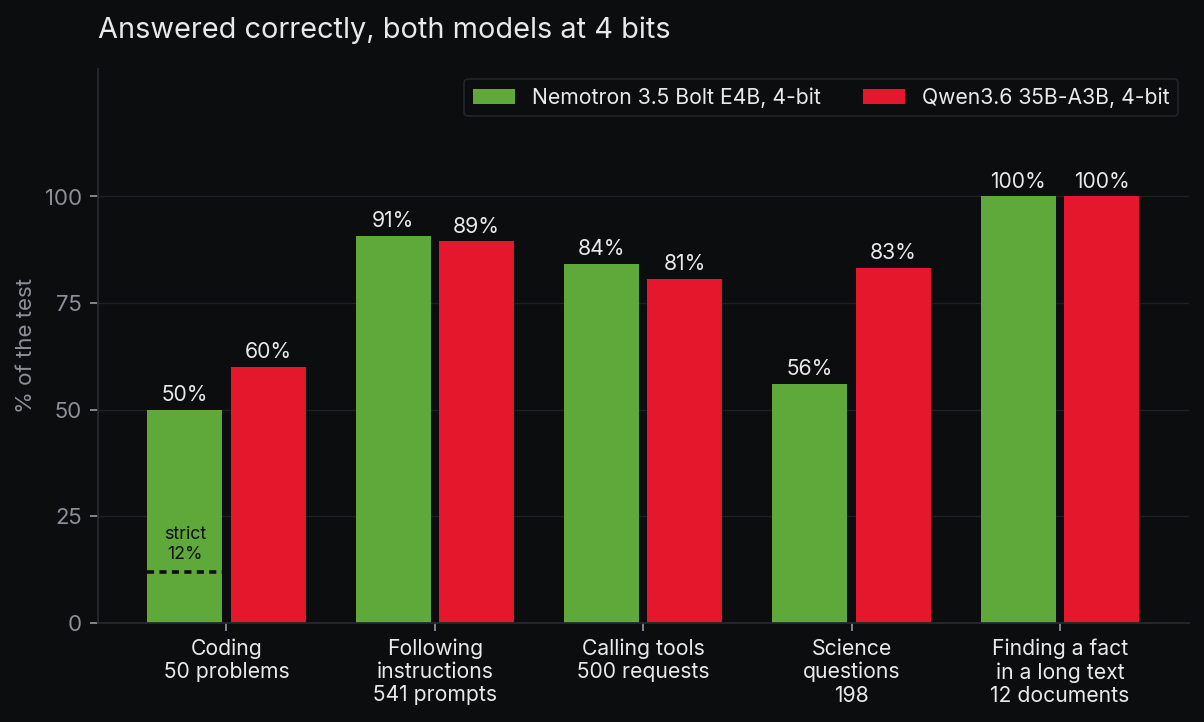
Sur 500 requêtes du banc d'essai d'appel de fonctions de Berkeley, Bolt en a réussi 84 % et Qwen 81 %. L'écart vient des requêtes auxquelles aucun outil ne convient : Bolt s'est abstenu, à raison, 154 fois sur 160, et Qwen 135 fois. Sans raisonnement, Bolt atteint encore 82 %, en écrivant quatre fois moins de tokens.
IFEval propose 541 requêtes dont les consignes peuvent être vérifiées par un programme, comme un nombre de mots ou un format imposé. Bolt a suivi toutes les consignes de 91 % d'entre elles et Qwen de 89 %, un écart que le hasard suffit à expliquer, et Bolt a écrit six fois moins de tokens. Sans raisonnement, il descend à 87 %.
C'est sur les connaissances que la taille se voit. Sur 198 questions scientifiques de niveau universitaire avancé (GPQA Diamond), Bolt a répondu juste à 56 % et Qwen à 83 %.
La programmation demande une mise en garde. Avec raisonnement, Bolt omet le plus souvent la ligne qui ouvre un bloc de code, mais garde celle qui le ferme. Un test strict exécute cette ligne orpheline comme du code et échoue : seuls 6 de nos 50 problèmes BigCodeBench passent.
Une fois cette seule ligne retirée, Bolt résout 25 des 50 problèmes, contre 30 pour Qwen. Tout programme qui extrait le code des réponses de Bolt doit s'attendre à la ligne manquante.
Nous avons aussi caché une phrase dans des documents de 16 000 à 52 000 tokens, puis nous l'avons redemandée. Les deux modèles l'ont retrouvée 12 fois sur 12. On ne peut pas interroger Bolt sur des documents plus longs : sa fenêtre s'arrête à 65 536 tokens, contre 262 144 pour Qwen.
Ce que nous ne pouvons pas vous dire
- Comment Bolt tient une longue conversation ou un personnage. C'est là que NVIDIA annonce ses meilleurs résultats, et nous n'avons testé que des requêtes isolées.
- Sa vitesse sur vLLM, le moteur avec lequel CARouter Cloud sert ses modèles. NVIDIA ne publie sa version à 4 bits que pour llama.cpp.
- Ce qu'il donne en français ou dans les autres langues de son entraînement. Nous n'avons testé que l'anglais.
- Si un écart de quelques points sur nos plus petits tests est réel. Cinquante problèmes de programmation ne suffisent pas à classer deux modèles aussi proches.
Ce que cela change pour CARouter
CARouter Cloud garde Qwen3.6 35B-A3B pour la programmation et les agents. Bolt lit quatre fois moins de contexte, répond juste à bien moins de questions de connaissances, et n'écrit pas plus vite pour une requête sans son brouillon.
Bolt reste le premier petit modèle que nous ayons mesuré qui appelle les outils et suit les consignes aussi bien que Qwen, avec trois fois moins de mémoire et sous une licence permissive. Il est donc candidat au rôle de modèle rapide pour les assistants, à côté de Qwen plutôt qu'à sa place.