Laguna S 2.1 contre Qwen3.8-27B sur le DGX Spark de CARouter : la vitesse a perdu contre la mémoire
Laguna S 2.1 de Poolside décode deux fois et demie plus vite que Qwen3.8-27B sur notre DGX Spark de 128 Go. Nous avons quand même mis Qwen en service : il tient dans un tiers de la mémoire, et ce qu'il laisse libre accueille quatre sessions de codage à 262K de contexte là où Laguna en tient une. Une fin de semaine de mesures, avec les graphiques, les erreurs et la configuration qui l'a emporté.
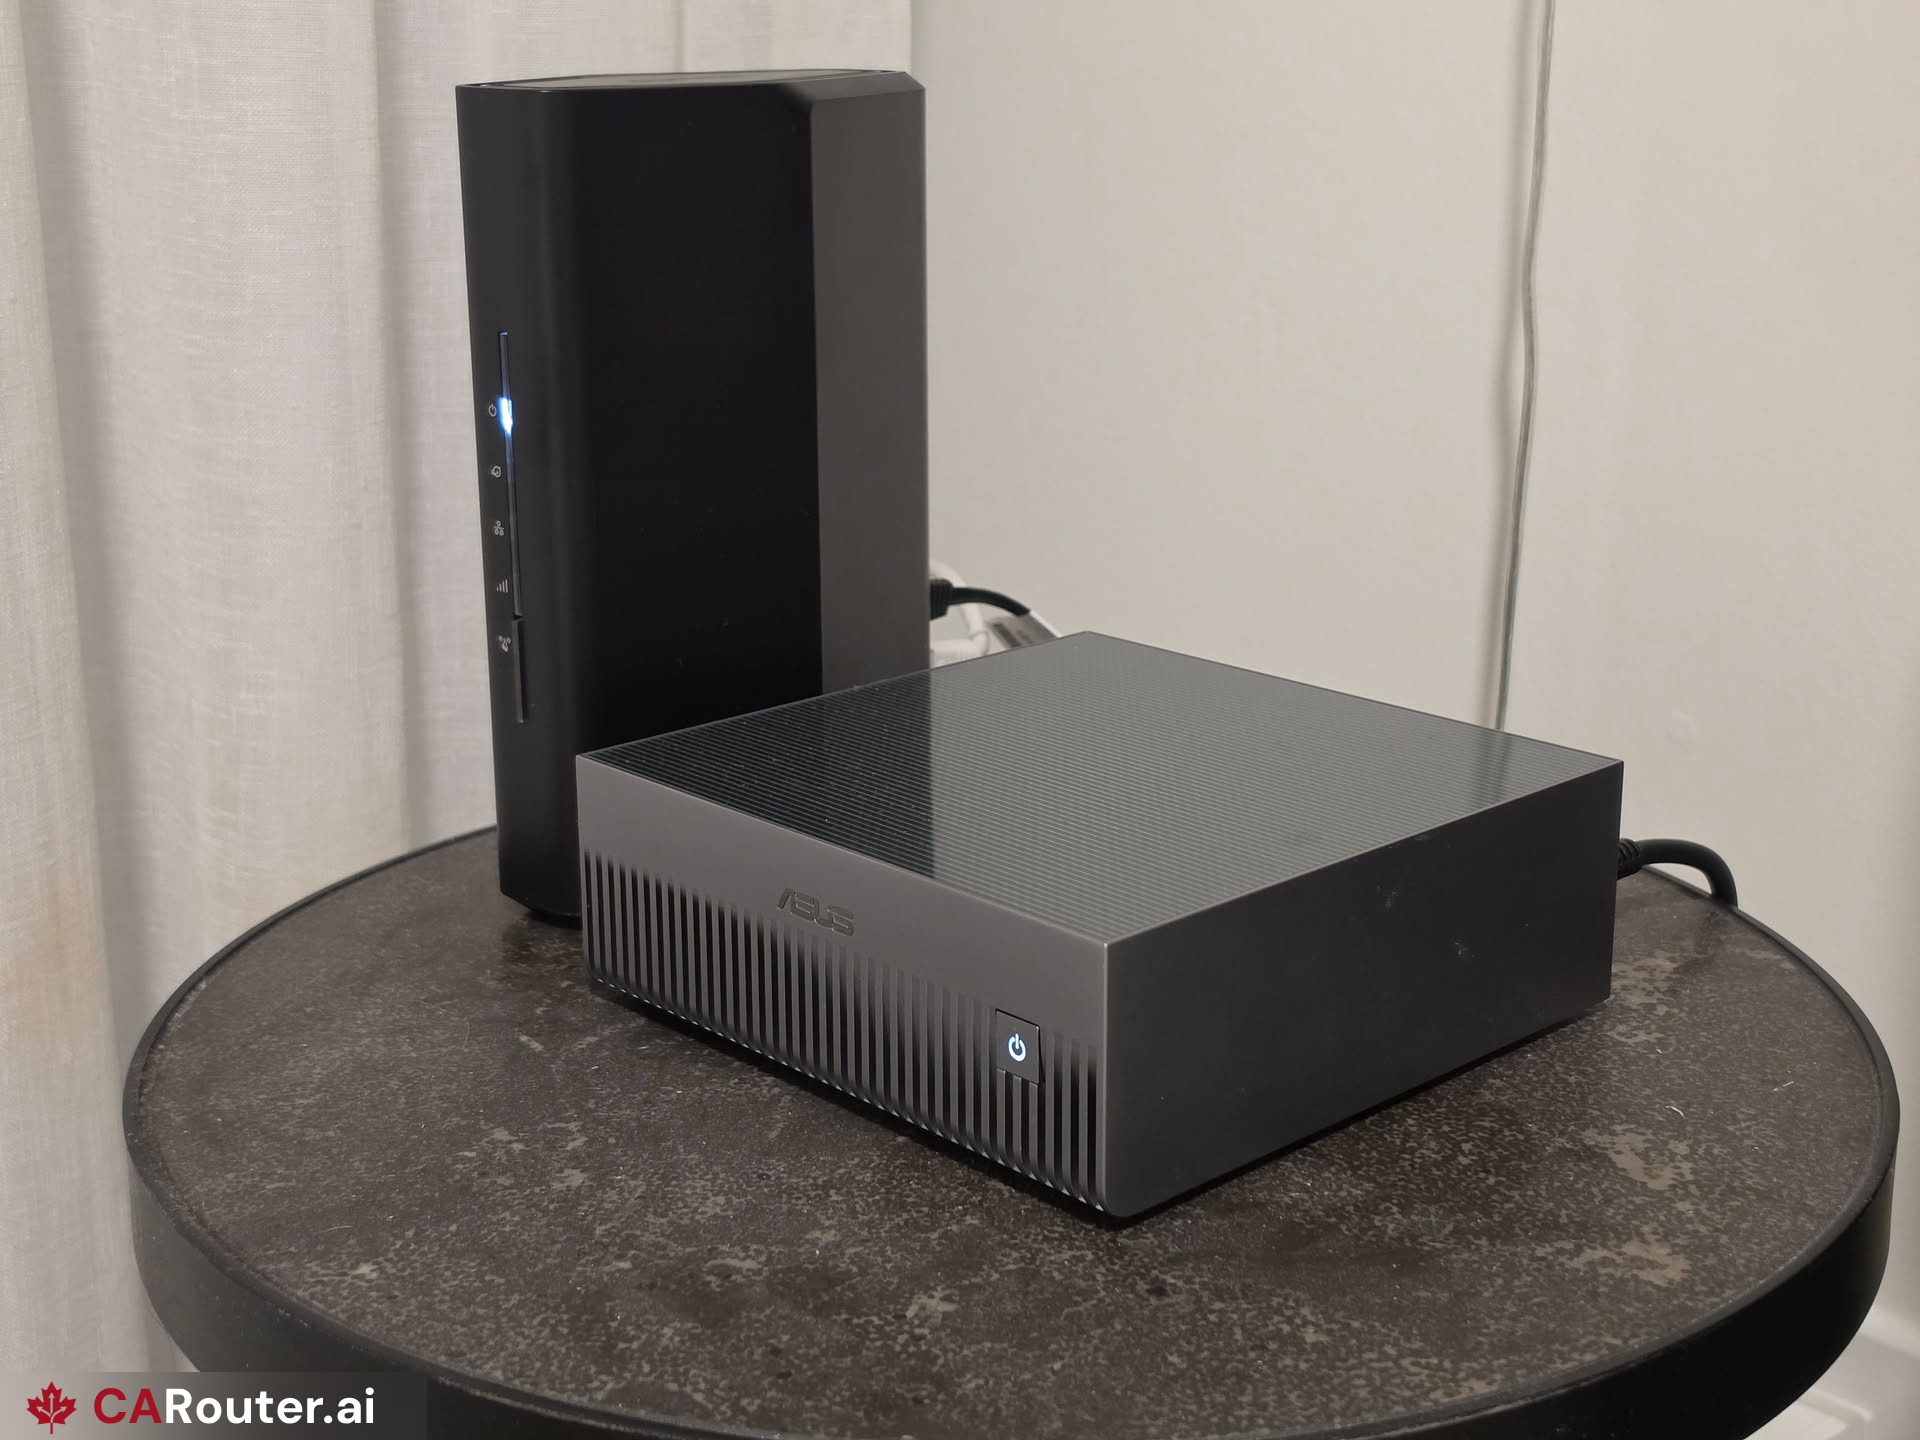
CARouter achemine les requêtes d'IA vers des fournisseurs qui servent depuis le Canada, et CARouter Cloud est la partie que nous hébergeons nous-mêmes : un ASUS Ascent GX10 (une machine de classe NVIDIA GB10 « DGX Spark », 128 Go de mémoire unifiée, arm64) qui fait tourner vLLM derrière un proxy TLS, rattaché à notre grappe Kubernetes comme capacité. Il sert deux modèles de plongements et un modèle de codage. Voici l'histoire du choix du modèle de codage, racontée avec les chiffres, parce que le chiffre qui a tranché n'est pas celui que nous attendions.
En bref
- Vitesse. Sur notre sonde de génération de code, Laguna décode à 46,5 tokens/s en flux unique et à 176 en agrégé à huit flux; Qwen, à 18,3 et 122. Laguna mène à chaque niveau de simultanéité que nous avons essayé.
- Traces de raisonnement. Sur le texte qu'un agent de codage produit réellement, les deux sont à égalité par flux : environ 17 tokens/s contre 14.
- Mémoire. Qwen, à 44 Gio résidents, laisse 62 Gio libres; Laguna, à 98 Gio, en laisse 8. Cela fait 3,9 requêtes simultanées de 262K tokens contre 1,2, et c'est le chiffre qui a tranché.
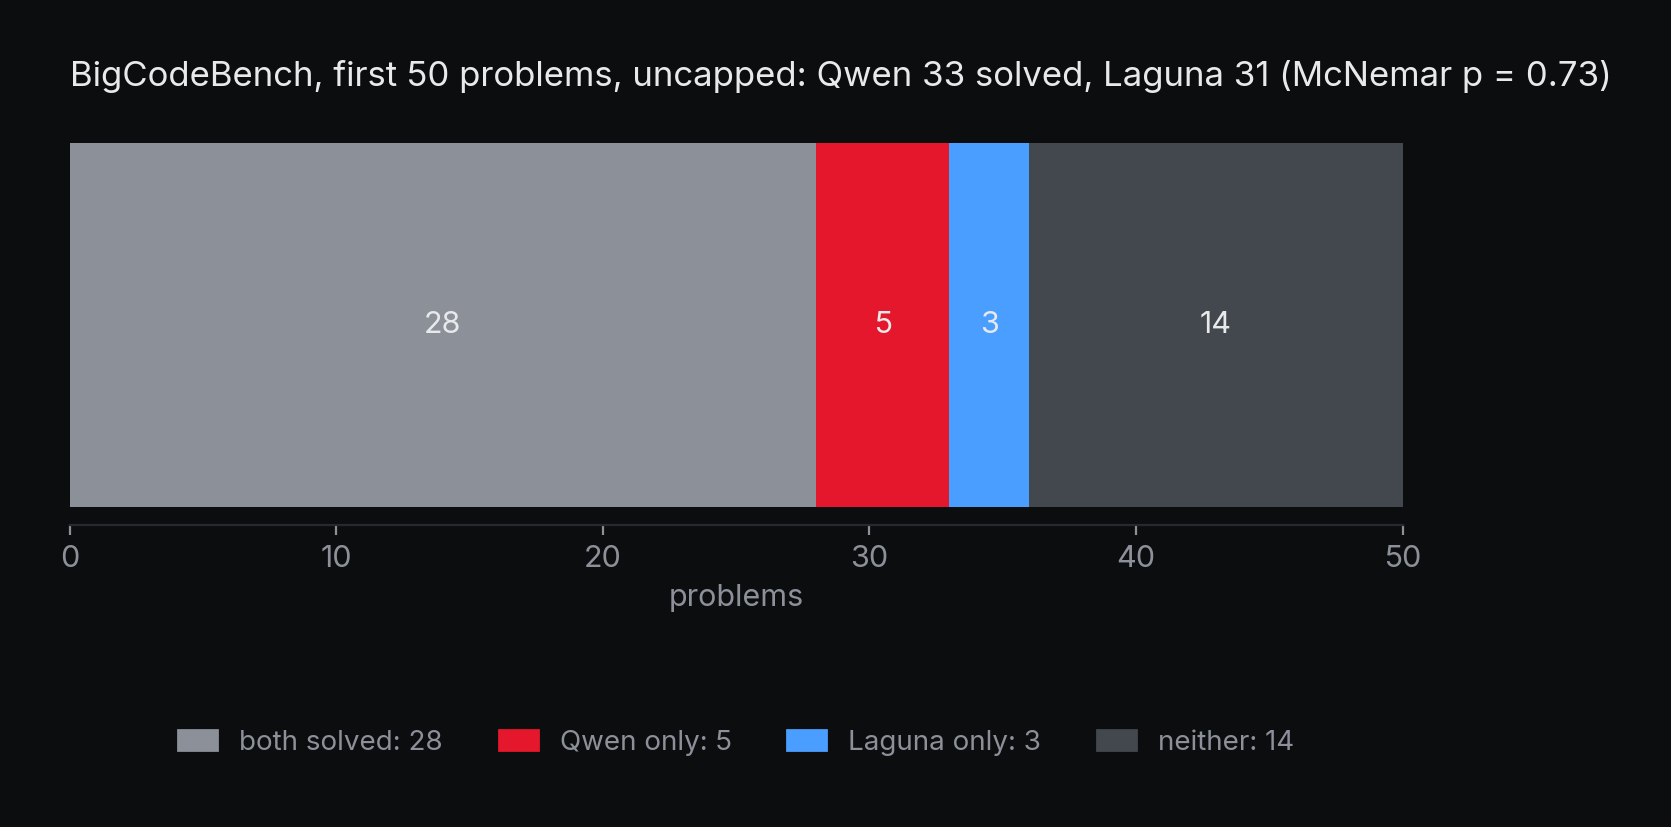
- Qualité. 33 contre 31 sur les 50 premiers problèmes de BigCodeBench, p = 0,73 au test de McNemar. Pas d'écart.
- En service. Qwen3.8-27B dans une quantification NVFP4 communautaire, profondeur MTP 3, 36 Gio de KV. Laguna reste à une variable d'environnement de distance.
Les deux candidats
Poolside Laguna S 2.1 était le tenant du titre : un mélange d'experts de 117B avec 8,5B de paramètres actifs, servi depuis le checkpoint NVFP4 de Poolside avec leur brouillon de décodage spéculatif DFlash. C'est un très bon modèle de codage, et c'est un gouffre à mémoire : ~98 Gio résidents à 262K de contexte, ce qui, sur une machine de 121,6 Gio, laisse la place aux deux modèles de plongements et à rien d'autre.
Qwen3.8-27B était le prétendant : un modèle dense de 27B, 64 couches dont 48 en Gated DeltaNet (attention linéaire) et 16 en attention complète, 262K de contexte natif, une tour de vision, et une tête de prédiction multi-tokens (MTP) entraînée dans le checkpoint. La fiche de Qwen le place près de la frontière en codage agentique (SWE-bench Pro 61,7, Terminal Bench 2.1 73,0).
L'attente naïve, que nous avions notée avant de mesurer : le 27B dense serait beaucoup plus lent. Un GB10 offre environ 273 Go/s de bande passante mémoire, le décodage est borné par la bande passante, et un 27B dense en FP8 lit ~27 Go de poids par token là où le MoE de Laguna en lit ~4 Go. Le modèle de performance roofline disait 10 tokens/s contre 60. Sur une simple invite de code, l'arithmétique a tenu : Laguna est deux fois et demie plus rapide en flux unique et devant à chaque taille de lot que nous avons essayée. Ce que l'arithmétique a manqué, c'est la charge de travail qu'un agent de codage envoie réellement, et la mémoire que le plus petit modèle laisse derrière lui - c'est là que va le reste de cet article, et de là que vient la décision.
Ce que nous avons mesuré, et comment
Chaque chiffre de débit ici vient d'une seule sonde, le script de banc d'essai de notre dépôt d'infrastructure : N requêtes de génération de code simultanées à travers le proxy de production, le taux de décodage lu dans les compteurs de tokens de vLLM lui-même sur une fenêtre de 40 secondes, puis un nouveau préremplissage de 12K tokens. Même sonde, même machine, même jour pour les deux modèles, pour que les colonnes s'alignent. Quand un chiffre vient plutôt de l'évaluation - le taux de décodage sur de longues traces de raisonnement, lu dans les mêmes compteurs pendant que BigCodeBench tournait - c'est indiqué, parce que les deux charges de travail ne donnent pas la même réponse. La qualité du code, c'est BigCodeBench, les 50 premiers problèmes, tokens sortants sans plafond, notés dans un bac à sable - les mêmes 50 problèmes pour les deux, pour que les deux passes s'apparient.
Constat 1 : le décodage spéculatif vaut 5 tokens par pas sur du code facile et 1,5 sur du raisonnement
Le brouillon DFlash de Laguna propose 7 tokens par pas. Sur notre sonde de génération de code, il en place 58 % - 5,1 tokens par pas - et Laguna décode à 46,5 tokens/s en flux unique. Sur les longues traces de raisonnement qu'un agent de codage produit réellement (sa passe BigCodeBench, lue dans les mêmes compteurs), l'acceptation tombe à 21 %, 1,48 token par pas, et le débit par flux à environ 17. L'unique couche MTP de Qwen, rejouée trois fois, en accepte environ la moitié à chaque position sur l'une ou l'autre charge : 2,5 tokens par pas, 18,3 tokens/s en flux unique sur la sonde et environ 14 par flux avec huit requêtes d'évaluation en vol. La spéculation de Laguna est spectaculaire quand le texte est prévisible et ordinaire quand il ne l'est pas; celle de Qwen est stable, et il partait quand même plus lent, parce que son pas de base lit 27 Go.
Le levier pour Qwen, c'était donc le checkpoint. Nous avons remplacé les poids FP8 officiels de Qwen par une quantification NVFP4 communautaire (celle d'unsloth : MLP en 4 bits, projections d'attention en FP8, échelles de KV et tête MTP comprises). vLLM l'a placée sur le noyau CUTLASS NVFP4 de FlashInfer - la même famille de noyaux qui rend Laguna rapide sur ce silicium - et le temps de pas est passé de 185 ms à 130 ms, plus que ne le prédit le seul rapport d'octets.
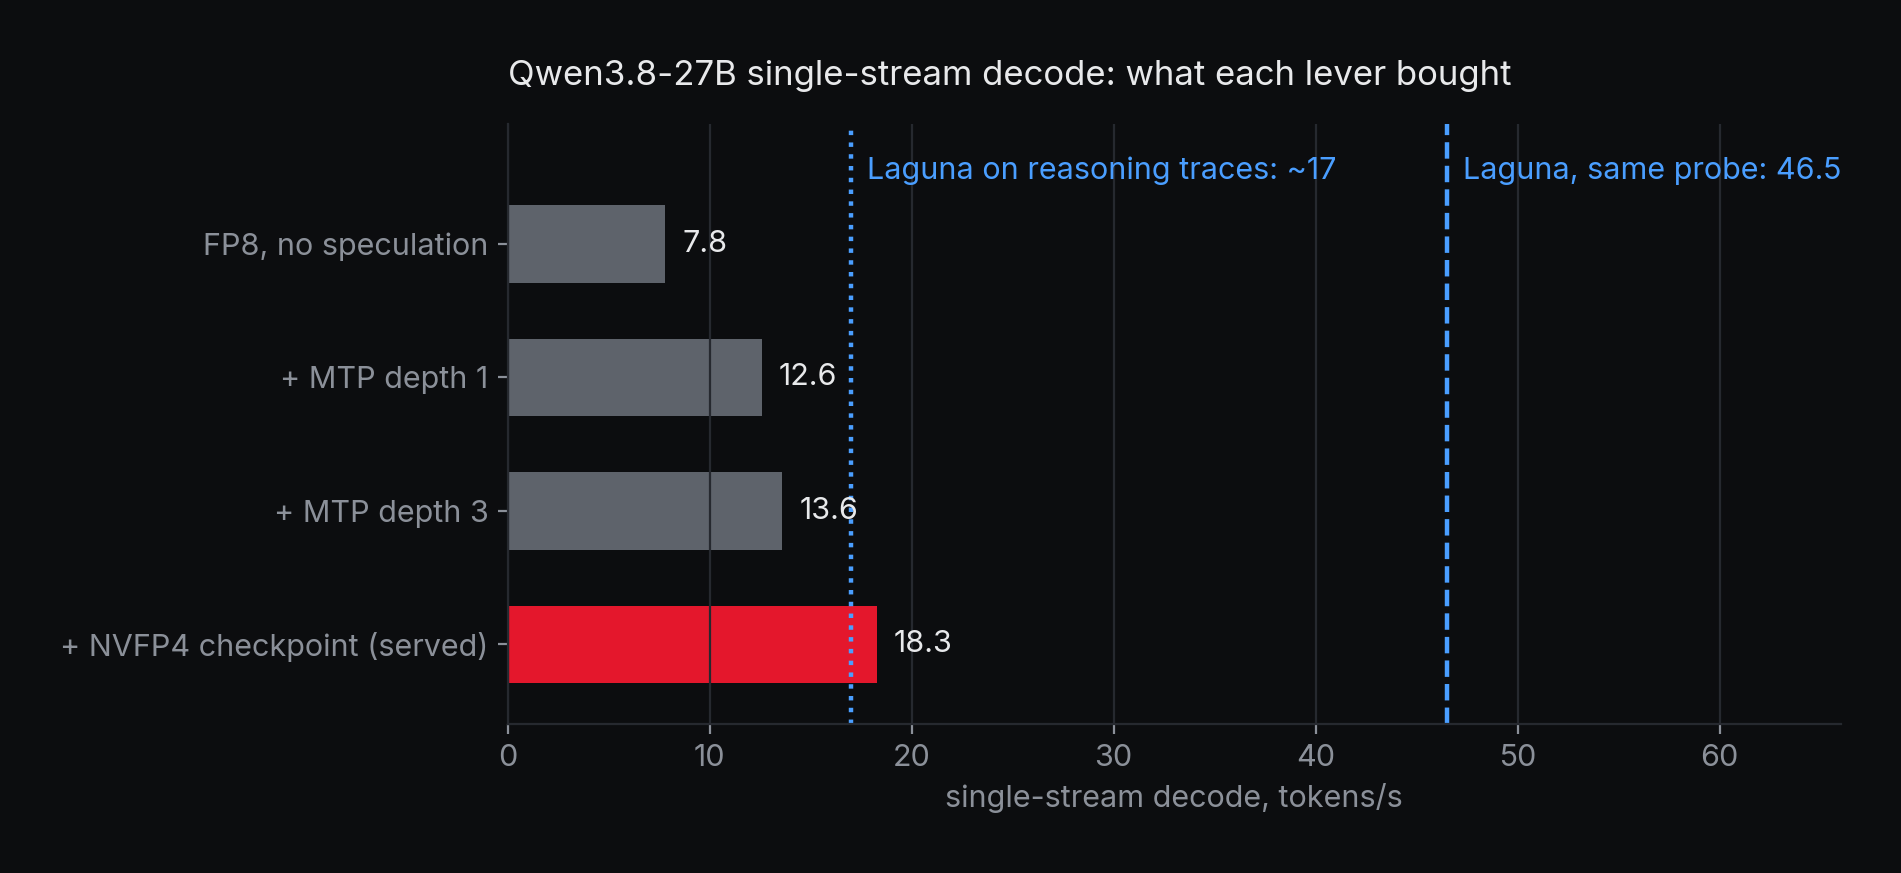
Douze configurations plus tard, celle qui est en service est NVFP4 à une profondeur MTP de 3. La profondeur 4 égalait la 3 en flux unique, puis a fait planter vLLM sur un accès mémoire illégal à quatre séquences simultanées, le genre de chose qu'on n'apprend qu'en l'exécutant. Des blocs de préremplissage plus gros ont ralenti le préremplissage d'un tiers. La précision du cache KV s'est révélée être une décision de calibration, pas de vitesse.
Constat 2 : Laguna est plus rapide sur les tâches simples, à égalité sur les tâches complexes
Un point d'accès de codage derrière une plateforme de routage ne traite jamais une requête à la fois, alors nous avons mesuré les deux modèles à 1, 2, 4 et 8 flux simultanés, même sonde, même jour.
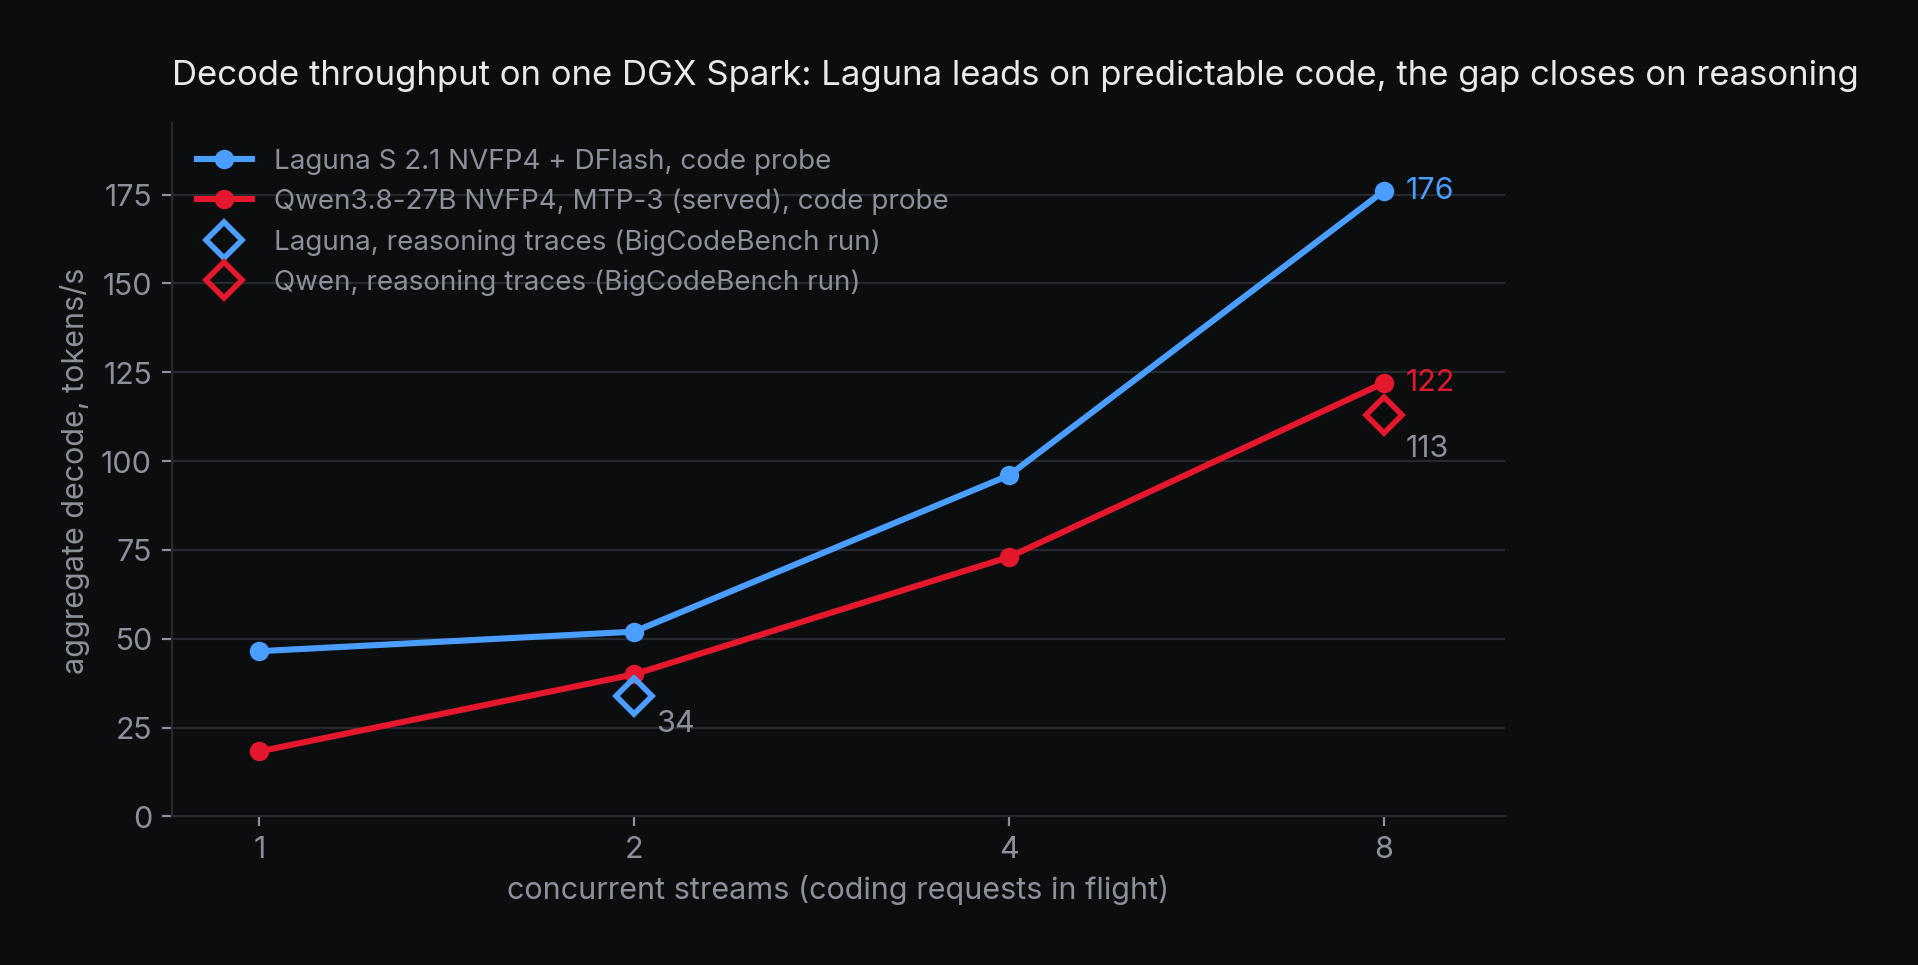
Laguna mène à chaque compte : 46,5, 52, 96 et 176 tokens/s en agrégé contre 18,3, 40, 73 et 122 pour Qwen. La courbe de Qwen est la plus droite - à 5 % du linéaire jusqu'à huit flux, parce qu'un modèle dense paie sa lecture de poids une fois par pas quel que soit le lot, et que 32 tokens par pas est très loin de saturer le calcul d'un 27B. Celle de Laguna s'aplatit entre un et deux flux, où l'acceptation de son brouillon fléchit, puis grimpe de 3,8x à huit. Le croisement que nous attendions, où le traitement par lots éroderait l'avantage des paramètres actifs du MoE, n'est pas là à huit flux sur cette machine.
Ce qui resserre l'écart, c'est la charge de travail. Sur les traces de raisonnement, lues dans les mêmes compteurs pendant les passes BigCodeBench, Laguna fait environ 17 tokens/s par flux à deux flux et Qwen environ 14 par flux à huit (113 en agrégé); Laguna au-delà de deux flux sur cette charge est la seule case que nous n'avons pas mesurée. Par flux, sur le texte que les agents produisent réellement, les deux sont à égalité; sur du code que Laguna peut prédire, il est loin devant. Le préremplissage appartient à Laguna à toutes les longueurs : 3 550 tokens/s contre 2 088 sur une invite de 12K, 2 836 à 55K et 1 634 à 200K.
Constat 3 : 62 Gio libres, c'est quatre sessions à 262K au lieu d'une
C'est ce chiffre qui a tranché. Nous voulions 262K de contexte et plusieurs clients de codage actifs simultanément. Le contexte occupe le cache KV, qui doit tenir dans la mémoire laissée libre par les poids.
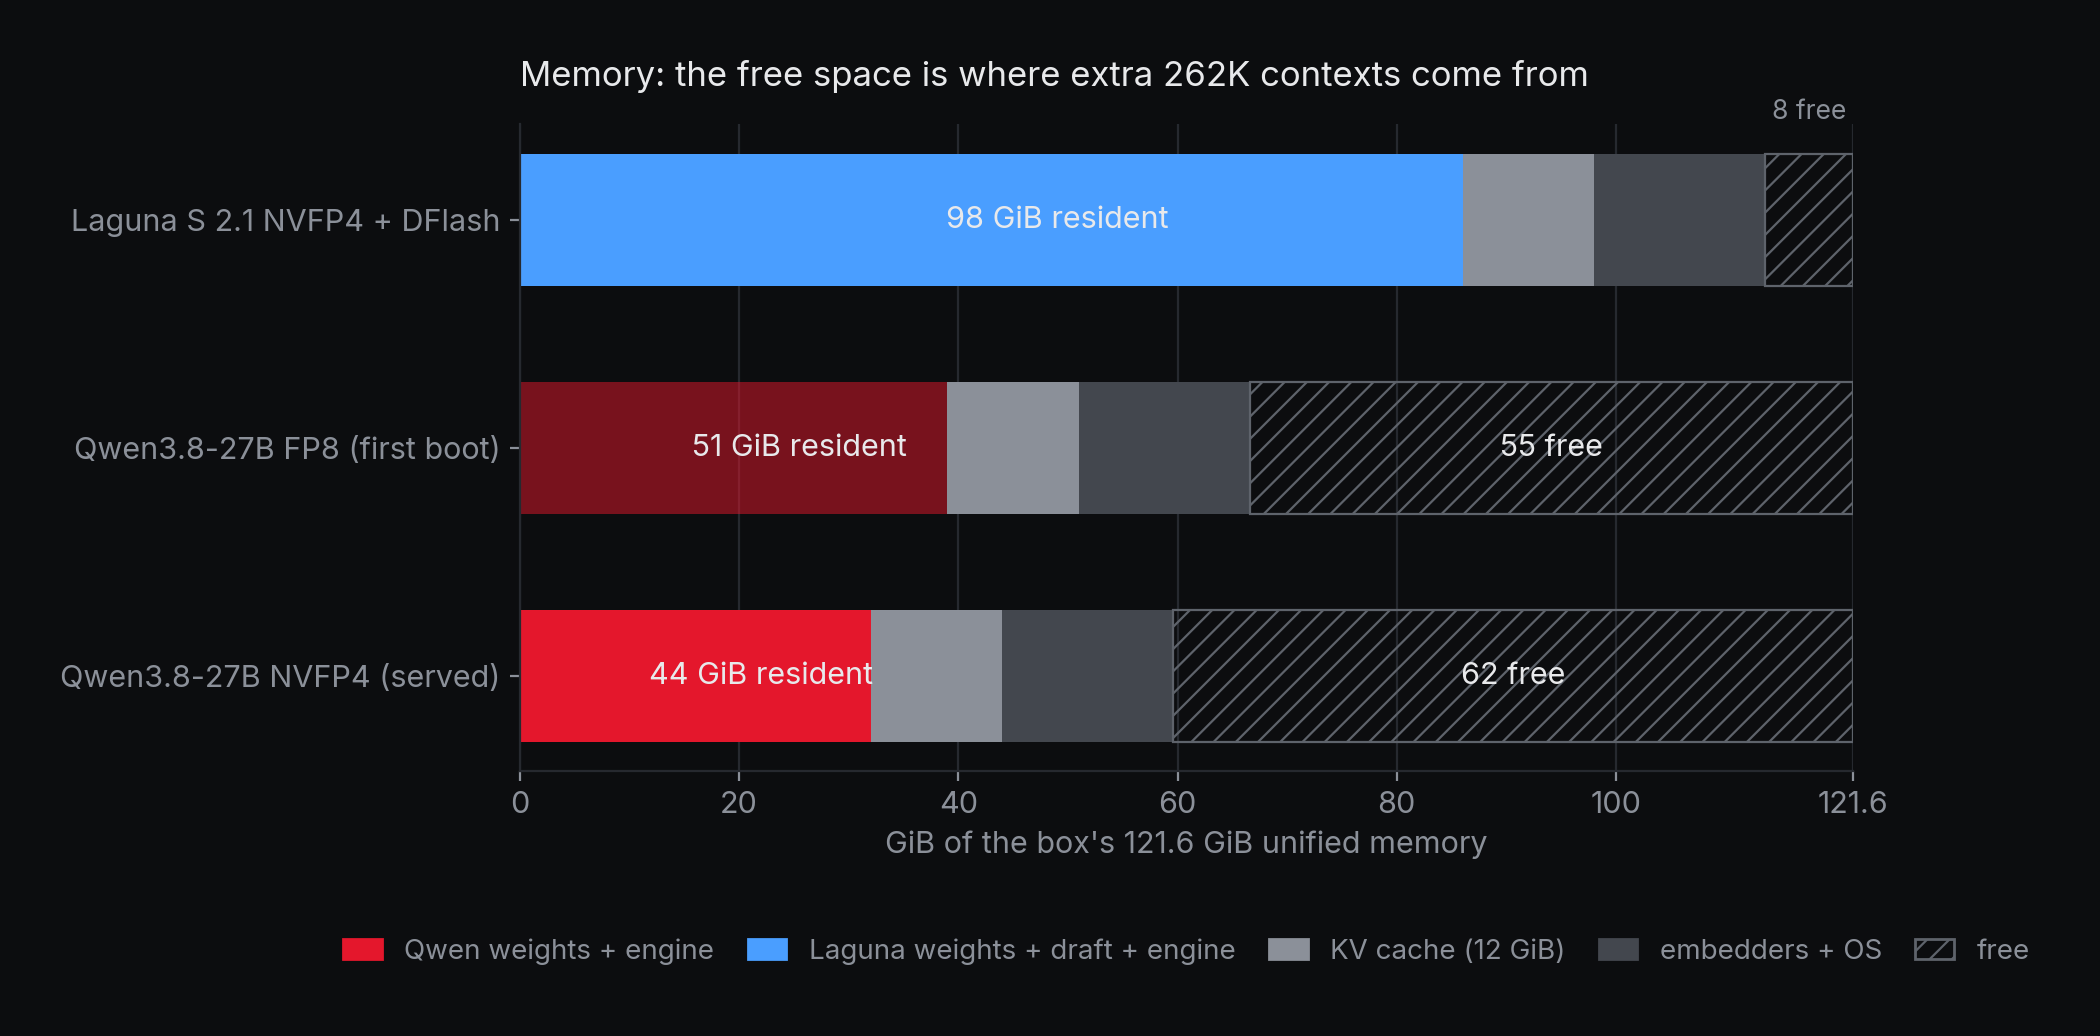
Laguna, à 98 Gio résidents, laisse 8 Gio libres après les modèles de plongements. Son budget KV de 12 Gio tient 1,2 requête à contexte plein, et il n'y a nulle part où l'agrandir. Qwen, à 44 Gio, laisse 62 Gio libres. Son KV par token est en fait plus cher que celui de Laguna (32 Kio contre 24, parce que ses 16 couches d'attention utilisent des têtes de largeur 256), mais il peut se permettre un budget trois fois plus grand, avec de la place pour quatre.
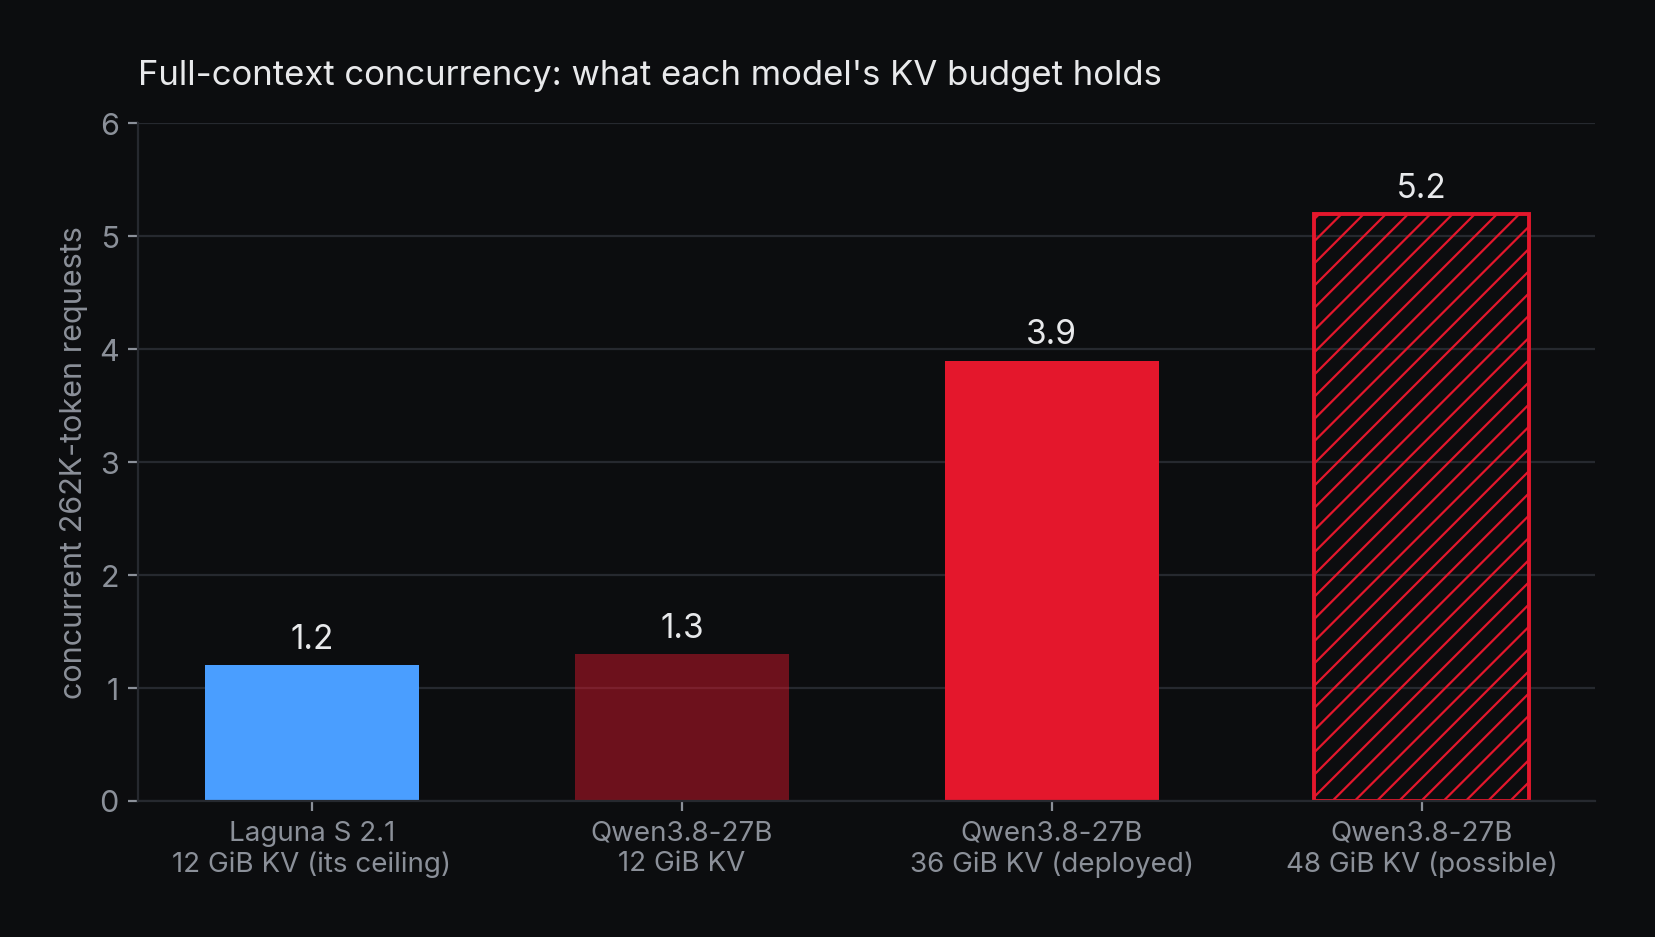
Avec les 36 Gio de KV que nous avons déployés, Qwen tient près de quatre requêtes simultanées de 262K tokens (3,9 : 1 014 892 tokens en cache, mesurés); à 48, il en tiendrait cinq. Laguna en tient une, avec une deuxième en attente. Pour une plateforme dont les cas d'usage en codage sont des agents qui lisent des dépôts entiers, ce n'est pas un détail de débit; c'est le produit.
Constat 4 : une qualité comparable, comme nous l'espérions
Sur les 50 premiers problèmes de BigCodeBench - sortie sans plafond, notée dans le même bac à sable, les mêmes 50 pour les deux - Qwen en résout 33 et Laguna 31. Appariés problème par problème, les deux s'accordent sur 42 d'entre eux : 28 résolus par les deux, 14 ratés par les deux. Qwen seul en résout cinq, Laguna seul trois, et un test de McNemar exact sur ces huit problèmes discordants donne p = 0,73. Ce n'est pas un classement, et ça n'allait jamais en être un à n = 50; c'est l'absence d'écart, qui est le résultat dont le constat sur la mémoire avait besoin pour signifier quelque chose. Ce qui a différé, c'est le temps que Qwen passe à réfléchir. Il a produit 462K tokens sortants pour l'ensemble contre 264K pour Laguna, et dix de ses échantillons ont dépassé 16K tokens là où Laguna n'a jamais franchi 11K - des traces de raisonnement de 20 à 31K tokens sur les problèmes les plus durs, aucune n'atteignant le plafond de 32K. Ces échantillons sont aussi ce qui nous a fait trouver deux délais d'expiration de dix minutes, un dans le proxy et un dans l'outil d'évaluation, qui coupaient silencieusement les longues générations et les relançaient; les deux sont à 7 200 s maintenant, et chaque chiffre de cet article a été mesuré après le correctif.
Le repérage en long contexte a tenu aussi. Sur la même grille d'aiguille dans une botte de foin qui avait validé les 256K de Laguna (quatre longueurs de contexte de 32K à 220K, trois positions d'aiguille), Qwen obtient 9,0/10 au total - parfait à 95K, 9,0 à 157K, et 8,0 à 220K là où Laguna tenait un 10 parfait. C'est au fond de la fenêtre que le tenant du titre garde une petite avance; tout ce qui est en deçà est un match nul.
Ce que nous avons déployé
Qwen3.8-27B, NVFP4, profondeur MTP 3, 262K de contexte, 36 Gio de KV, images activées, derrière le même proxy sous le même nom servi. Laguna reste sur le disque et dans le dépôt, à une variable d'environnement près, parce qu'une décision prise sur n=50 et une fin de semaine doit rester réversible.
Les réserves honnêtes :
- La version NVFP4 est une quantification communautaire, pas celle de Qwen.
- 50 problèmes, c'est un signal, pas un classement.
- Le décodage de Laguna sur des traces de raisonnement n'a été mesuré qu'à deux flux, si bien que son chiffre à huit flux sur cette charge est une inférence, pas une mesure.
- La comparaison de débit s'est inversée sur le tard : tant que Laguna n'était pas passé par la même sonde, nous mettions son taux d'évaluation en face du taux de sonde de Qwen et déclarions Qwen 3,6x plus rapide à huit flux, ce qu'il n'est pas. La décision tient sur les trois autres constats.
- Tout ici est une seule machine, donc les courbes de lot sont une propriété du dense contre le MoE sur mémoire unifiée, pas une loi universelle.
Ce qu'un deuxième DGX Spark changerait
La question évidente après une fin de semaine comme celle-là, c'est si un deuxième GB10 - deux DGX Spark, reliés par leurs ports ConnectX-7 à 200 Gb/s, la configuration que NVIDIA vend pour les modèles de classe 405B - aurait changé la décision. Il aurait changé les options plus que la réponse.
- Les deux modèles, sans choisir. L'usage le plus simple d'une deuxième machine est de servir Laguna sur l'une et Qwen sur l'autre, chacun avec ses modèles de plongements, et de laisser la plateforme acheminer par modèle. Deux points d'accès de codage, deux offres souveraines, et Laguna récupère ses 121 Gio entiers pour un KV qu'il n'a jamais eu. C'est la configuration que nous ferions tourner si un client demandait Laguna précisément.
- Qwen en double, du KV partout. Deux machines Qwen indépendantes doublent la capacité simultanée à 262K pour la porter à dix, ajoutent la reprise sur panne, et gardent la mise à l'échelle linéaire par lot sur chacune. C'est la réponse ennuyeuse et probablement la bonne pour une plateforme : la capacité s'additionne, rien ne traverse l'interconnexion sur le chemin de la requête.
- Qwen en parallélisme de tenseurs sur les deux. vLLM peut répartir le 27B dense sur deux nœuds, ce qui divise par deux les octets de poids que chaque machine lit par pas et, en principe, double presque le décodage en flux unique. Le prix est un all-reduce par couche sur un lien à 25 Go/s; à la taille cachée de Qwen, cela fait quelques kilooctets par token par couche, donc le coût est en latence, pas en bande passante - plausible, non mesuré, et cela dépense la deuxième machine sur la latence en flux unique, la seule colonne où Laguna est déjà loin devant sur du code et où les deux sont à égalité sur du raisonnement.
- Un plus gros modèle à la place. L'option vraiment nouvelle : avec 256 Go, les candidats changent. La révision principale de Laguna (99,7 Go, les huit couches d'experts en BF16 que Poolside a gardées pour la qualité) tient avec de la place pour le contexte; un MoE 122B-A10B en NVFP4 (83,5 Go sur le Hub) aurait l'économie de paramètres actifs de Laguna avec une base plus forte et laisserait encore bien plus de 100 Go de KV sur la paire. C'est l'expérience que nous ferions ensuite, et c'est un autre article.
Ce qu'une deuxième machine ne changerait pas, c'est la forme du constat. Le décodage sur ce silicium est borné par les octets par pas et aidé par les tokens par pas; une plateforme est servie par le débit agrégé et le contexte simultané; et un modèle dense qui tient dans un tiers de la mémoire transforme les deux autres tiers en exactement ce qu'une plateforme vend. Plus de machines multiplient cela. Elles ne le remplacent pas.