Qwen3.6 35B-A3B sur deux cartes Intel Arc Pro B60 : 818 tokens par seconde au total
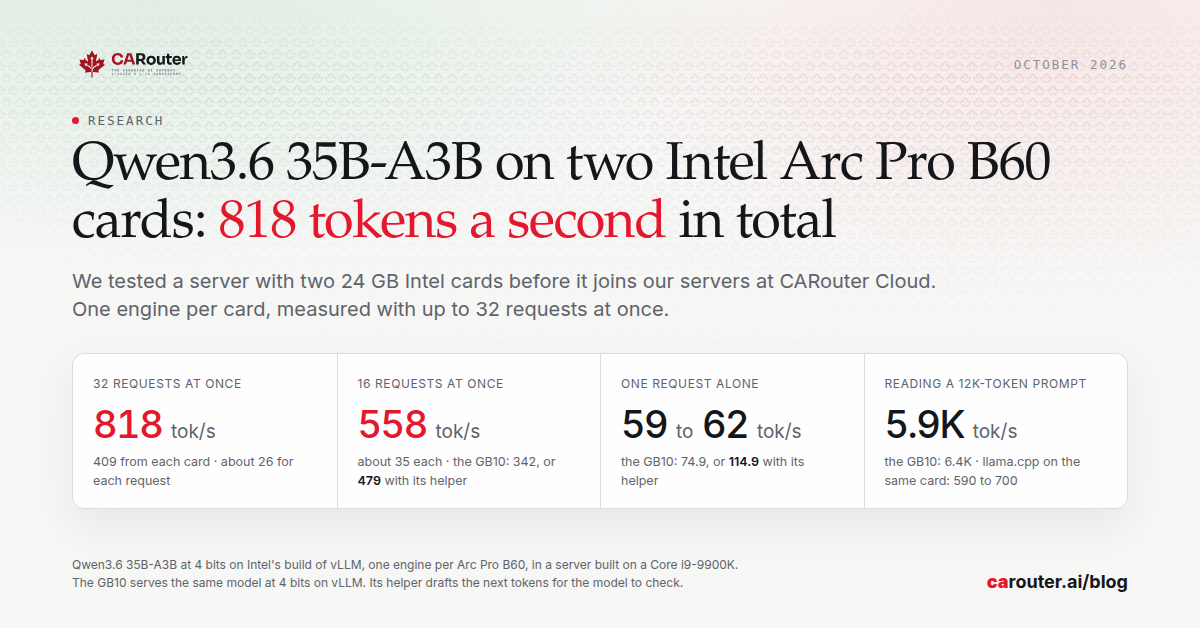
Nous avons mis à l'essai un serveur équipé de deux cartes Intel Arc Pro B60. Avec Qwen3.6 35B-A3B à 4 bits et un moteur par carte, il écrit 818 tokens par seconde au total pour 32 requêtes à la fois, et 558 pour 16, là où notre GB10 en écrit 479. Le GB10 reste plus rapide pour une requête seule. Ce serveur rejoindra nos serveurs chez CARouter Cloud.
CARouter Cloud sert des modèles ouverts sur son propre matériel, au Canada. Sa première machine repose sur un GB10 de NVIDIA, avec 128 Go de mémoire unifiée.
Nous avons mis à l'essai une deuxième sorte de machine, à Ottawa : un serveur équipé de deux cartes graphiques Intel Arc Pro B60 de 24 Go chacune. Nous y avons fait tourner le modèle que sert le GB10, Qwen3.6 35B-A3B, à 4 bits.
L'article précédent : ce modèle et son assistant intégré sur le GB10.
En bref
- Le résultat. Avec 16 requêtes sur chaque carte, les deux cartes écrivent 818 tokens par seconde au total.
- À charge égale. Avec 16 requêtes en tout, elles écrivent 558 tokens par seconde, soit environ 35 par requête. Le GB10 en écrit 342, ou 479 avec l'assistant intégré au modèle.
- Une requête seule. Le GB10 garde l'avantage : 74.9 tokens par seconde, ou 114.9 avec l'assistant, contre 59 à 62 sur une B60.
- Deux cartes en une seule réserve. Le noyau Linux le refuse sur cette génération de processeurs. Une fois cette seule vérification levée pour un test, la réserve commune a fonctionné, plus lentement qu'une seule carte, et elle a demandé une seconde fois la taille du modèle dans la mémoire du serveur.
- Le processeur. Un seul fil d'exécution du processeur donne la cadence à chaque moteur. Des cœurs plus rapides devraient accélérer une requête seule, mais nous ne l'avons pas mesuré.
- Et ensuite. Ce serveur rejoindra nos serveurs chez CARouter Cloud.
Trois moteurs sur une carte
Un moteur est le logiciel qui charge un modèle et répond aux requêtes. Nous en avons essayé trois sur une carte : llama.cpp avec son backend SYCL (son backend Vulkan était 2.8 fois plus lent), la version de vLLM publiée par Intel (llm-scaler) et OpenVINO Model Server.
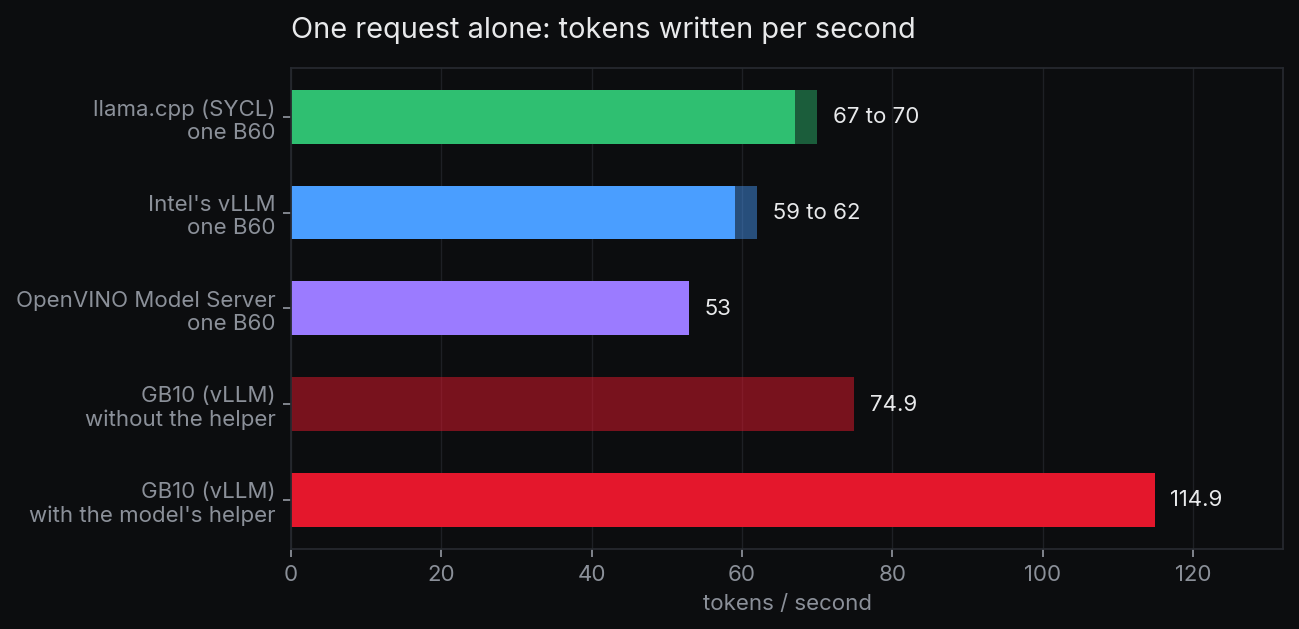
Une requête seule reçoit de 67 à 70 tokens par seconde avec llama.cpp, de 59 à 62 avec le vLLM d'Intel et 53 avec OpenVINO. Le GB10 en donne 74.9, ou 114.9 avec l'assistant du modèle, qui rédige les prochains tokens pour que le modèle les vérifie.
Ici, cet assistant n'a pas été payant. Avec le vLLM d'Intel, il a fait gagner 6 % à une requête seule et a plafonné le total entre 135 et 180 tokens par seconde.
Quand les requêtes arrivent nombreuses, le classement change. llama.cpp ne les traite pas par lots : deux requêtes dans un même serveur avancent moins vite, au total, qu'une seule. Le vLLM d'Intel écrit 300 tokens par seconde au total avec 8 requêtes et environ 410 à partir de 16, OpenVINO 212 et 256.
llama.cpp accepte une requête allant jusqu'à 262 144 tokens, soit toute la fenêtre du modèle, mais une seule à la fois. Le vLLM d'Intel partage sa fenêtre entre les requêtes en cours, et avec le modèle entier chargé il lui reste de la place pour environ 95 000 tokens. C'est la mémoire qui est comptée : sur les 23.9 Gio de chaque carte, les poids à 4 bits en occupent 19.2.
Nous avons poursuivi avec le vLLM d'Intel : c'est lui qui abat le plus de travail quand les requêtes sont nombreuses.
Deux cartes, un moteur chacune
Nous avons lancé un moteur vLLM sur chaque carte et mesuré les deux au même instant. Chaque carte donne autant que lorsqu'elle travaille seule : 409 tokens par seconde avec 16 requêtes, donc 818 en tout et environ 26 par requête.
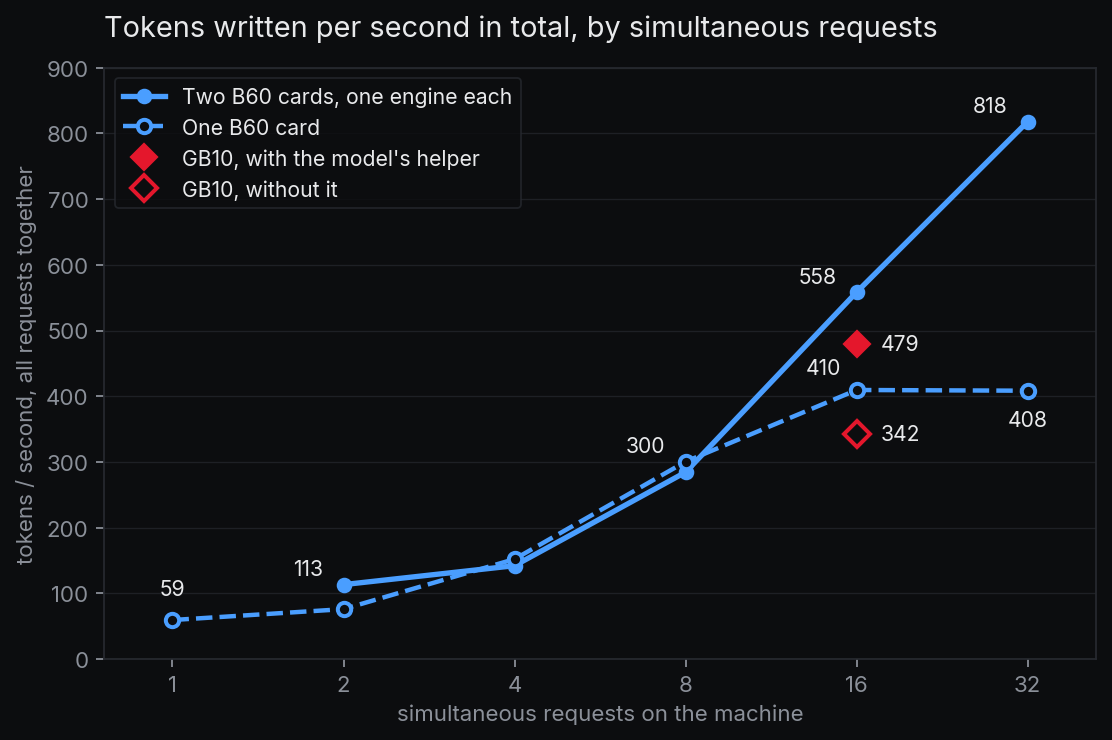
Avec 8 requêtes par carte, le total est de 558, soit environ 35 par requête. Le GB10 en écrit 342 au total avec 16 requêtes, ou 479 avec son assistant, c'est-à-dire 21 et 30 par requête.
Cette machine n'est donc pas plus rapide que le GB10 pour une requête seule. Elle ajoute de la capacité : quand les requêtes sont nombreuses, elle abat plus de travail au total, et chaque requête reçoit encore environ 35 tokens par seconde.
Ce que permet cette génération de processeurs
Le serveur repose sur une plateforme de 2018 : un Intel Core i9-9900K, processeur de 9e génération à 8 cœurs et 16 fils d'exécution, sur une carte mère ASUS PRIME Z390-A, avec 32 Go de mémoire. Il fonctionne sous Ubuntu 24.04, avec le noyau Linux 7.0.
Le vLLM d'Intel sait répartir un modèle sur deux cartes, qui doivent pour cela s'échanger de la mémoire directement (DMA pair à pair). Entre deux cartes branchées sur des ports racine distincts, comme ici, le noyau Linux ne l'autorise que si le pont hôte de la plateforme figure sur sa liste de ponts reconnus fiables.
Le pont hôte de cette génération de processeurs n'y figure pas, dans le noyau 7.0 comme dans la branche principale la plus récente que nous avons lue. Les plateformes AMD Zen et les plateformes Xeon y figurent. Avec un noyau standard, deux cartes font donc ici deux moteurs de 24 Go chacun, et non une seule réserve commune de 48 Go.
La B60 est une carte PCIe 5.0 à 8 voies, et sur cette carte mère chaque carte se connecte en PCIe 3.0. Cela n'a pas limité la vitesse de génération dans nos essais. Cela compterait pour le chargement du modèle et pour tout échange entre des cartes mises en commun.
Un seul fil d'exécution du processeur donne la cadence à chaque moteur. De 1 à 16 requêtes simultanées, chaque moteur vLLM a occupé pleinement un fil, et un seul, tandis que les 16 fils n'étaient occupés qu'à 13 % dans l'ensemble. Huit cœurs ont suffi pour deux moteurs.
De 2 à 8 requêtes simultanées, chaque requête garde la même vitesse, environ 35 à 38 tokens par seconde. C'est la signature d'un coût fixe par étape du côté de l'hôte, et non d'un travail de la carte, qui ne sature que vers 16 requêtes.
Réunir quand même les deux cartes, à titre de test
Pour savoir si la carte mère elle-même était l'obstacle, nous avons levé cette seule vérification. Un petit module de noyau, destiné uniquement au test, a fait accepter au noyau le pont hôte de ce serveur. Ce n'est pas un noyau recompilé, il exige de désactiver Secure Boot, et un redémarrage le retire.
La réserve commune a alors fonctionné. Un petit modèle, Qwen3-0.6B, réparti sur les deux cartes a donné 6 réponses sur 6 identiques à celles d'une seule carte et a passé un banc d'essai, sans aucune erreur dans le journal du noyau. Le matériel achemine bien le trafic.
Elle était plus lente qu'une seule carte, avec le même modèle et les mêmes réglages :
- Une requête seule : 36.8 tokens par seconde en réserve commune, contre 44.2 sur une carte.
- Huit requêtes à la fois : 298.8 au total, contre 356.6.
- Lecture d'un prompt de 12 000 tokens : 16 555 tokens par seconde, contre 25 793.
La vraie limite est la mémoire du serveur. Tout ce que les deux cartes partagent, les poids comme le cache, y occupe aussi sa taille, et l'espace d'échange ne l'absorbe pas. Un modèle de 29 Go a épuisé les 32 Go de cette machine pendant son chargement.
Nous n'avons pas réuni les cartes pour Qwen3.6 35B-A3B lui-même.
Ce qu'une plateforme plus récente apporterait probablement
Rien de ce qui suit n'est mesuré. C'est ce que les chiffres ci-dessus nous laissent attendre.
- Un processeur plus récent, aux cœurs plus rapides, devrait augmenter la vitesse d'une requête seule et des petits lots.
- Une plateforme inscrite sur la liste du noyau réunirait les deux cartes sans module de test.
- Davantage de mémoire permettrait à la réserve commune d'accueillir un grand modèle : à peu près autant, en plus, que ce que les deux cartes partagent.
- Des emplacements PCIe 5.0 relieraient les cartes à la vitesse qu'elles acceptent, ce qui devrait aider le chargement et le trafic entre cartes réunies.
Longs prompts et images
Le vLLM d'Intel lit un prompt de 12 000 tokens à environ 5 900 tokens par seconde, contre environ 6 400 pour le GB10 et de 590 à 700 pour llama.cpp.
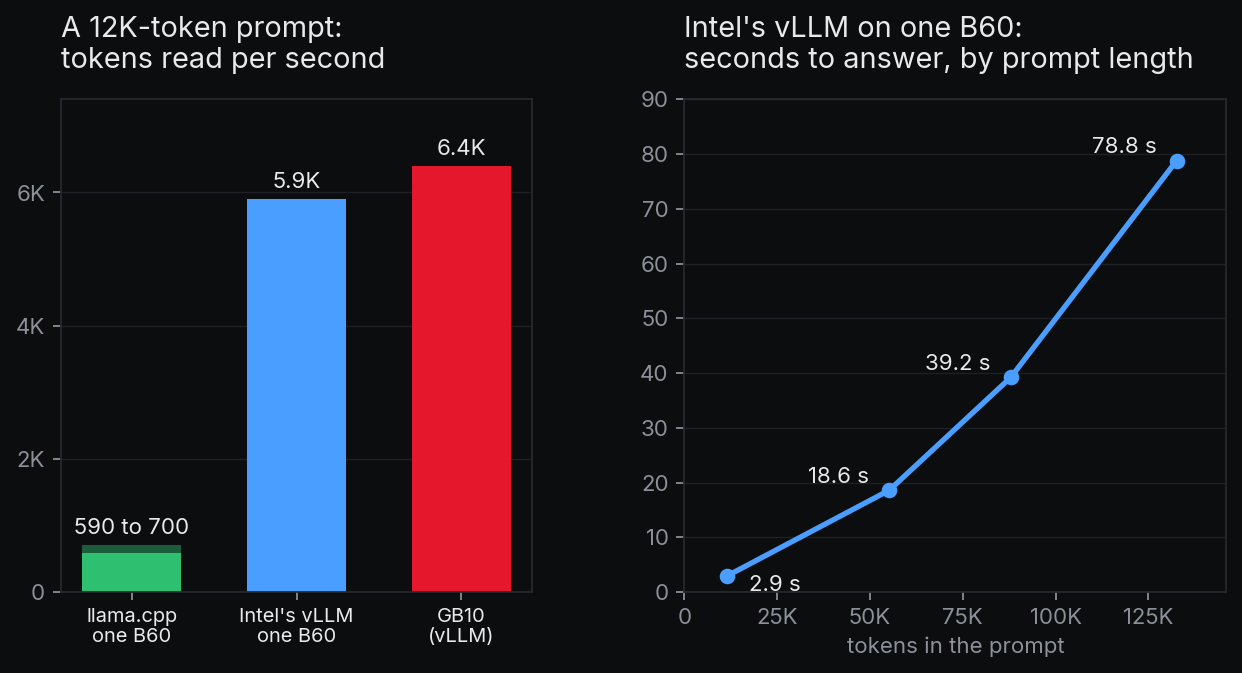
La lecture ralentit à mesure que le prompt s'allonge. Sur une carte, une requête seule reçoit sa réponse en 2.9 secondes pour un prompt de 11 400 tokens, en 18.6 secondes pour 55 216 tokens, en 39.2 secondes pour 87 923 tokens et en 78.8 secondes pour 132 606 tokens.
Les images fonctionnent avec le vLLM d'Intel : une image de 1024 sur 1024 représente environ 1 050 tokens et prend moins d'une seconde.
Chargés sans la partie du modèle qui lit les images, les poids occupent 18.4 Gio au lieu de 19.2. Cela laisse tout juste la place, sur une carte, pour toute la fenêtre du modèle, soit 262 144 tokens.
Chaleur : testez avec beaucoup de requêtes
La deuxième carte est arrivée avec un ventilateur qui ne tournait pas, et elle a atteint de 93 à 96 °C en charge. Une requête seule gardait sa vitesse : 62.4 tokens par seconde, contre 61.5 une fois le ventilateur réparé. Avec 8 requêtes, le total tombait de 298.8 à 98.2.
Une fois le ventilateur réparé, les cartes culminent entre 68 et 74 °C environ lorsque les deux sont à pleine charge. Un problème thermique ne se voit pas avec une seule requête : testez avec beaucoup.
Et ensuite
Ce serveur rejoindra nos serveurs chez CARouter Cloud.