AirLLM fait tourner Qwen3.6 35B-A3B en pleine précision sur une carte de 24 Go : un token toutes les 10 à 68 secondes
AirLLM est une bibliothèque libre qui fait passer un modèle par une carte graphique, une couche à la fois. Avec elle, Qwen3.6 35B-A3B en pleine précision, un modèle de 67 Gio, a tourné sur une carte de 24 Go : dans moins de 3 Gio pour un prompt court, une image ou une vidéo, et avec toute sa fenêtre quand le prompt est lu par morceaux. Il écrit un token toutes les 10 secondes sur un GB10 limité à 24 Go et un toutes les 68 secondes sur une Intel Arc Pro B60, là où le service du modèle à 4 bits écrit de 60 à 75 tokens par seconde.
CARouter Cloud sert Qwen3.6 35B-A3B sur son propre matériel, au Canada. Nous le servons à 4 bits, une forme compressée d'environ 20 Gio qui tient sur une carte graphique de 24 Go.
En pleine précision, le même modèle pèse 67 Gio. AirLLM est une bibliothèque libre qui dit faire tourner un tel modèle sur une petite carte, sans le compresser.
Nous l'avons vérifié sur ce modèle. Tourne-t-il dans 24 Go, avec les images, la vidéo et toute la fenêtre du modèle, et à quelle vitesse ?
L'article précédent : ce modèle servi à 4 bits sur deux cartes Intel Arc Pro B60.
En bref
- Le résultat. AirLLM fait tourner le modèle en pleine précision dans moins de 3 Gio d'une carte de 24 Go. Le texte, les images et la vidéo fonctionnent, et les réponses sont celles qu'écrit notre moteur de service.
- Le prix. Un token toutes les 10 secondes sur un GB10 limité à 24 Go, et un toutes les 68 secondes sur une Intel Arc Pro B60. Une réponse de 500 tokens prend 1 heure 25 minutes, ou 9 heures 27 minutes.
- Par rapport au service. Servi à 4 bits, le modèle écrit 74.9 tokens par seconde sur notre GB10 et de 59 à 62 sur une Arc Pro B60. AirLLM est environ 760 et 4 100 fois plus lent.
- La fenêtre. Tel qu'il est livré, AirLLM lit un prompt d'environ 78 000 tokens dans 24 Go, sur les 262 144 que le modèle accepte. Avec une courte boucle de notre cru autour de lui, un prompt qui remplit presque la fenêtre est lu, en 15 minutes sur le GB10 et en 47 sur l'Arc Pro B60.
- Notre lecture. C'est un moyen d'obtenir une réponse de référence du modèle complet sur une petite carte. Ce n'est pas un moyen de servir.
Comment un modèle de 67 Gio passe par une petite carte
Un modèle est un empilement de couches, 40 pour celui-ci, et chaque token se calcule en les traversant dans l'ordre. Un moteur de service comme vLLM garde toutes les couches sur la carte graphique : la carte doit donc être aussi grande que le modèle.
AirLLM garde le modèle sur le disque, un fichier par couche. Pour chaque token, il copie une couche sur la carte, l'exécute, la libère, puis passe à la suivante.
La carte ne contient jamais plus qu'une couche et le travail en cours. En échange, chaque token fait passer tout le modèle, 65 Gio, par la carte.
Ce que nous avons fait tourner
AirLLM 4.0.0 sur les fichiers en pleine précision de Qwen3.6 35B-A3B publiés par Qwen, une requête à la fois, sur deux machines.
La première est un GB10 loué, la puce de notre propre machine, avec 128 Go de mémoire partagée entre le processeur et le graphique. Nous avons limité le logiciel à 24 Gio de mémoire graphique : il se comporte comme une carte de 24 Go dans une machine qui a beaucoup de mémoire.
La seconde est une vraie carte de 24 Go : une Intel Arc Pro B60 dans le serveur de l'article précédent, qui a 32 Go de mémoire. Son autre carte a continué de servir des clients pendant l'essai.
L'exemple en une ligne d'AirLLM n'a pas chargé ce modèle, absent de sa liste. Sa propre classe pour un modèle voisin, Qwen3.8 27B, désignée à la main, l'a chargé. Nous n'avons rien changé dans AirLLM.
Il tient, et il répond comme notre moteur
Un prompt court, une image et un court extrait vidéo ont chacun culminé sous 3 Gio de mémoire graphique. Le pilote de l'Arc Pro B60 a compté de 3.5 à 4 Gio utilisés, sur 24.
Nous avons envoyé les mêmes prompts à vLLM, chargé des mêmes fichiers en pleine précision. Les 24 tokens de texte, la phrase sur l'image et la réponse sur l'extrait étaient identiques, au caractère près.
Un token toutes les 10 secondes, ou toutes les 68
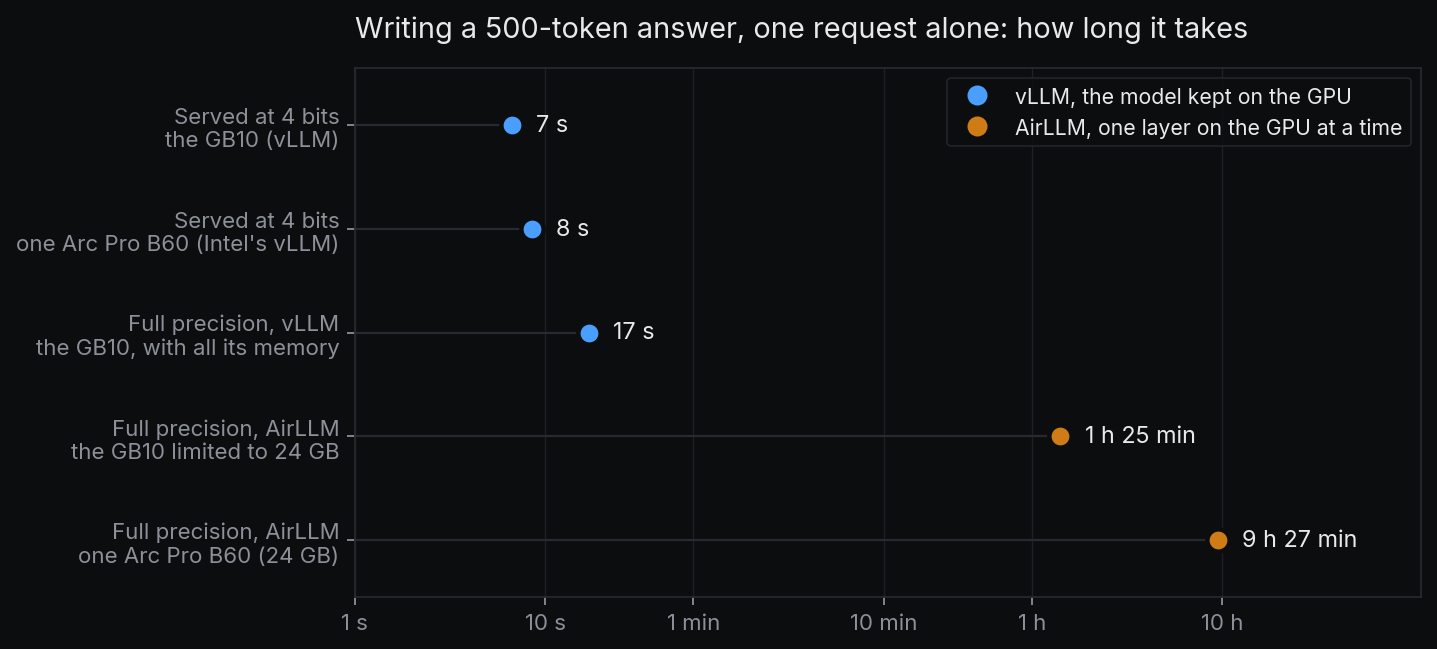
Sur le GB10 limité à 24 Go, AirLLM écrit un token toutes les 10 secondes. Une réponse de 500 tokens, environ une page, prend 1 heure 25 minutes. Notre GB10 sert le modèle à 4 bits à 74.9 tokens par seconde : la même réponse en 7 secondes.
Sur l'Arc Pro B60, un token prend 68 secondes et la réponse 9 heures 27 minutes. La même carte sert le modèle à 4 bits à 59 à 62 tokens par seconde.
Ce n'est pas la pleine précision qui coûte le plus. vLLM, avec les mêmes fichiers en pleine précision sur un GB10 qui utilise toute sa mémoire, écrit 29.6 tokens par seconde : la réponse en 17 secondes.
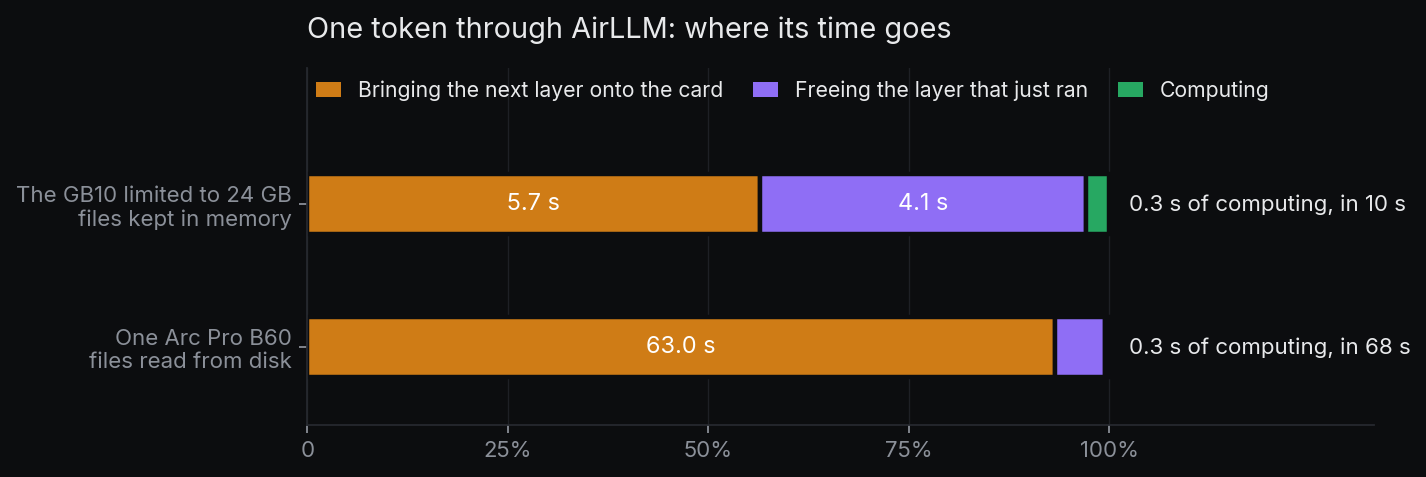
Presque tout le temps passe à déplacer le modèle. Sur les 10 secondes du GB10, 5.7 amènent la couche suivante sur la carte, 4.1 libèrent la précédente, et 0.3 sert au calcul.
Les deux machines diffèrent par l'endroit où se trouvent les fichiers. La mémoire du GB10 contient leurs 65 Gio : une couche se copie depuis la mémoire. Le serveur de la B60 a 32 Go : chaque token relit tout le modèle sur le disque, à environ 1.1 Go par seconde.
La fenêtre : 78 000 tokens tel que livré, toute la fenêtre par morceaux
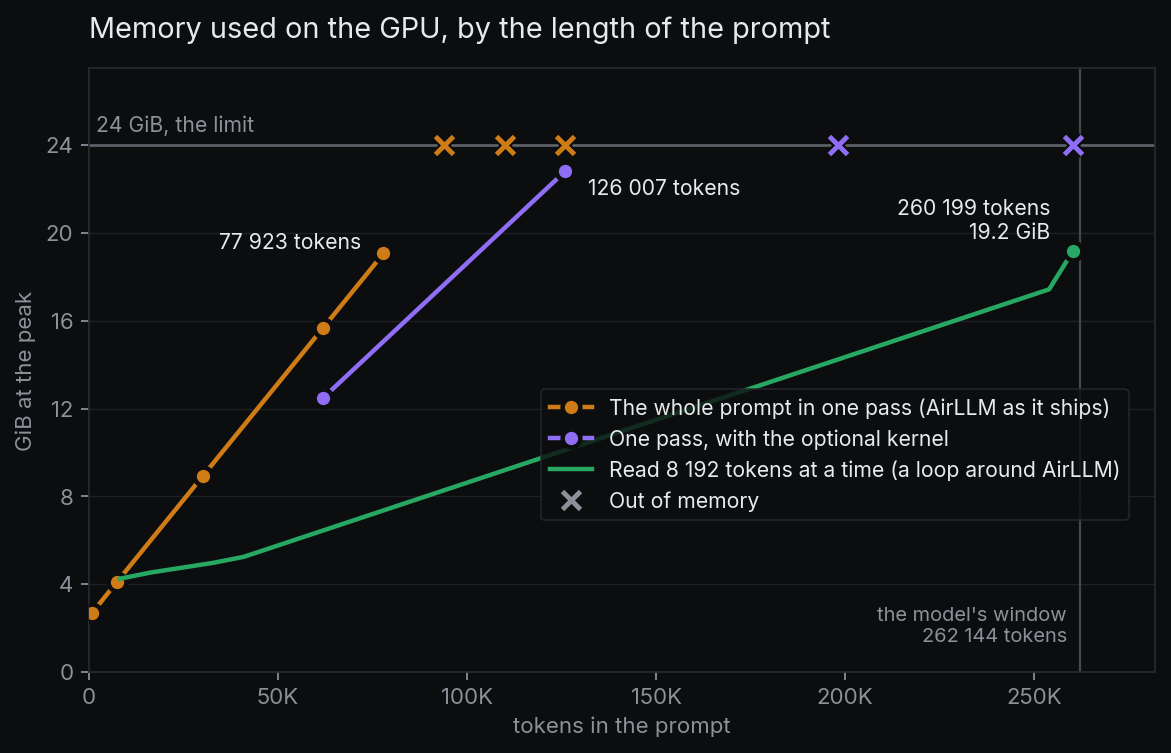
Le modèle accepte jusqu'à 262 144 tokens à la fois : c'est sa fenêtre. AirLLM donne tout le prompt au modèle en un seul passage, et la mémoire utilisée grandit avec le prompt, d'environ 0.2 Gio par millier de tokens.
Dans 24 Gio, un prompt de 77 923 tokens est passé, et un de 93 938 non. Un composant optionnel que le code d'AirLLM mentionne, flash-linear-attention, a repoussé la limite : 126 007 tokens sont passés, 198 087 non.
Sur l'Arc Pro B60, un prompt de 30 094 tokens est passé en un seul passage. Un de 61 908 tokens a rempli la carte, et nous avons arrêté cet essai.
Nous avons ensuite écrit une courte boucle autour d'AirLLM. Elle donne le prompt au modèle 8 192 tokens à la fois et conserve, entre deux passages, ce que le modèle retient de ce qu'il a lu.
Avec elle, un prompt de 260 199 tokens, presque toute la fenêtre, a été lu en 15 minutes dans 19.2 Gio sur le GB10, et un fait placé à son début a été retrouvé.
Sur l'Arc Pro B60, le même prompt a été lu en 47 minutes, avec 16.3 Gio de la carte utilisés au maximum, et le fait a été retrouvé là aussi.
Chaque morceau est un passage complet sur le modèle. vLLM lit le même prompt en une minute environ.
Le mode 4 bits d'AirLLM
AirLLM a son propre mode de compression, à 4 bits, annoncé comme jusqu'à trois fois plus rapide.
Tel que livré, il n'a pas démarré sur ce modèle. Sa vérification de l'espace disque libre a demandé 238 Go pour un modèle de 67 Gio, et l'option qui saute cette vérification s'est arrêtée sur son premier fichier.
Une fois cette vérification contournée à la main, il a tourné sur le GB10 à un token toutes les 129 secondes : 13 fois plus lent que sans compression.
Nous ne voyons qu'un seul usage à AirLLM : vérifier ce que répond un modèle en pleine précision à un prompt donné, sur une machine qui ne peut pas le contenir.