CKKS peut-il rendre l’IA confidentielle accessible?
Nous avons testé des bibliothèques CKKS actuelles sur GPU avec les dimensions du modèle Qwen. Les opérations matricielles et le traitement par lots progressent; un service complet de conversation confidentielle reste à démontrer.
Notre première expérience a généré du texte à travers des opérations linéaires chiffrées, avec un débit très inférieur à notre seuil interactif. Ce nouvel essai examine si les bibliothèques CKKS sur GPU offrent de meilleures bases pour une IA confidentielle.
Lire notre premier benchmark d’inférence homomorphe.
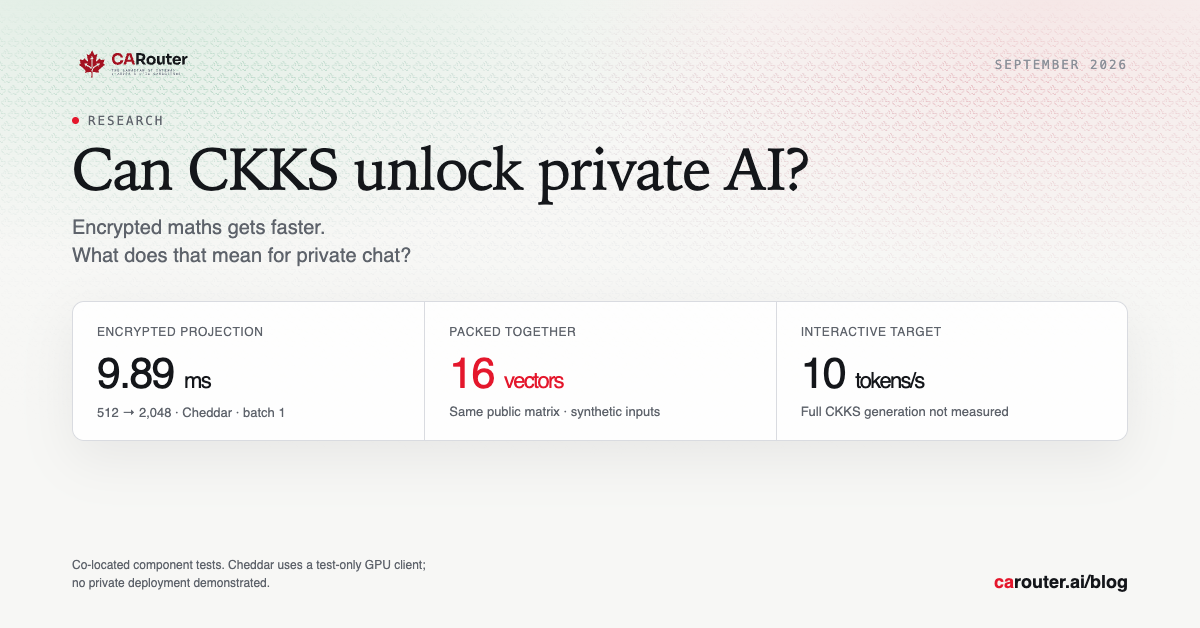
Sur un A100 80 GB SXM, une projection compacte de 512 → 2 048 a pris 23,43 ms avec FIDESlib et 9,89 ms avec Cheddar. Le regroupement des vecteurs a aussi augmenté le débit total. Ces mesures matricielles sont validées : nous n’avons pas généré de réponse LLM complète avec CKKS, et aucun de ces montages n’a démontré la confidentialité face à l’hôte.
Pourquoi tester CKKS?
CKKS désigne le schéma de Cheon, Kim, Kim et Song pour le calcul approché sur des nombres chiffrés. Il peut regrouper des valeurs dans un même texte chiffré et les traiter ensemble. Cette propriété convient aux opérations matricielles des réseaux neuronaux, mais introduit une erreur numérique qu’il faut mesurer. L’article scientifique à l’origine de CKKS.
Nous avons compilé des révisions figées de FIDESlib et de Cheddar. FIDESlib propose des opérations CKKS sur GPU interopérables avec OpenFHE. Cheddar fournit une implémentation GPU avec des transformations linéaires optimisées. Le moteur de calcul diffère donc de celui de notre première expérience; il ne s’agit pas d’une option de chiffrement à activer dans vLLM. FIDESlib. Cheddar.
Ce que nous avons mesuré
Les dimensions du test proviennent de Qwen3.6-35B-A3B. Les vecteurs et les poids étaient synthétiques et publics. Les valeurs d’entrée ont été tirées uniformément entre −1 et 1; les poids utilisaient la même plage, divisée par la racine carrée de la largeur d’entrée. Nous avons mesuré des produits entre vecteurs chiffrés et matrices en clair, en réutilisant les poids préparés d’un essai à l’autre.
Chaque configuration comprenait 1 essai de chauffe, puis 3 essais mesurés. Nous avons synchronisé le GPU avant et après chaque évaluation, puis comparé toutes les sorties à une référence en clair. L’erreur absolue maximale autorisée était fixée à 0,0001. Les résultats ci-dessous présentent les médianes; le graphique et le tableau matriciels affichent aussi les minimums et maximums observés, sans prétendre représenter des intervalles de confiance.
L’évaluation GPU exclut la génération des clés, la préparation des poids, l’encodage, le chiffrement, le déchiffrement et le transport réseau. Les deux clients cryptographiques fonctionnaient sur la VM GPU. Le contrôleur CPU séparé gérait la collecte et la suppression; il ne jouait pas le rôle de client cryptographique de confiance. Ces montages convenaient à des données de test publiques, pas aux requêtes privées des clients.
La configuration matricielle FIDES imposait la vérification HEStd_128_classic d’OpenFHE, avec une dimension d’anneau de 16 384, une profondeur de 2 et des modules de mise à l’échelle de 40 bits. Cheddar utilisait les paramètres bootparam_40 du projet au niveau 2, avec une dimension d’anneau de 65 536 et une arithmétique de 32 bits. Les paramètres et les chemins d’évaluation diffèrent : la comparaison porte sur nos configurations et n’isole pas le seul effet de la bibliothèque.
Le rangement des valeurs compte aussi
Nous avons d’abord complété les matrices rectangulaires pour obtenir des dispositions carrées. Un rangement plus dense des diagonales et la combinaison des sommes partielles ont réduit le calcul inutile. Avec FIDES, la projection 512 → 2 048 est passée de 83,13 ms à 23,43 ms. Le tableau utilise cette disposition plus dense pour les deux bibliothèques. Cheddar emprunte le chemin alternatif qui minimise les changements de clé et qui a réussi nos vérifications numériques.
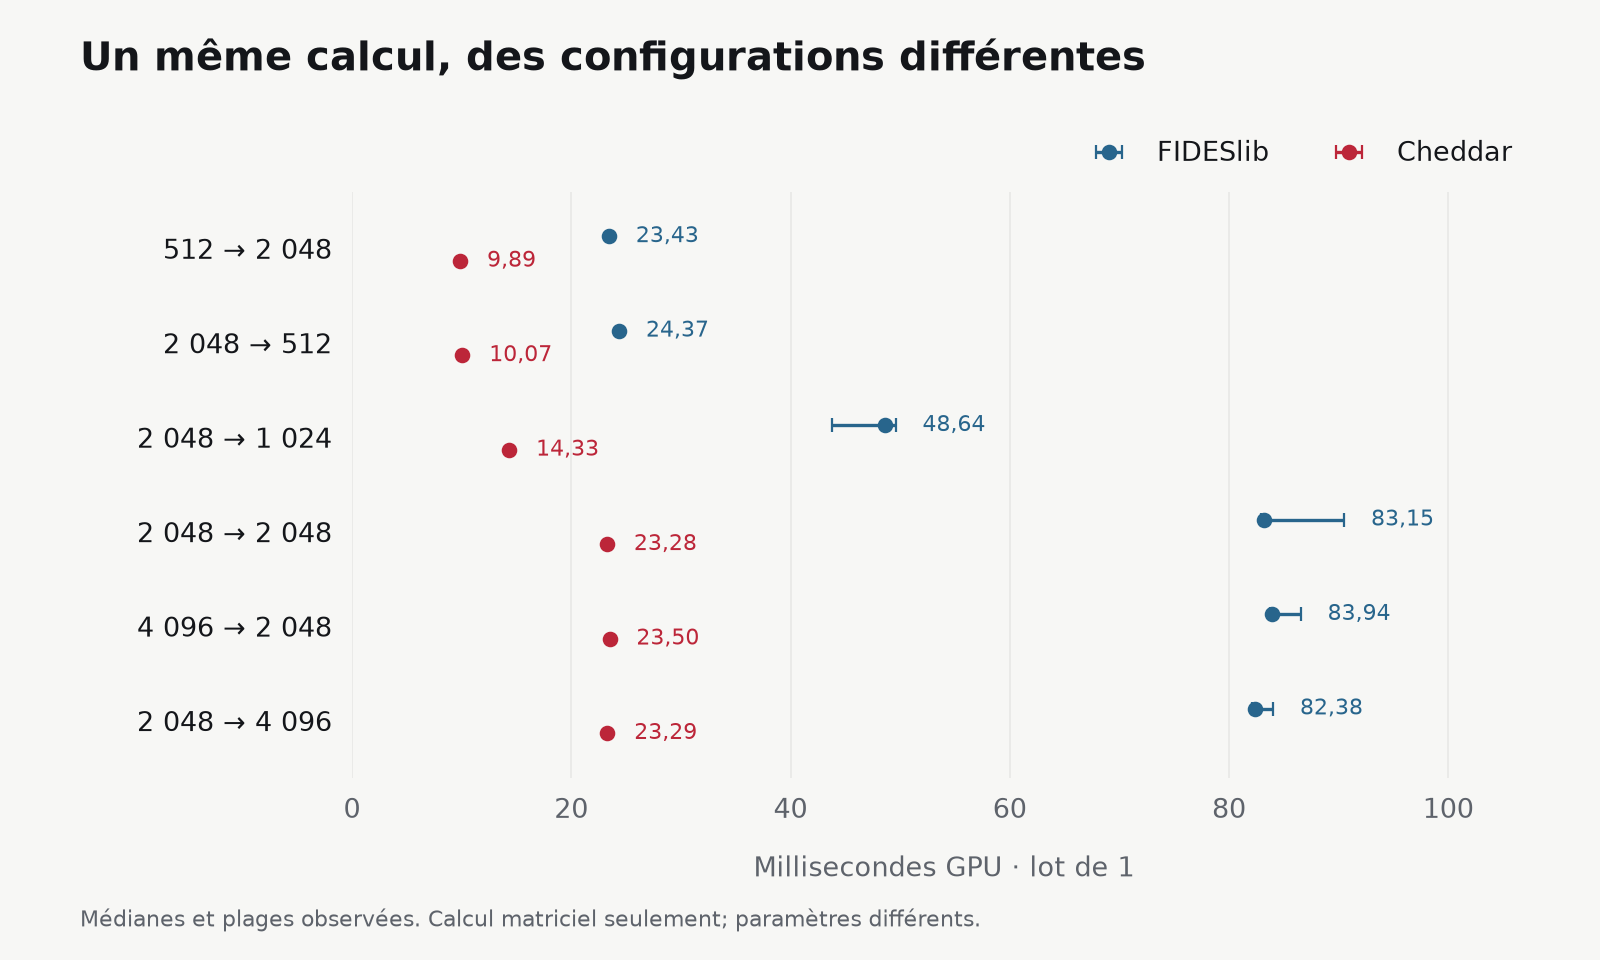
| Largeur d’entrée → de sortie | FIDESlib | Cheddar |
|---|---|---|
| 512 → 2 048 | 23,43 (23,4–23,46) | 9,89 (9,88–9,89) |
| 2 048 → 512 | 24,37 (24,32–24,38) | 10,07 (10,07–10,09) |
| 2 048 → 1 024 | 48,64 (43,82–49,6) | 14,33 (14,32–14,36) |
| 2 048 → 2 048 | 83,15 (82,87–90,52) | 23,28 (23,28–23,28) |
| 4 096 → 2 048 | 83,94 (83,69–86,56) | 23,5 (23,47–23,51) |
| 2 048 → 4 096 | 82,38 (82,05–84,04) | 23,29 (23,29–23,31) |
Nous avons aussi récupéré une seule matrice de projection de porte dans le checkpoint figé, sans télécharger le modèle complet. FIDES a évalué cette projection 2 048 → 512 en 23,74 ms, avec une erreur absolue maximale inférieure à 0,000001 lors des essais mesurés. Les activations restaient synthétiques. Ce test valide une opération avec de vrais poids, pas un bloc de transformeur, du texte généré ou la qualité du modèle.
Le débit par lots n’est pas la vitesse d’une conversation
Pour la projection 2 048 → 1 024 de Cheddar, le regroupement de 16 vecteurs indépendants dans un même texte chiffré a maintenu l’évaluation GPU près de 14,4 ms. Le débit limité à cette évaluation est passé de 69 à 1 111 vecteurs/s. Tous les vecteurs partageaient la même matrice publique et le même contexte de chiffrement; nous n’avons pas testé le regroupement de clients distincts possédant des clés différentes.
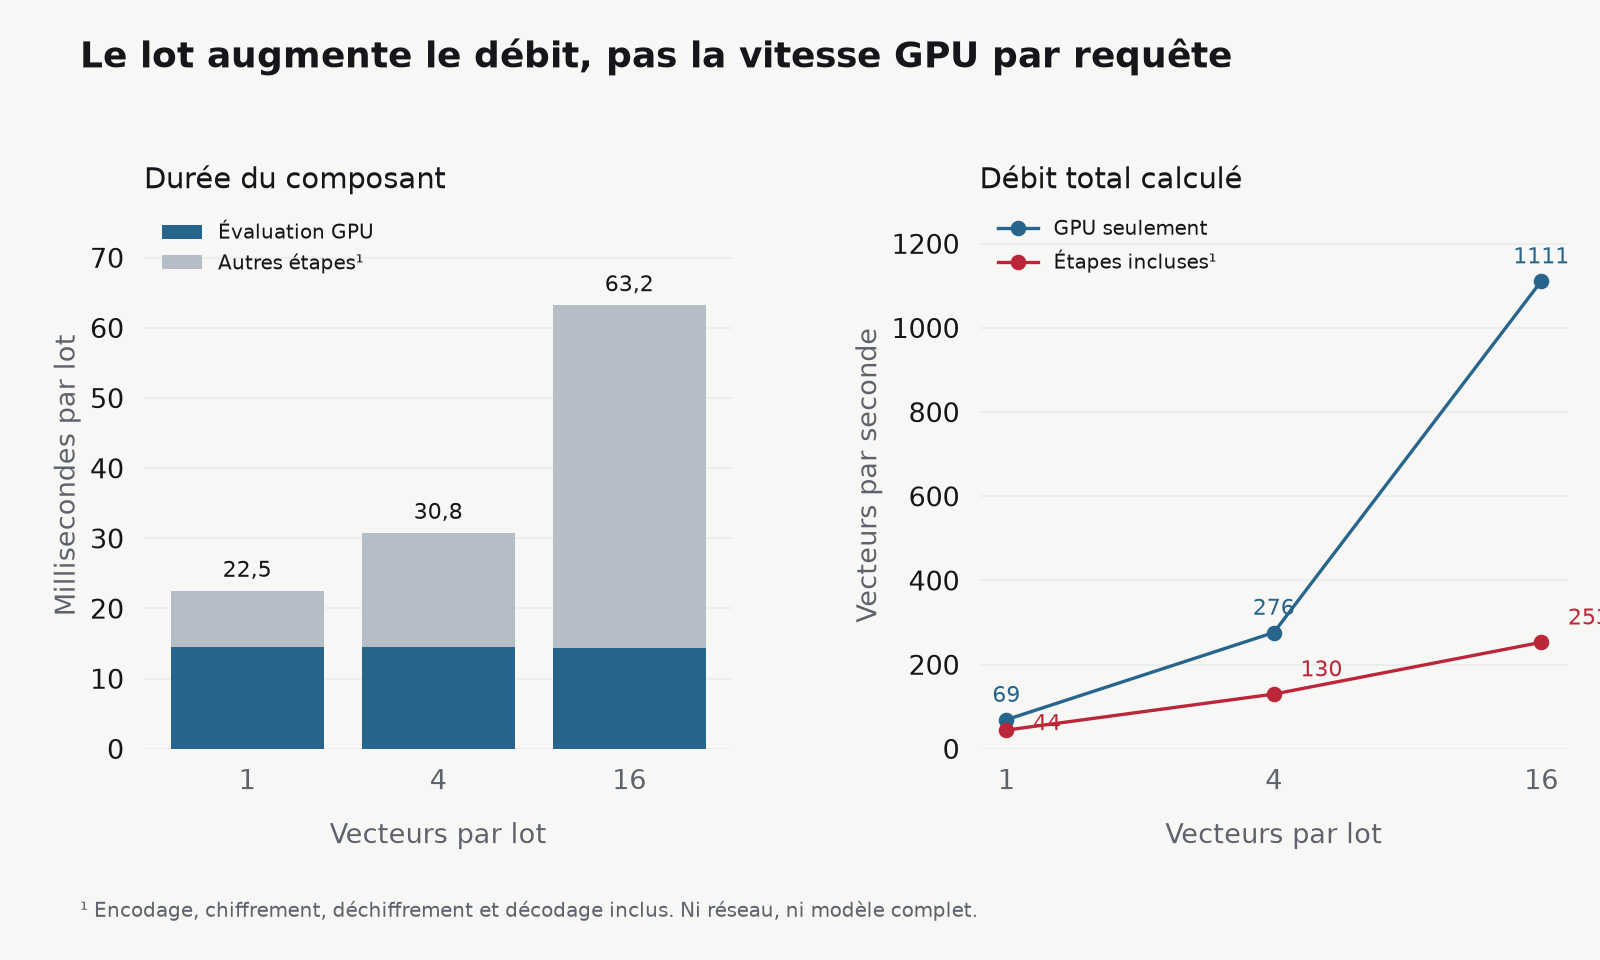
En incluant l’encodage, le chiffrement, le déchiffrement et le décodage, le composant mesuré avec un lot de 16 a pris 63,23 ms, pour un débit de 253 vecteurs/s. La préparation des poids réutilisables a pris 52,3 secondes, exclues de ces mesures. Nous n’avons pas démontré que tous les poids préparés du modèle complet peuvent rester en cache, ni mesuré les coûts de transport réseau et d’attente.
Les essais rejetés comptent
Notre première configuration de transformation matricielle fusionnée de Cheddar a produit des résultats incorrects, malgré un chiffrement/déchiffrement précis et une rotation isolée correcte. Une configuration sans BSGS et le chemin alternatif minimisant les changements de clé ont réussi le petit test. Les résultats publiés utilisent ce dernier. Nous n’avons pas établi la cause du problème ni conclu que toutes les configurations du projet échouent.
Nous avons aussi testé le bootstrap de FIDES, qui renouvelle un texte chiffré pour permettre de poursuivre le calcul. Le déchiffrement a échoué avec la configuration de 40 bits. Les configurations de précision supérieure ont produit des erreurs maximales d’environ 0,000207 et 0,000127, toutes deux au-dessus de notre seuil fixe de 0,0001. Ces essais se sont arrêtés pendant la chauffe; leurs durées ne sont donc pas présentées comme des performances de bootstrap validées.
Le client fourni avec Cheddar avertit explicitement qu’il est destiné aux tests et qu’il n’est pas sécurisé. Il conserve les secrets de test sur le GPU. La vérification des paramètres de FIDES est utile, mais notre client installé sur la même VM exposait tout de même sa clé privée au propriétaire de l’hôte. Réussir un test numérique ne valide pas la confidentialité d’un déploiement. L’avertissement du client Cheddar.
Ce que cela signifie pour le seuil de 10 tokens/s
Notre seuil laisse 100 ms par token généré. Pour donner un ordre de grandeur, la somme séquentielle des médianes Cheddar mesurées pour les projections gate, up et down de l’expert partagé, sur les 40 couches du modèle, représente 1,2 secondes de travail GPU. Ce calcul illustratif exclut les experts sélectionnés, l’attention, les opérations non linéaires, l’état de la conversation, la projection du vocabulaire et les coûts client. Ce n’est ni un débit de modèle mesuré ni une limite minimale universelle : la fusion, le traitement par lots et une autre implémentation pourraient le modifier.
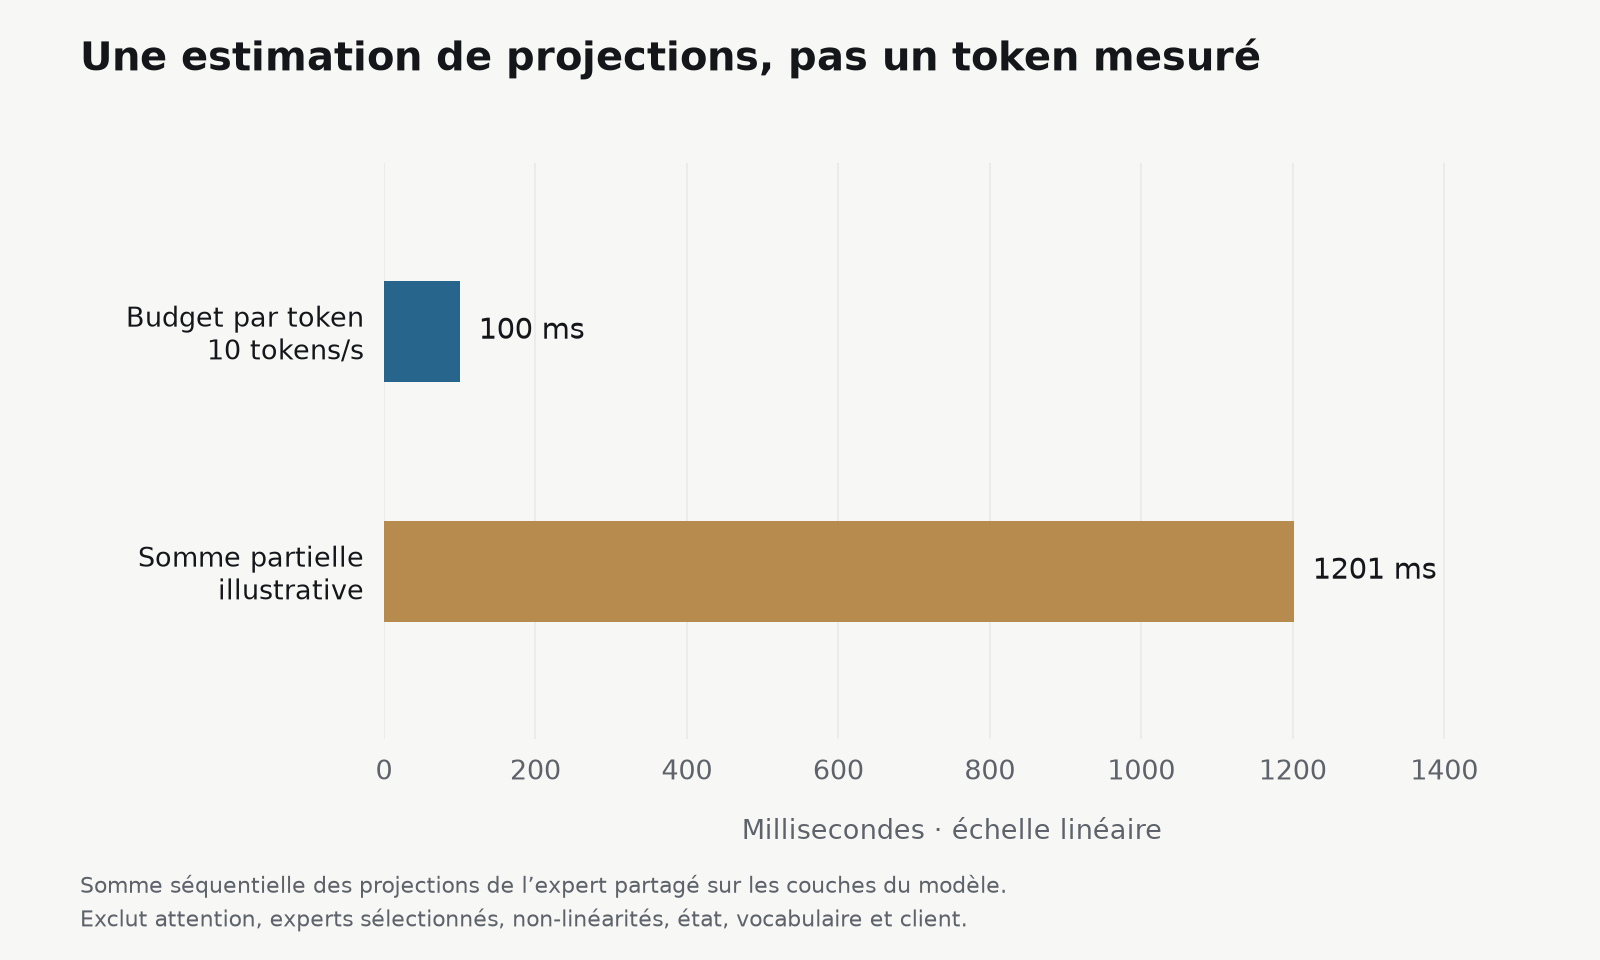
Nous avons donc arrêté l’expérience au test des composants, sans prétendre avoir mesuré une inférence CKKS complète. Cette expérience ne fournit aucun résultat CKKS en tokens/s ni en coût par million de tokens. Pour une projection par lots seulement, le coût de l’évaluation GPU par million de vecteurs est de 1 000 000 × P × t / (3 600 × B), où P est le tarif horaire du GPU, t la durée d’évaluation en secondes et B la taille du lot. La préparation, le travail client, le transport et le reste du modèle s’ajoutent.
Souveraineté et GPU disponibles : une piste de recherche, pas encore un service
Pouvoir calculer sans fournir des requêtes lisibles à l’exploitant du GPU pourrait élargir le parc de matériel utilisable à l’échelle mondiale. Cette expérience montre que les bibliothèques CKKS actuelles méritent d’être étudiées davantage dans cette direction. Elle n’établit ni une solution pratique à la pénurie de GPU ni une garantie complète de souveraineté. Le surcroît de calcul cryptographique peut aussi demander davantage de capacité GPU par réponse utile.
Un système utilisable exige encore une frontière de confiance pour le client et ses clés, une attention et un état chiffrés validés, des approximations non linéaires adaptées, une qualité de réponse acceptable et une politique sur les fuites liées au choix des experts et aux caractéristiques du trafic. La confidentialité seule ne peut pas non plus obliger un hôte à renvoyer une réponse correcte, à rester disponible ou à effacer ses copies. Terraform et dstack peuvent gérer les machines; ces propriétés exigent un protocole d’inférence conçu et testé pour les assurer.
La poursuite des travaux homomorphes nécessiterait un bloc chiffré complet et validé avec un client de confiance séparé, puis des essais de qualité du modèle et de latence de bout en bout si cette étape réussit. Nous reportons ces travaux. Les résultats actuels ne justifient pas le lancement d’un service de conversation chiffrée sur GPU communautaires à notre seuil interactif.
Une suite possible : des VM confidentielles avec GPU protégés
Une machine virtuelle chiffrée pourrait-elle rendre l’inférence sur GPU communautaires viable? Tout dépend de ce que le chiffrement protège. Les disques chiffrés protègent les fichiers stockés, tandis qu’une VM classique ou un hyperviseur de type 2 ajouté laisse la mémoire en cours d’utilisation accessible à l’hôte externe. Une VM confidentielle protégée par le matériel peut protéger la mémoire CPU, mais le simple passage direct du GPU à la VM n’étend pas cette protection à sa mémoire et à ses calculs.
L’architecture à évaluer associe une VM CPU confidentielle, un GPU fonctionnant dans un mode de calcul confidentiel pris en charge et une connexion protégée entre les deux. Un vérificateur indépendant contrôlerait des preuves récentes d’attestation du CPU et du GPU, le logiciel invité approuvé et l’identité de sa session avant de libérer des clés ou d’envoyer des requêtes privées. Le passage direct du GPU fait partie de cette configuration; il ne constitue pas à lui seul la garantie de sécurité. Architecture de référence pour VM et GPU confidentiels.
Contrairement à l’évaluation homomorphe, cette approche permettrait à un moteur classique comme vLLM de calculer sur des données en clair à l’intérieur de l’environnement protégé. Elle évite de transformer les opérations du modèle en calculs homomorphes, mais ses performances sur notre charge de travail restent à mesurer. La confiance repose alors sur la protection matérielle, le micrologiciel, le logiciel invité approuvé et les services d’attestation et de remise des clés.
Des hôtes communautaires compatibles pourraient ainsi contribuer sans que leurs outils habituels d’administration donnent accès aux requêtes en clair. Cela ne rend pas n’importe quel matériel admissible : la plateforme doit prendre en charge et exposer l’ensemble du chemin protégé. Le propriétaire peut toujours interrompre le service ou conserver des copies chiffrées, et la garantie ne couvre pas toutes les attaques physiques ni tous les canaux auxiliaires. La confidentialité n’établit pas non plus, à elle seule, la résidence géographique ou la souveraineté. Modèle de menace et limites du calcul confidentiel.
Il s’agit d’une proposition de suivi, reportée pour le moment. Nous n’avons pas réalisé cette expérience sur VM confidentielle et ne présentons aucun résultat de débit ni de validation de sécurité pour cette architecture. Si nous y revenons, nous vérifierons d’abord l’attestation et le refus des configurations non prises en charge, puis comparerons le même modèle et la même charge de travail avec et sans mode confidentiel, en mesurant la latence du premier token, la vitesse de décodage et le coût.
Les crédits de calcul de Denvr ont soutenu ce travail. Les mesures et les conclusions sont les nôtres. Le GPU et le contrôleur ont été supprimés après récupération et vérification des résultats et des archives de sources; la matrice Qwen téléchargée et les bibliothèques compilées n’ont pas été conservées.
Contactez-nous pour obtenir les données du benchmark et les fichiers sources.