MTP contre DFlash2 sur le DGX Spark de CARouter : 35 % de tokens en plus par pas, pas un pas plus rapide
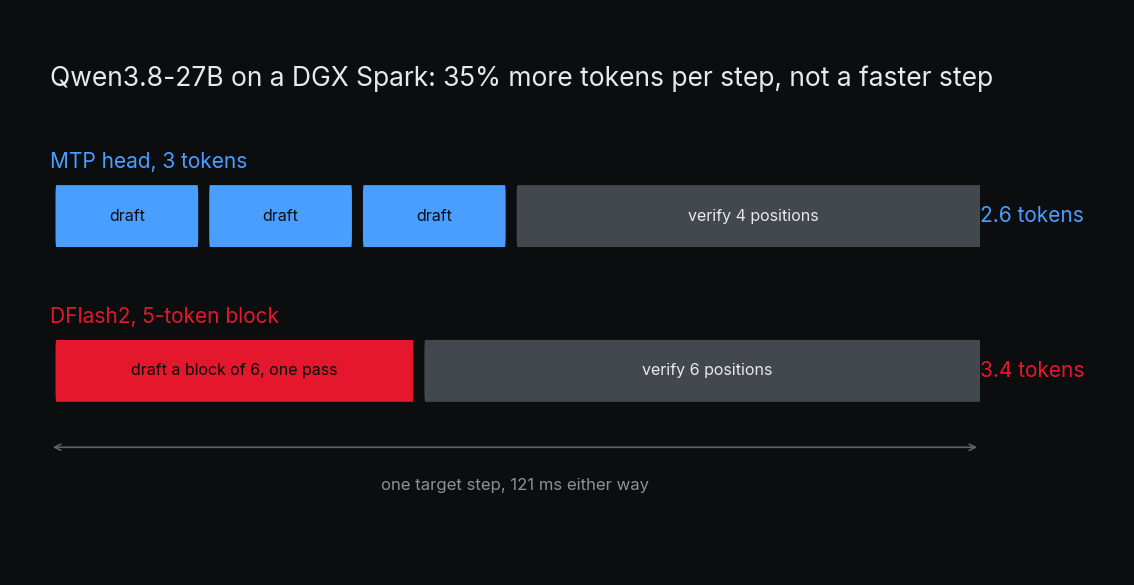
Une infolettre promettait 3× grâce au décodage spéculatif le matin même où vLLM 0.28.0 livrait le brouillon qui manquait à Qwen3.8-27B. Nous avons confronté l'article à notre DGX Spark de 128 Go ligne par ligne, puis mesuré DFlash2 contre la tête MTP de 1 à 16 flux et à trois tailles de bloc. CARouter Cloud décode un tiers plus vite par flux; le pas n'est pas devenu plus rapide du tout; et l'estimation que nous avions écrite d'abord était fausse d'exactement le coût du brouillon.
CARouter Cloud est la partie de CARouter que nous hébergeons nous-mêmes : un ASUS Ascent GX10 (une machine de classe NVIDIA GB10 « DGX Spark », 128 Go de mémoire unifiée, arm64) qui fait tourner vLLM derrière un proxy TLS et sert deux modèles de plongements et, depuis l'article précédent, Qwen3.8-27B comme modèle de codage. Cet article-là se terminait sur un constat de mémoire. Celui-ci parle de vitesse, et il commence par une coïncidence : le 26 août 2026, une infolettre de ByteByteGo intitulée « How to Make LLMs 3X Faster », une bonne explication du décodage spéculatif, arrivait dans la boîte de réception, et le même matin vLLM 0.28.0 était publié avec le seul brouillon que notre modèle ne pouvait pas encore utiliser. Nous avons donc confronté l'article à la machine ligne par ligne, puis mené l'expérience qu'il venait de rendre possible. Voici ce qui s'est amélioré, ce qui ne l'a pas fait, et ce que vaut un titre en « 3× » sur de la mémoire unifiée.
En bref
- Déjà en place. Qwen3.8-27B appliquait déjà la technique de l'article : sa tête de prédiction multi-tokens (MTP) intégrée, passée trois fois, plaçait 2,76 tokens par pas sur le trafic de production - 75 %, 57 % et 44 % aux trois positions, lus dans 22 heures de requêtes de notre plateforme elle-même.
- Le levier. La seule chose qui restait, c'était un meilleur brouillon. DFlash2, un brouillon à diffusion par blocs de cinq couches pour Qwen3.8-27B, exige vLLM 0.28.0; nous avons mis l'image à jour et mesuré MTP contre DFlash2 à 1, 2, 4, 8 et 16 flux simultanés, à trois longueurs de brouillon.
- Le résultat. Avec un bloc de cinq tokens, chaque pas du modèle cible rapporte 3,45 tokens acceptés contre 2,55 (+35 %), si bien que le décodage est à 28,5 tokens/s en flux unique contre 20,8 (+37 %), à 91 contre 81 à quatre flux, à 216 contre 203 à seize. Là où notre plateforme tourne réellement, un ou deux agents de codage à la fois, c'est un tiers de plus par flux.
- L'estimation que nous avons ratée. Nous avions prédit 1,6-2,4× parce que le nouveau brouillon lit 3,85 Go par passage. Le pas n'est pas devenu plus rapide du tout : 121 ms avant, 121 ms après. Chaque token gagné vient de plus de tokens acceptés par pas - 3,45 contre 2,55, +35 % - pas d'un pas plus rapide.
- Le coût. 3 Gio de poids, un cinquième du budget KV (3,2 contextes de 262K simultanés au lieu de 3,9), un démarrage à froid de sept minutes, et le nouvel exécuteur de modèle V2 de vLLM.
- En service. Qwen3.8-27B NVFP4 avec un brouillon DFlash2 de cinq tokens sur vLLM 0.28.0, les quatre conteneurs sur la nouvelle image. Le repli sur MTP tient en une ligne dans un fichier.
Ce que dit l'article, confronté à la machine
L'argument de l'article est le classique, et il est juste : générer un token, c'est lire chaque poids une fois pour une poignée d'arithmétique, si bien que le décodage est borné par la bande passante mémoire pendant que les unités de calcul chôment; un petit brouillon peut deviner plusieurs tokens d'avance, et le gros modèle peut tous les vérifier en un seul passage pour à peu près le prix d'un, en gardant les devinettes qui concordent. Le gain, c'est la longueur d'acceptation - combien de tokens du brouillon survivent par pas - et elle dépend de la charge de travail (le code et l'extraction acceptent bien, la prose ouverte non), de la température d'échantillonnage (plus haute, elle aplatit la distribution et abaisse l'acceptation) et de la charge (sous un gros lot, le calcul libre que l'astuce dépense n'est plus libre). L'article énumère quatre sources possibles pour un brouillon : un petit modèle séparé, des têtes de prédiction entraînées dans le gros modèle, une copie moins coûteuse du même modèle, et une recherche dans le texte déjà vu.
Nous avons passé cette liste en revue face à ce qui tournait. Les têtes de prédiction : c'est la tête MTP de Qwen, déjà active, et les compteurs de vLLM disaient ce qu'elle valait sur du vrai trafic - 208 647 tokens proposés, 122 270 acceptés, 2,76 tokens par pas du modèle cible. La recherche dans le texte existant (brouillon par n-grammes ou par suffixes) : vLLM n'exécute qu'un proposeur par moteur, elle remplacerait donc la tête MTP au lieu de s'y ajouter, et à 2,76 tokens par pas la tête est difficile à battre sur du code que le modèle doit écrire, par opposition à du code qu'il recopie. Un petit modèle séparé : un moins bon brouillon qu'une tête qui lit les états cachés du gros modèle lui-même, et il coûte de la mémoire. L'idée de la copie moins coûteuse (QuantSpec) : absente de vLLM. La falaise de charge : l'article dit que vLLM peut désactiver la spéculation au-delà d'une taille de lot, et c'est vrai - la forme moderne est un barème de longueurs de brouillon par taille de lot - mais sur cette machine un pas à notre plafond de 16 séquences porte au plus 64 tokens, et un 27B sur un GB10 est très loin d'être borné par le calcul en dessous d'un millier, si bien que nous n'avions aucune falaise contre laquelle nous protéger.
Ce que la vérification a fait ressortir, c'est la forme de notre trafic : 41 millions de tokens entrants pour 192 mille générés, 96 % des tokens entrants servis depuis le cache de préfixes, ce qui veut dire qu'une requête typique passe environ deux secondes sur les quatre mille tokens qu'elle doit préremplir et vingt-cinq sur les 460 qu'elle génère. Le décodage, c'est neuf dixièmes du temps. La spéculation est exactement le bon levier, et la seule chose qui restait à tirer, c'était le brouillon.
La seule chose qui restait : un meilleur brouillon
DFlash2 (z-lab, ICML 2026) est un brouillon entraîné pour Qwen3.8-27B : cinq petites couches de transformeur qui lisent les états cachés du gros modèle à cinq profondeurs et, au lieu de deviner un token à la fois, prédisent un bloc entier en un passage et laissent un petit sélecteur tracer un chemin parmi les candidats. Ses auteurs rapportent 5,5 tokens acceptés par pas sur GSM8K contre 5,0 pour la tête MTP à la même longueur de brouillon, et 3,4× par rapport au décodage simple. Il est livré comme un checkpoint de 3,85 Go et exige une architecture que vLLM a ajoutée dans la 0.28.0 - publiée, comme par hasard, ce matin-là.
Avant de le lancer, nous avons écrit l'estimation, comme la fois précédente. Notre pas MTP durait ~123 ms, dont les trois passages successifs de l'unique couche MTP comptaient, d'après l'arithmétique du balayage précédent, pour environ 20 ms chacun. DFlash2 les remplace par un passage sur 3,85 Go, soit environ 15 ms aux 273 Go/s de cette machine, et vérifier huit positions au lieu de quatre est presque gratuit sur un pas borné par la bande passante. Donc : un pas de ~100 ms, et si l'acceptation passait de 2,6 à quelque part entre 3,5 et 5, le décodage en flux unique irait de 18-20 tokens/s à 30-45. C'était la prédiction. Gardez-la en tête.
Ce que nous avons mesuré, et comment
Même sonde que dans l'article précédent, le script de mesure de notre dépôt d'infrastructure : N requêtes de génération de code simultanées à travers le proxy de production, le débit de décodage lu dans les compteurs de vLLM sur une fenêtre de 40 secondes, puis un nouveau préremplissage de 12K tokens. Deux ajouts cette fois. La sonde prend maintenant la température d'échantillonnage en paramètre, parce que le point de l'article sur la température méritait un chiffre : 0,7 est ce que tous les balayages ont utilisé jusqu'ici, 1,0 est la valeur par défaut du checkpoint et ce que notre plateforme envoie quand un client ne fixe rien. Et les points en flux unique ont été répétés, parce que les premiers chiffres de DFlash2 se dispersaient plus que prévu, et qu'une fenêtre de 40 secondes d'une seule génération n'est pas une mesure pour un brouillon dont l'acceptation dépend de ce que le modèle est en train d'écrire.
Chaque configuration est un redémarrage du même checkpoint servi (la quantification NVFP4 de Qwen3.8-27B par unsloth, 262K de contexte, 36 Gio de KV) sur la même machine, le même jour, l'une après l'autre.
Constat 1 : la mise à jour de l'image n'a rien changé, et le débit augmente encore à seize flux
vLLM 0.28.0 embarque la même pile CUDA 13.0.2, torch 2.13 et FlashInfer 0.6.16 que la 0.27.1, choisit le même noyau CUTLASS NVFP4 et la même attention FlashInfer sur ce silicium, et avec la tête MTP il décode à 20,8, 39,7, 81,2 et 124,4 tokens/s en agrégé à 1, 2, 4 et 8 flux là où la 0.27.1 faisait 19,8, 40,0, 74,9 et 127,4 - du bruit. Le préremplissage était à 2 007 tokens/s contre 2 083, une sonde chacun. La seule case nouvelle, c'est 16 flux : 202,7 tokens/s en agrégé, 1,63× le chiffre à huit flux. La falaise dont l'article nous prévient, où la spéculation se met à coûter plus qu'elle ne rapporte, n'est pas là à notre lot maximal.
Constat 2 : 35 % de tokens en plus par pas; le pas n'est pas devenu plus rapide
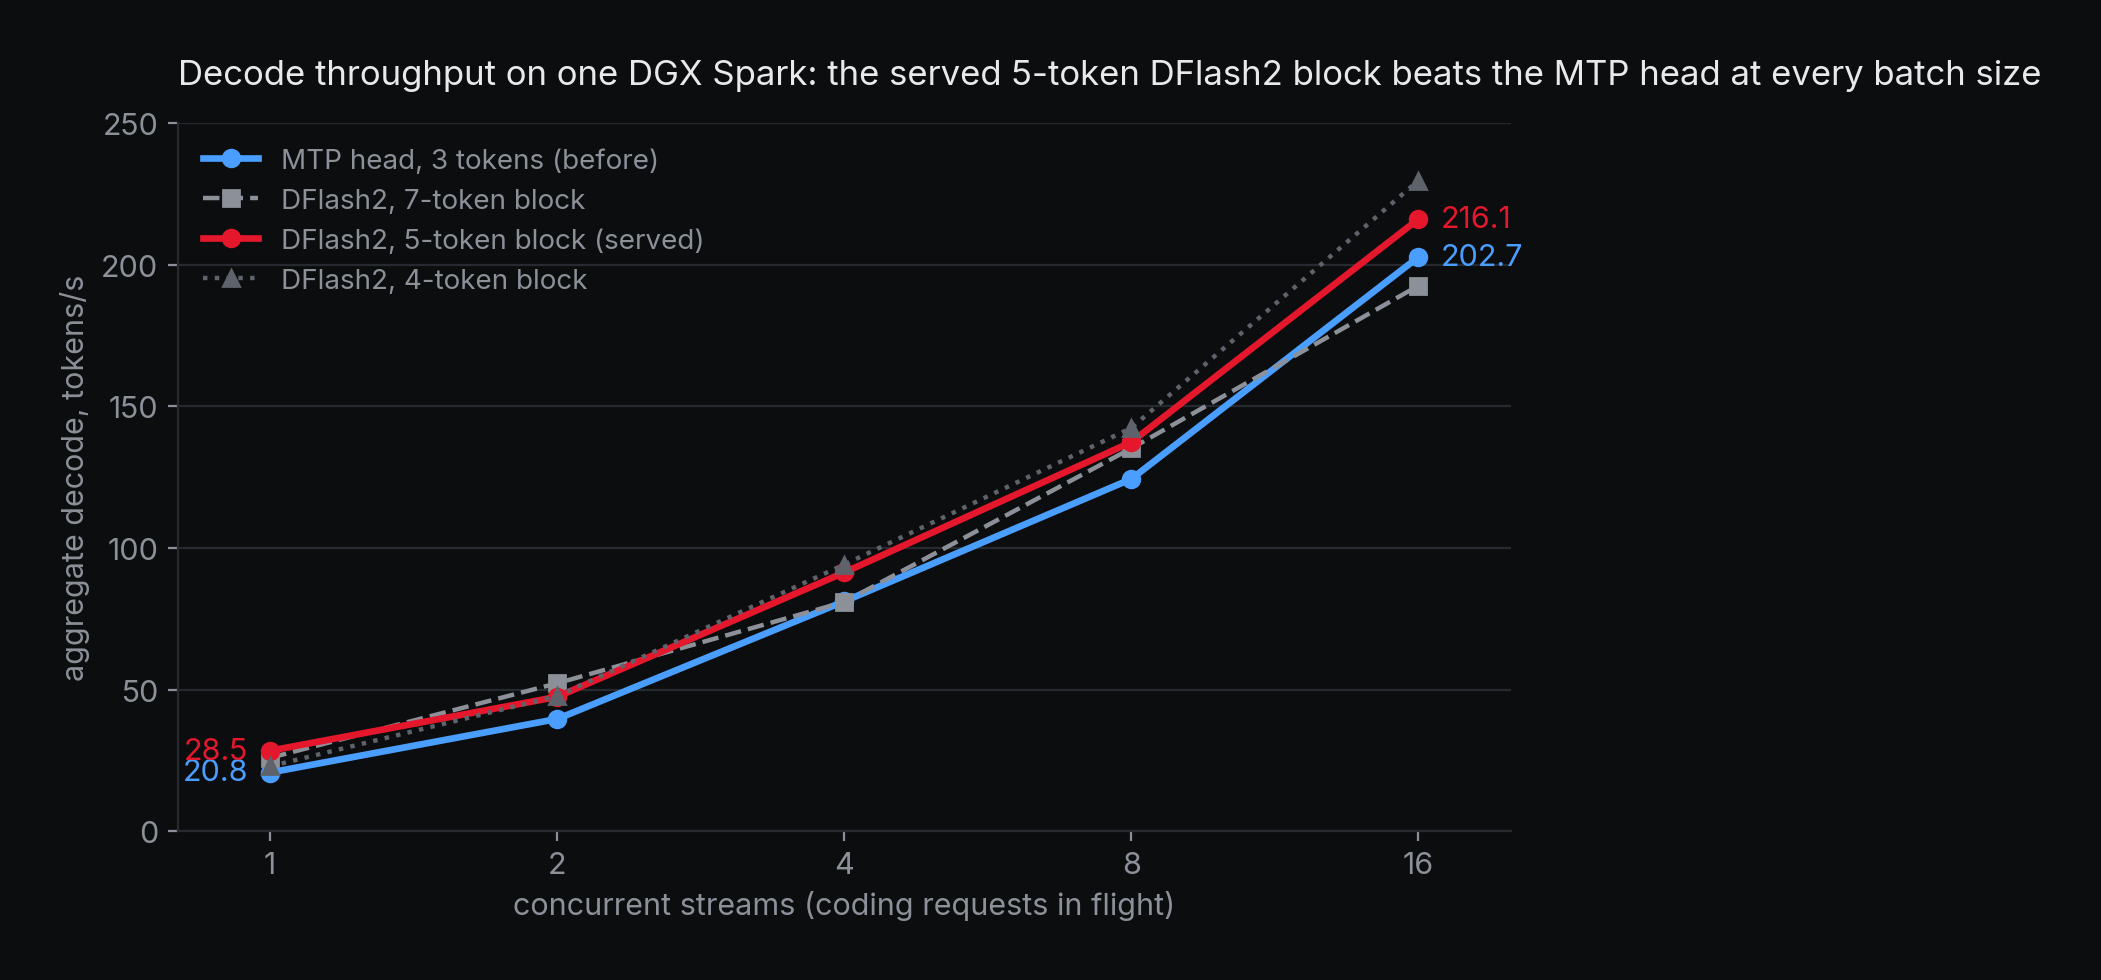
DFlash2 à son bloc natif de sept tokens de brouillon : 26,0, 52,3, 81,0, 135,2 et 192,6 tokens/s en agrégé à 1, 2, 4, 8 et 16 flux, contre 20,8, 39,7, 81,2, 124,4 et 202,7 pour MTP. En hausse de 25 % et 32 % à un et deux flux, à égalité à quatre, en hausse de 9 % à huit, et en baisse de 5 % à seize.
Puis le chiffre qui l'explique. À un flux, DFlash2 a accepté 3,16 tokens par pas et décodé 26,0 par seconde : un pas de 122 ms. MTP a accepté 2,55 et décodé 20,8 : un pas de 123 ms. Le pas est le même. Un passage d'un brouillon de cinq couches plus son sélecteur plus une vérification à huit positions coûte, sur cette machine, exactement ce que coûtent trois passages d'une seule couche MTP. Notre estimation avait tarifé le brouillon à sa bande passante, 3,85 Go en 15 ms, et oublié que le pas fait aussi tourner les couches Gated DeltaNet de Qwen sur huit positions de requête au lieu de quatre, le sélecteur, et une vérification qui n'est gratuite que tant que le lot vaut un. Tout ce que DFlash2 a gagné, il l'a gagné en acceptant plus de tokens par pas; il n'a rien gagné à être plus rapide par pas.
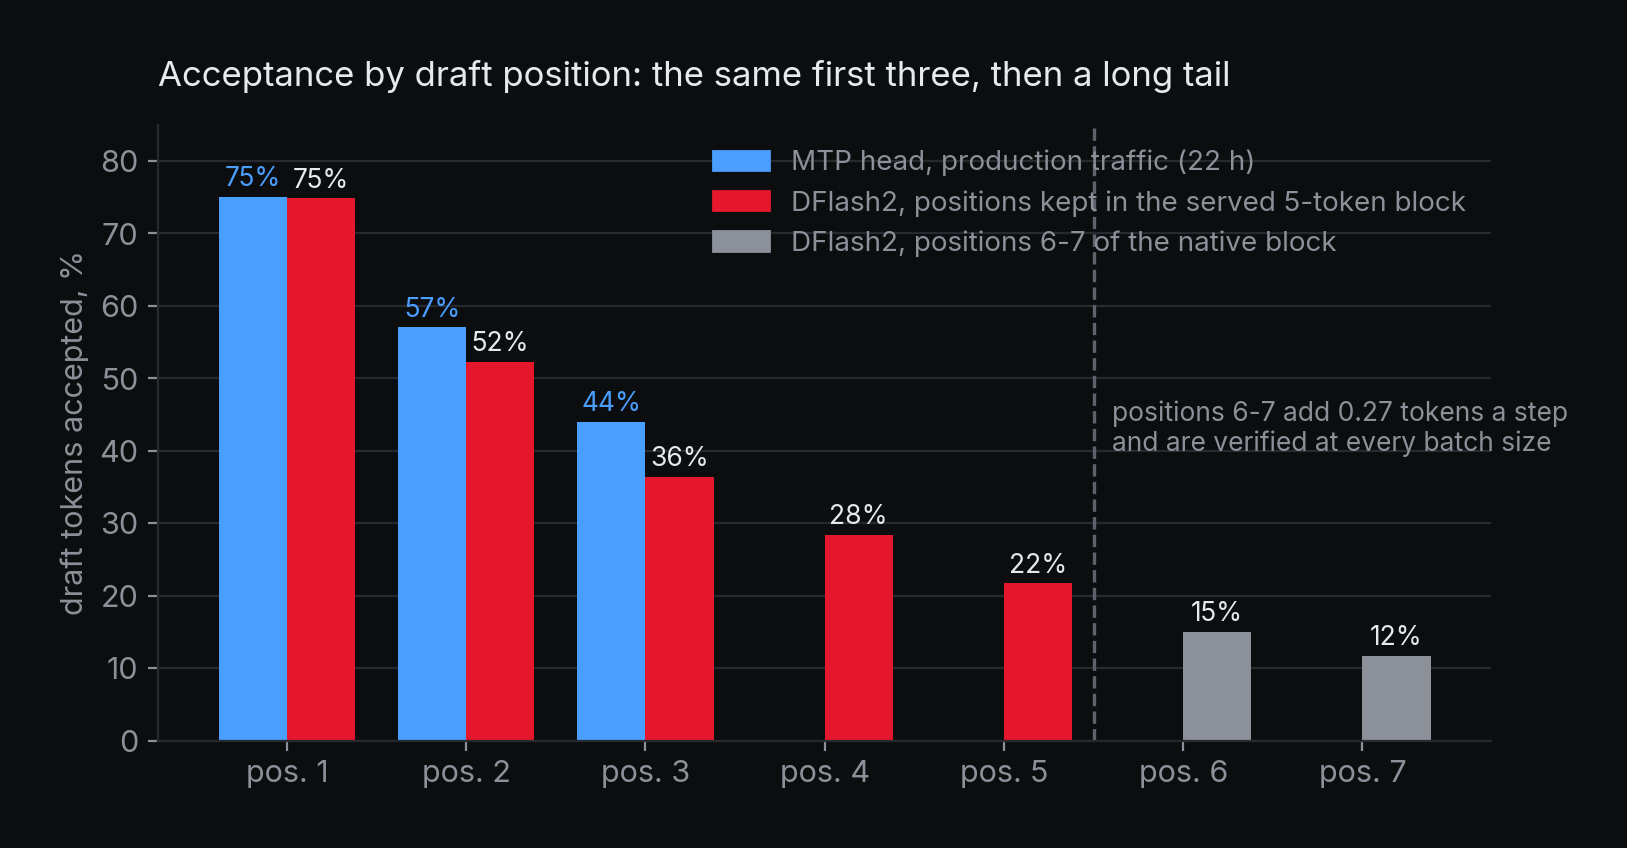
Et l'acceptation dit où le bloc devrait s'arrêter. Sur la sonde, DFlash2 place 75 %, 52 % et 36 % de ses trois premiers tokens, à peu près ce que la tête MTP place sur le trafic de production, puis 28 %, 22 %, 15 % et 12 % aux positions quatre à sept. Ces quatre positions ajoutent 0,77 token accepté par pas. À un ou deux flux, elles sont gratuites, parce que le pas est borné par la bande passante et que vérifier quatre positions de plus ne coûte aucun temps; à seize flux, une vérification de huit positions sur seize séquences, c'est 128 tokens de vrai travail par pas, et c'est ce qui a transformé +9 % à huit flux en −5 % à seize.
Constat 3 : cinq tokens par bloc donnent de meilleurs résultats que sept
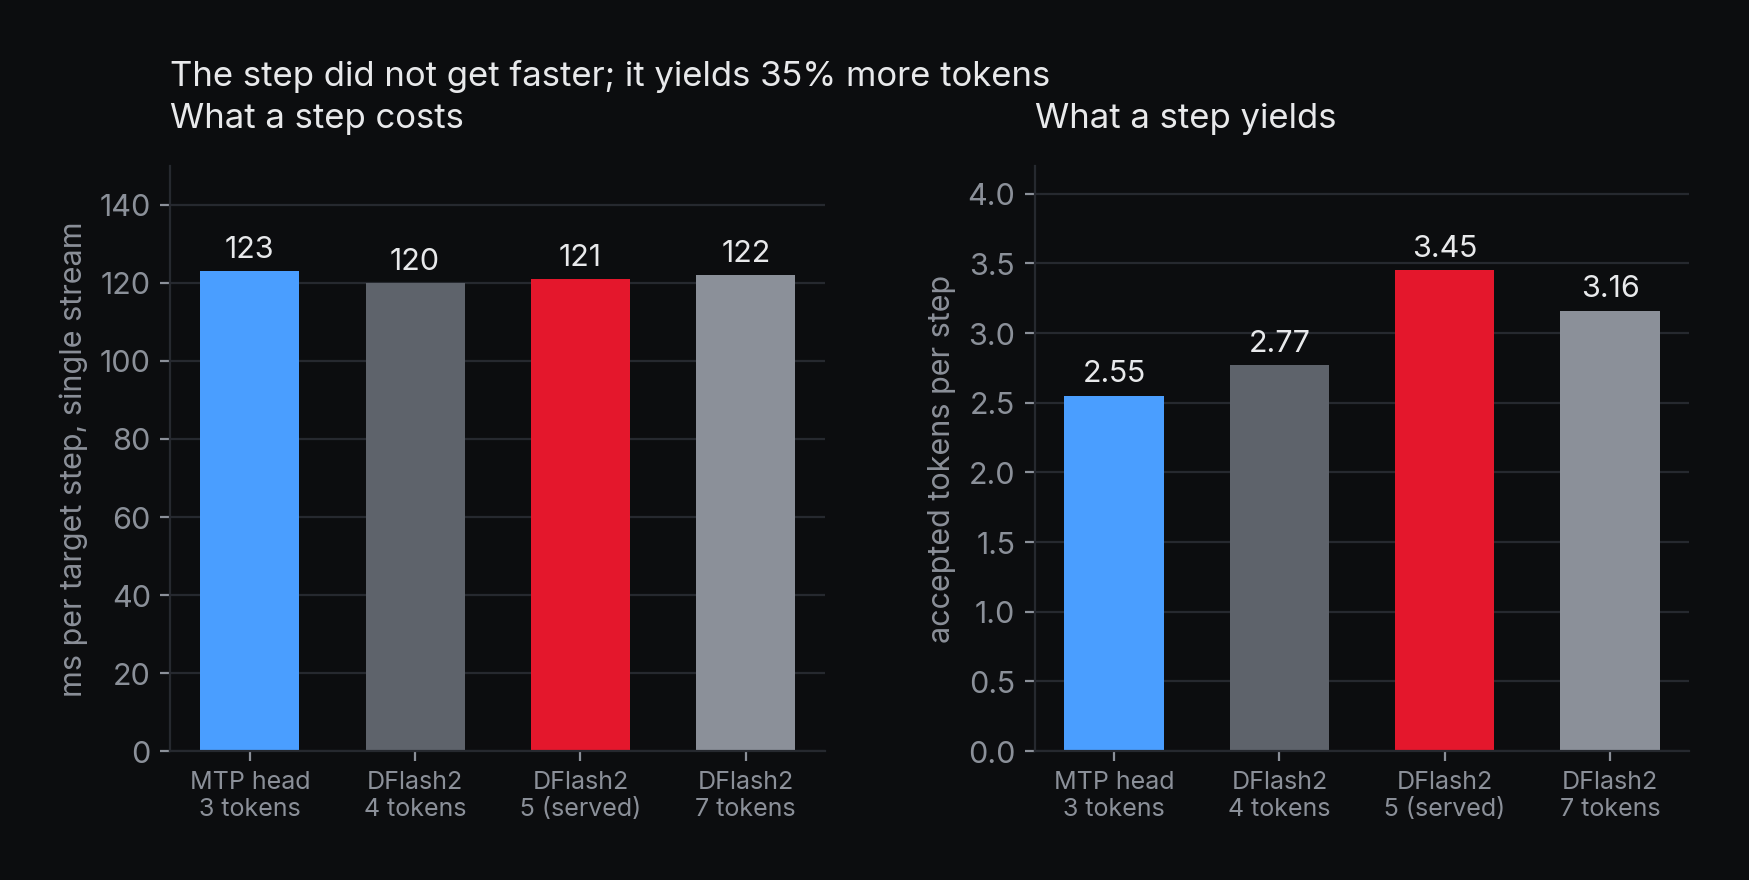
Nous avons donc mesuré des blocs plus courts. À cinq tokens de brouillon : 28,5, 47,5, 91,4, 137,4 et 216,1 tokens/s sur les cinq niveaux de simultanéité, les points à un et deux flux moyennés sur deux passes chacun. À quatre : 23,0, 47,8, 94,2, 142,4 et 229,7. Les trois blocs DFlash2 et la tête MTP tournent tous au même pas de ~121 ms; ce qui diffère, c'est le rendement - 2,55 tokens pour MTP, 2,77 à quatre, 3,45 à cinq, 3,16 à sept, en flux unique - et ce que coûte la vérification une fois que le lot grossit. Cinq est le bloc qui gagne là où vit notre plateforme, un et deux agents de codage à la fois : +37 % sur MTP à un flux. Et il garde le gain à chaque taille de lot que nous pouvons atteindre, +13 % à quatre, +10 % à huit, +7 % à seize. Quatre le devance de 3 à 6 % à partir de quatre flux et perd un cinquième à un; sept ne gagne rien que cinq ne gagne pas.
Le bouton « raccourcir le brouillon quand la simultanéité monte » de l'article existe dans vLLM sous la forme d'un barème de longueurs de brouillon par taille de lot, et l'ordonnanceur le respecte; mais le spéculateur DFlash2 de la 0.28.0 produit un bloc de taille fixe, alors nous ne l'avons pas essayé à l'aveugle sur un moteur de production. Un cinq statique fait le travail sur cette machine.
Constat 4 : la température influe sur le débit, et le client la choisit
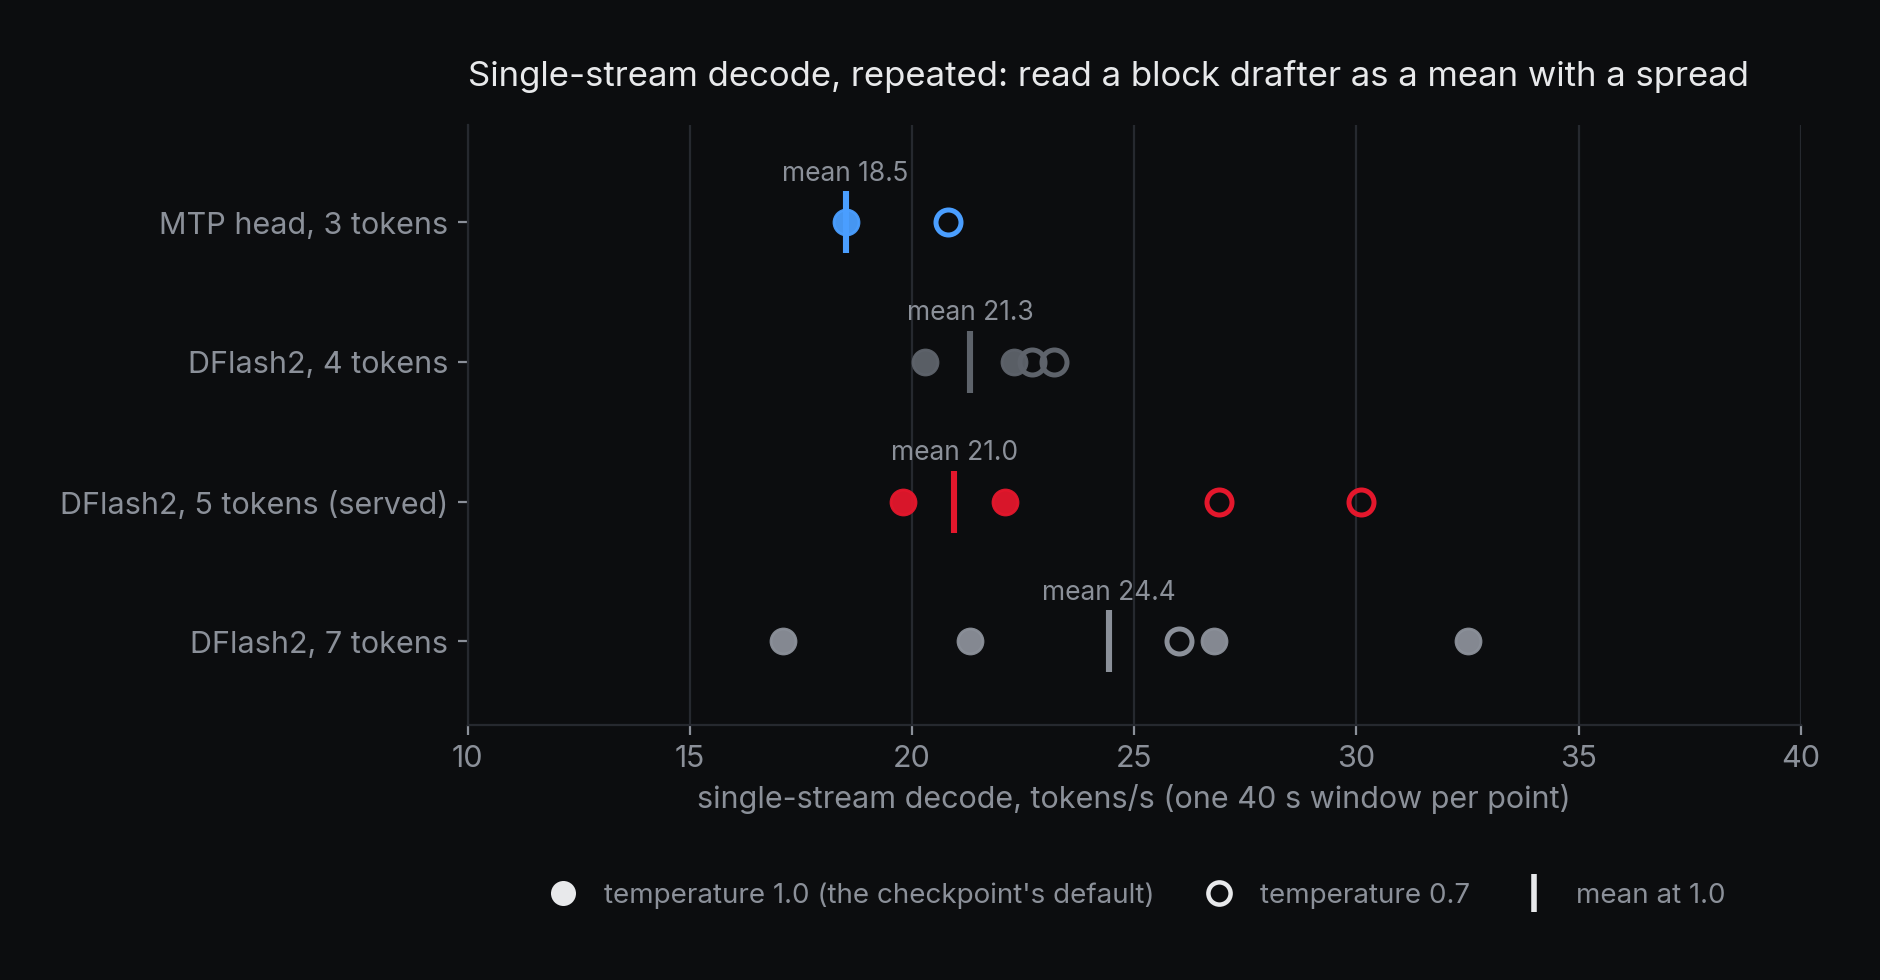
L'article dit qu'une température d'échantillonnage plus haute abaisse l'acceptation. C'est vrai, et ce n'est pas petit. À la température par défaut du checkpoint, 1,0, la tête MTP accepte 43 % au lieu de 52 % et le décodage en flux unique tombe de 20,8 à 18,5 tokens/s : 11 % pour un paramètre que la plupart des clients ne fixent jamais. DFlash2 à cette température, c'est là que la dispersion est apparue. Quatre passes en flux unique au bloc de sept tokens ont donné 32,5, 26,8, 21,3 et 17,1 tokens/s, une acceptation de 43 % jusqu'à 16 % sur la même famille d'invites, une moyenne de 24,4 et une pire passe sous les 18,5 de MTP; le bloc de cinq tokens a donné 19,8 et 22,1, le bloc de quatre 22,3 et 20,3. MTP, dont la tête est plus stable, se disperse entre 18 et 21 sur trois jours de mesures. L'acceptation d'un brouillon par blocs dépend de ce que le modèle se trouve écrire dans la fenêtre, et c'est pourquoi chaque chiffre de DFlash2 dans cet article est une moyenne avec sa dispersion, et pourquoi la sonde répète désormais ses mesures.
Côté client, un agent de codage qui fixe la température à 0,7 gagne environ un dixième de débit par rapport à la valeur par défaut, sans modification du serveur. Notre plateforme pourrait appliquer cette valeur par défaut.
Ce que cela signifie pour nos clients
Concrètement, pour les utilisateurs du point d'accès de codage :
- Les réponses s'écrivent environ un tiers plus vite. En flux unique, les tokens arrivent désormais toutes les 35 ms au lieu de 48. La réponse moyenne sur notre trafic fait environ 460 tokens, elle se termine donc en à peu près 16 secondes au lieu de 22; la réécriture d'un fichier de 2 000 tokens prend environ 70 secondes au lieu de 96.
- Le premier token arrive au même moment qu'avant. Cette attente, c'est le traitement de l'invite, que le décodage spéculatif ne touche pas : environ deux secondes par requête sur notre trafic, parce que 96 % de l'invite est déjà dans le cache de préfixes depuis le tour précédent.
- Le gain rétrécit quand la machine est occupée, mais il ne disparaît plus. Avec quatre à seize agents qui décodent en même temps, chacun obtient 7 à 13 % de plus qu'avant au lieu de 37 %. Le bloc natif de 7 tokens perdait du terrain à seize flux; celui que nous servons, non.
- Le code est exactement le même. Le décodage spéculatif n'accepte que des tokens que le modèle aurait produits de toute façon, si bien que la qualité, les appels d'outils et l'entrée d'images sont intacts, et l'appariement BigCodeBench de l'article précédent tient toujours.
- Certaines réponses semblent plus rapides que d'autres. Un modèle brouillon prédit bien le code répétitif et les modifications qui reprennent le fichier existant. Il prédit moins bien la prose ou une logique inhabituelle. Le gain de vitesse varie donc selon le contenu et s'équilibre sur une session.
- Une chose est entre les mains du client. Un agent qui envoie une température d'échantillonnage de 0,7 pour du code, au lieu de laisser la valeur par défaut du modèle à 1,0, obtient environ 10 % de plus, parce que le brouillon est accepté plus souvent quand le modèle est moins aléatoire.
Ce que ça coûte
Le brouillon, c'est 2,95 Gio de poids (la ligne de chargement de vLLM est passée de 21,97 à 24,92 Gio). Son propre cache à fenêtre glissante de 2048 tokens est taillé dans le même budget KV de 36 Gio, qui contient désormais 838 501 tokens au lieu de 1 014 892 : 3,2 requêtes simultanées de 262K tokens au lieu de 3,9. Le démarrage à froid prend sept minutes au lieu de six. Et la 0.28.0 impose son exécuteur de modèle V2 pour un brouillon DFlash2, un chemin de code plus récent, qui a servi la conversation, séparé le raisonnement de la réponse, analysé un appel d'outil et lu une image correctement dans les vérifications du jour même, et survécu à seize flux à sept tokens de brouillon là où la version précédente plantait à quatre flux avec quatre tokens MTP.
Ce que nous avons déployé
Qwen3.8-27B NVFP4 avec un brouillon DFlash2 de cinq tokens sur vLLM 0.28.0; les deux serveurs de plongements sur la même image; même proxy, même nom servi, mêmes 262K de contexte et 36 Gio de KV. La tête MTP reste dans le checkpoint et sa configuration reste dans la spécification sur une ligne en commentaire, parce qu'un brouillon dont l'acceptation oscille entre 16 % et 43 % sur la même invite mérite un repli qui oscille moins.
Les réserves honnêtes :
- DFlash2 a été entraîné contre les poids bf16 de Qwen; nous servons une quantification NVFP4 communautaire, et le brouillon lit des états cachés que la quantification perturbe. Une partie de la dispersion vient peut-être de là. Un brouillon entraîné sur la cible quantifiée est l'expérience que nous n'avons pas menée.
- Chaque chiffre, c'est une machine, une sonde, un jour. Les cases à un et deux flux sont des moyennes de deux à quatre passes; les autres sont des passes uniques.
- Notre estimation avait omis tout le coût d'exécution du modèle brouillon. Sur une machine à mémoire unifiée, il faut mesurer la durée d'une étape; diviser la taille des poids par la bande passante ne suffit pas.
- La qualité du code est intacte par construction - le décodage spéculatif accepte exactement les tokens que le gros modèle aurait produits - si bien que l'appariement BigCodeBench de l'article précédent tient toujours.
Ce que la journée nous a rapporté, au-delà du chiffre
Un tiers de plus par flux, c'est le titre, mais l'infrastructure en ressort avec davantage : l'image est sur vLLM 0.28.0 avec la procédure de mise à jour exercée de bout en bout; la sonde prend une température et répète ses mesures; les compteurs de production nous donnent désormais la longueur d'acceptation du vrai trafic, le chiffre à surveiller maintenant que le brouillon rencontre des agents plutôt qu'une invite sur les arbres rouge-noir; et quarante et un bacs à sable d'évaluation restés de la passe BigCodeBench de la semaine précédente ont disparu de la machine. Le prochain levier est documenté plutôt que deviné : la vérification par blocs, une règle d'acceptation sans perte qu'expose l'exécuteur V2, et un brouillon apparié aux poids quantifiés.