Kev, un modèle du calibre de Jev, est disponible sur CARouter (+ benchmarks)
Kev 4B, un modèle de décision ouvert qui répond à des questions typées comme le fait Jev de TypeSafe, s'appelle désormais sur /v1/decisions, depuis notre propre matériel au Canada. Sur des requêtes tenues à l'écart de tous nos choix de conception, il a nommé le bon type de tâche 98,5 % du temps, et choisir un modèle à partir de ses réponses a donné un résultat à deux requêtes près du meilleur modèle unique, pour 25 % de coût en moins.
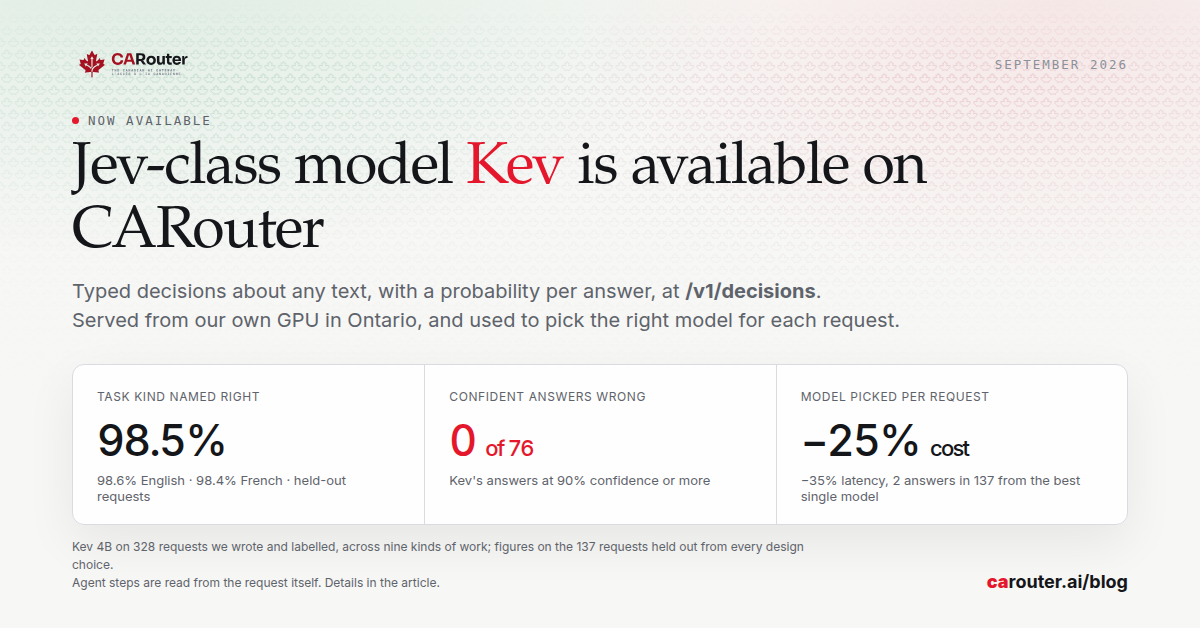
Kev 4B est maintenant disponible sur CARouter, à l'adresse /v1/decisions. C'est un modèle de décision : il lit un texte et répond à des questions typées à son sujet, avec une probabilité pour chaque réponse, comme le fait Jev, le service hébergé de TypeSafe. Il tourne sur notre propre matériel, au Canada.
Nous l'avons mesuré sur 328 nouvelles requêtes en anglais et en français, puis nous nous sommes servis de ses réponses pour choisir un modèle pour chaque requête parmi les modèles conversationnels que nous servons. Voici ce qu'il réussit, ce qu'il coûte, et ce que vaut un choix de modèle fait de cette façon.
En bref
- Sur les 137 requêtes tenues à l'écart de tous nos choix de conception, Kev a nommé le bon type de tâche 98,5 % du temps : 98,6 % en anglais et 98,4 % en français.
- Kev a donné 76 de ces réponses avec au moins 90 % de confiance, et aucune n'était fausse.
- Choisir un modèle pour chaque requête à partir des réponses de Kev donne un résultat à deux requêtes près du meilleur modèle unique, pour 25 % de coût et 35 % d'attente en moins.
- Une décision à trois questions prend 146 millisecondes sur une requête courte et 1,2 seconde sur une requête de 4 000 mots.
- Il coûte 0,0532 $ CA par million de tokens en entrée, et la sortie est gratuite.
Ce que fait Kev
Un modèle conversationnel répond par des phrases qu'il faut ensuite lire. Kev, lui, n'écrit jamais rien. Vous lui envoyez un état, texte ou objet JSON, avec jusqu'à 32 questions de trois types : un choix parmi des options nommées, une note sur une échelle ordonnée, ou un oui ou non.
Chaque réponse revient avec ses probabilités et un niveau de confiance. Kev lit tout en une seule passe et ne génère rien : il ne peut donc pas inventer une réponse qui ne figure pas parmi vos options.
Voici un courriel adressé au service à la clientèle, soumis à Kev avec trois questions.
curl https://carouter.ai/v1/decisions \
  -H "Authorization: Bearer $CAROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "kev-4b",
    "state": "Hi, I was charged twice for invoice 2026-0417 this month. Can you refund the second charge before Friday? Our accounts close then.",
    "questions": {
      "intent": {"type": "choice", "instructions": "What is the customer asking for?",
                 "criteria": {"refund": "money back for a charge",
                              "invoice_copy": "a copy of an invoice",
                              "cancellation": "ending their subscription"}},
      "urgent": {"type": "noul", "instructions": "Does the customer need an answer within the week?"},
      "tone":   {"type": "score", "instructions": "How upset is the customer?",
                 "criteria": ["calm", "annoyed", "angry"]}
    }
  }'
Kev a répondu que le client veut un remboursement, avec une probabilité de 98 %, que la demande est urgente, à 88 %, et que le client est agacé plutôt que fâché. Il a lu 111 tokens pour y arriver.
{
  "object": "decision",
  "model": "kev-4b",
  "answers": {
    "intent": {"type": "choice", "choice": "refund", "confidence": 0.9752,
               "probabilities": {"refund": 0.9835, "invoice_copy": 0.0077, "cancellation": 0.0088}},
    "urgent": {"type": "noul", "noul": 0.8772},
    "tone":   {"type": "score", "score": 1.1696, "confidence": 0.8253,
               "legend": {"0": "calm", "1": "annoyed", "2": "angry"},
               "probabilities": {"0": 0.0899, "1": 0.6507, "2": 0.2594}}
  },
  "usage": {"prompt_tokens": 111, "total_tokens": 111},
  "served_region": "CA-ON"
}
La requête reprend le format de l'API SystemOne de TypeSafe, avec en plus le champ model que porte toute requête CARouter. L'état peut compter jusqu'à 8 192 tokens. Au-delà, Kev refuse la requête plutôt que de la tronquer, car il garderait le début d'un long texte et en perdrait la fin.
Les mêmes réponses que pendant notre recherche
Avant d'ouvrir Kev à nos clients, nous avons rejoué les 1 020 requêtes de notre benchmark précédent sur la machine qui le sert maintenant. Il a choisi la même réponse que la machine de test pour 1 017 d'entre elles, et sa justesse est identique à la troisième décimale, dans les deux langues.
Les trois écarts étaient des quasi-égalités, sous 45 % de confiance sur l'une comme sur l'autre machine. Le modèle que vous appelez est bien celui que nous avons mesuré.
Un nouveau benchmark, plus proche du vrai travail
Les jeux de données publics ne contiennent pas ce que nos clients envoient : une revue de code, une question de taxes sur une facture québécoise, la prochaine étape d'un agent après le résultat d'un outil, une loi ou un communiqué statistique collé au complet. Nous avons donc rédigé 328 requêtes de ce genre, moitié en anglais, moitié en français.
Le français a été écrit pour un lecteur du Québec ou de l'Ontario, et non traduit de l'anglais. Les longs documents proviennent de sources sous licence ouverte, comme des lois fédérales, des communiqués de Statistique Canada, Wikipédia et des livres du domaine public. Chaque requête indique d'où viennent ses mots.
Nous avons posé à Kev les trois questions dont un sélecteur automatique de modèle a besoin : de quel type de tâche il s'agit, à quel point elle est difficile, et si une bonne réponse sera longue. Il voyait le début des instructions, le nom des outils, ainsi que le début et la fin du dernier message, ou la tâche de l'utilisateur quand ce message est le résultat d'un outil.
Nous avons écrit ces questions et les règles d'aiguillage sur trois cinquièmes des requêtes. Tous les chiffres qui suivent viennent des deux autres cinquièmes : 137 requêtes qu'aucun de ces choix n'avait vues.
Ce que nous avons trouvé
Kev a nommé le bon type de tâche 98,5 % du temps sur ces 137 requêtes. Il a eu juste sur toutes les requêtes dans sept des neuf types, et n'a manqué qu'une requête de recherche et une requête de conversation.
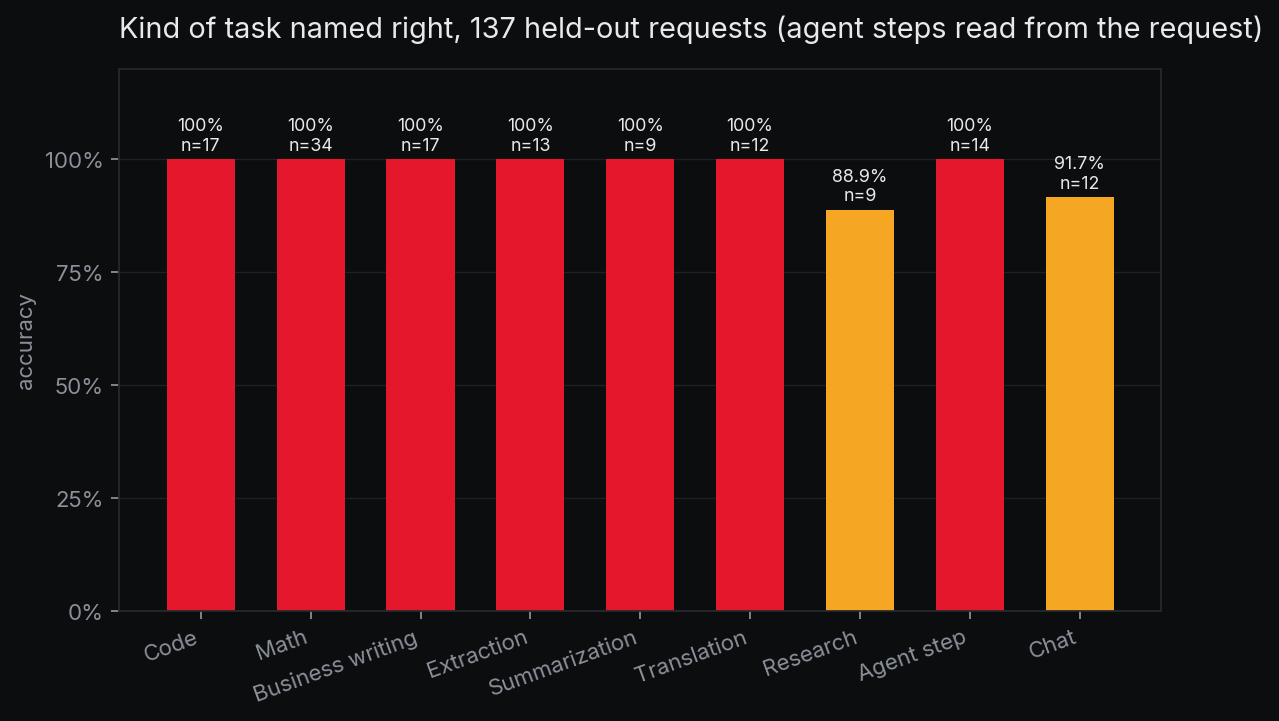
Les étapes d'agent sont lues dans la requête elle-même. Une requête qui porte des définitions d'outils est une étape du travail d'un agent, et le routeur le voit comme il voit la langue et la longueur. Kev seul n'en reconnaissait que la moitié, car le dernier message est le résultat d'un outil qui ressemble à du code ou à une page web.
La frontière entre une question rapide et une question de recherche relève du jugement, et les étiquettes sont les nôtres. Une autre personne aurait pu déplacer ces deux chiffres de quelques points.
Franc sur ses doutes
Pour un modèle qui décide à la place de quelqu'un, le chiffre qui compte le plus est la fréquence à laquelle il se trompe en étant sûr de lui. Kev a donné 76 réponses avec au moins 90 % de confiance, et les 76 étaient justes.
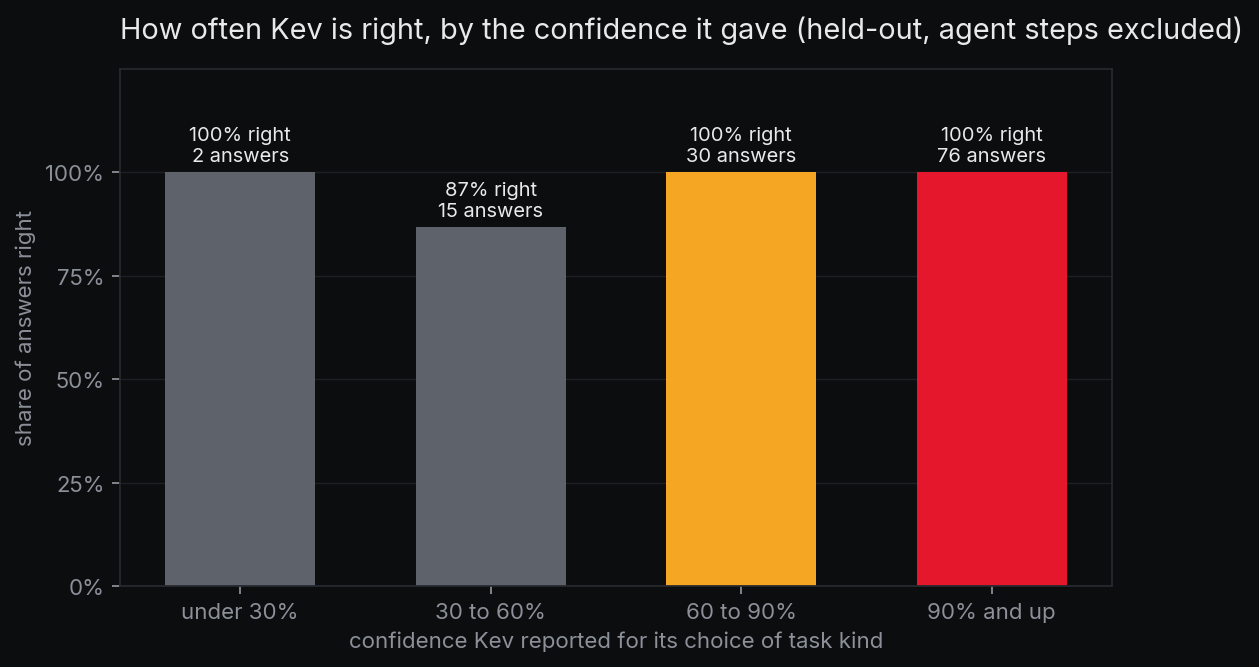
Toutes les réponses que Kev a données avec au moins 60 % de confiance étaient justes, et 86 % de ses réponses ont atteint ce seuil. En dessous, un sélecteur devrait envoyer la requête vers un modèle par défaut plutôt que de se fier à cette lecture.
Difficulté et réponses longues
Kev situe une requête à un niveau près de notre cote de difficulté 85 % du temps. C'est la moins précise des trois lectures, et notre table d'aiguillage ne s'en sert pas encore.
Une requête qui annonce elle-même sa longueur, par exemple au moins 1 000 mots ou un module complet, est lue comme demandant une réponse longue d'après sa formulation. Avec Kev, cela a permis de repérer 3 des 5 requêtes tenues à l'écart qui en demandent une ; les réponses longues demandent encore du travail.
Choisir le modèle de chaque requête
Nous avons ensuite soumis chaque requête aux quatre modèles conversationnels que nous servons depuis le Canada : Qwen3.6 35B A3B et Qwen3 0.6B sur notre propre matériel, ainsi que Tofino 3 et Rosedale 1 d'Augure. Chaque réponse a été notée par un test, un résultat exact ou une grille d'évaluation.
Le code a été exécuté contre ses tests, et les mathématiques et l'extraction comparées à la bonne réponse. La prose a été notée selon une grille par Qwen3.6 35B A3B, réflexion désactivée : ce juge a recalé 2 des 122 bonnes réponses et n'a laissé passer aucune des 122 mauvaises.
À partir des trois cinquièmes servant à la conception, nous avons écrit une table d'aiguillage par type de travail. Tofino 3 prend les étapes d'agent, les mathématiques, la traduction et la conversation, où il égale ou devance les autres en quelques secondes et pour une fraction du prix. Qwen3.6 prend tout le reste, ainsi que toute requête sur laquelle Kev hésite.
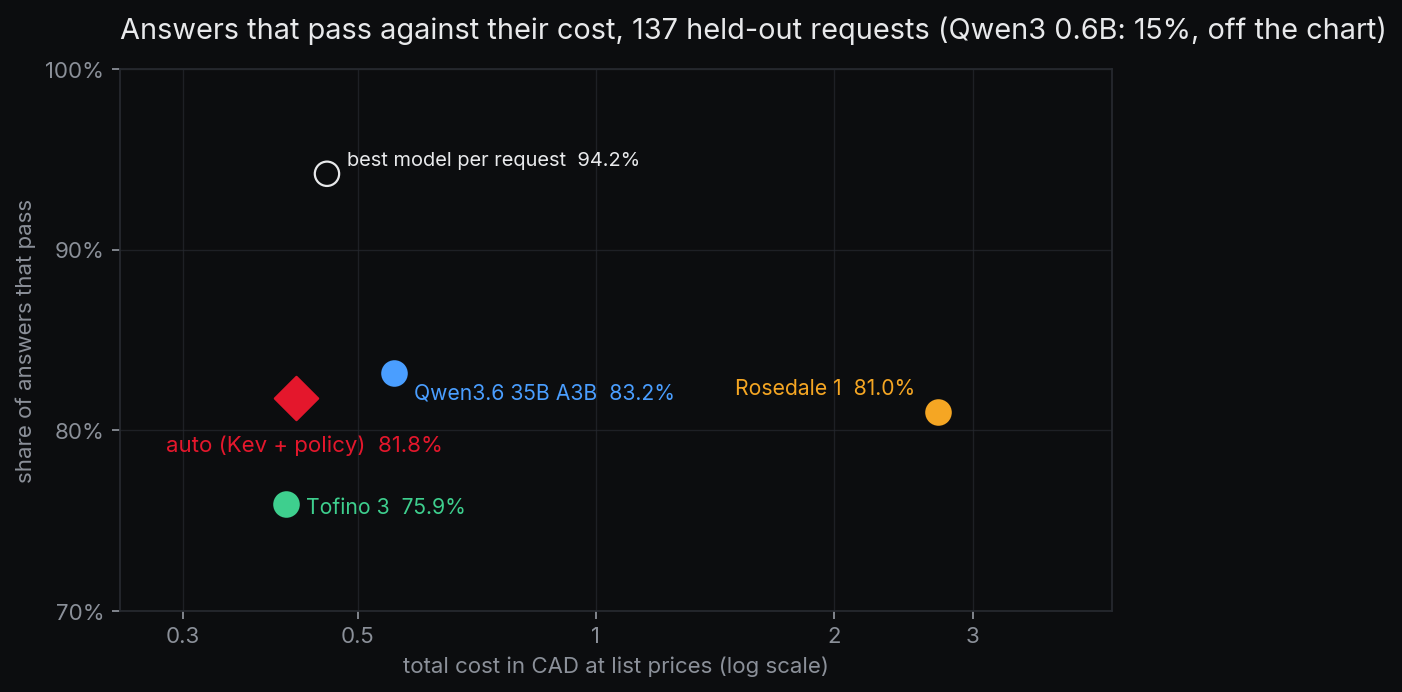
Sur les 137 requêtes tenues à l'écart, le choix du modèle avec Kev a donné 81,8 % de réponses réussies, contre 83,2 % pour le meilleur modèle unique, Qwen3.6. C'est deux requêtes d'écart, pour 25 % de coût en moins, et chaque réponse a pris 33 secondes en moyenne au lieu de 51.
Le plafond est plus haut. Choisir après coup le meilleur modèle pour chaque requête donnerait 94,2 % de réponses réussies : une table par type de travail laisse donc de la qualité qu'une politique plus fine pourrait récupérer.
Vitesse et coût
Kev tourne sur un NVIDIA GB10 en Ontario, qui sert aussi nos autres modèles ouverts. Il occupe moins de 9 Go de mémoire et traite une requête à la fois.
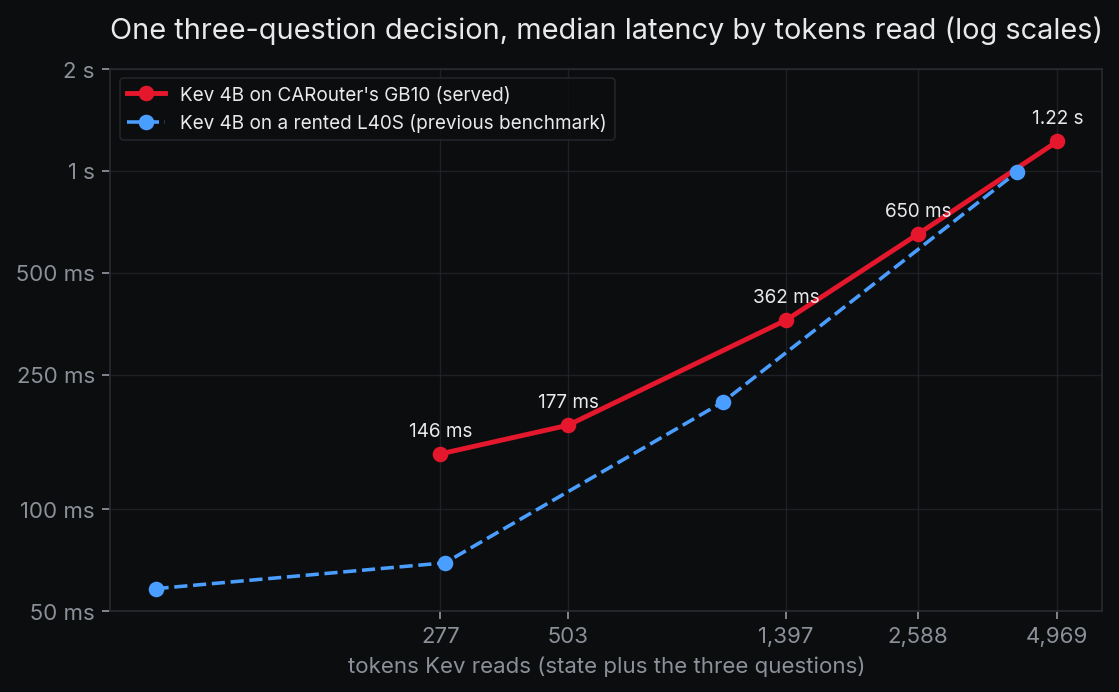
Une décision courte prend environ 150 millisecondes, et une requête de 4 000 mots, environ 1,2 seconde. Le GPU de centre de données de notre test précédent était plus rapide sur les requêtes courtes, et proche sur les longues.
Le prix est de 0,0532 $ CA par million de tokens en entrée, et la sortie est gratuite. C'est le prix que TypeSafe publie pour Jev, moins dix pour cent. Une décision à trois questions sur une requête de 500 tokens coûte moins de trois millièmes de cent.
Kev facture chaque token qu'il lit : l'état une fois, puis chaque question avec ses options. TypeSafe ne publie pas la façon dont Jev compte ses tokens : les deux prix sont donc proches, sans qu'on puisse les dire identiques.
Confidentialité
Kev ne conserve rien. Chaque requête est lue une fois, puis oubliée avec sa réponse. Rien n'est partagé entre clients, pas même un cache dont les délais pourraient trahir ce qu'un autre a envoyé.
Les requêtes sont servies au Canada. Avec une clé qui exige notre filtre de renseignements personnels, ceux que contient l'état sont pseudonymisés avant que Kev ne les voie.
Ce que cela ne prouve pas
- Il s'agit d'une seule exécution, sur 328 requêtes que nous avons rédigées et étiquetées nous-mêmes, et les chiffres viennent des 137 tenues à l'écart. Dans un type qui compte 10 requêtes tenues à l'écart, chaque erreur fait bouger le chiffre de dix points.
- Le juge est aussi l'un des quatre modèles qu'il note, ce qui pourrait avantager Qwen3.6 sur la prose. Nous avons vérifié le juge sur des réponses que nous savions justes ou fausses, pas sur des erreurs subtiles.
- La sélection a été simulée à partir des réponses de Kev et de notre table d'aiguillage. Le mode auto de notre plateforme devra réussir le même test avant de choisir quoi que ce soit pour vous.
- Les latences ont été mesurées par un client situé sur la même machine. Une requête qui passe par notre API depuis ailleurs au Canada y ajoute le temps réseau.
Et ensuite
Kev est la première moitié d'auto, le mode où une requête ne nomme aucun modèle et où CARouter en choisit un, au prix ou à la vitesse de votre choix. Avant qu'auto choisisse quoi que ce soit à votre place, nous voulons une politique d'aiguillage plus fine qui comble une plus grande part de l'écart avec 94 %, une meilleure détection des réponses longues, et notre propre mode auto qui réussit ce test.
D'ici là, vous pouvez appeler Kev directement pour trier des demandes de soutien, qualifier des prospects, aiguiller des requêtes, ou pour toute décision que vous préférez ne pas confier à la prose d'un modèle conversationnel. Toutes les mesures derrière cet article sont conservées, et nous les communiquerons à quiconque les demande.