Blog CARouter
Ce que nous avons mesuré, ce que nous avons changé, avec qui nous travaillons, et pourquoi - par l'équipe qui exploite la plateforme, chiffres et clauses à l'appui.
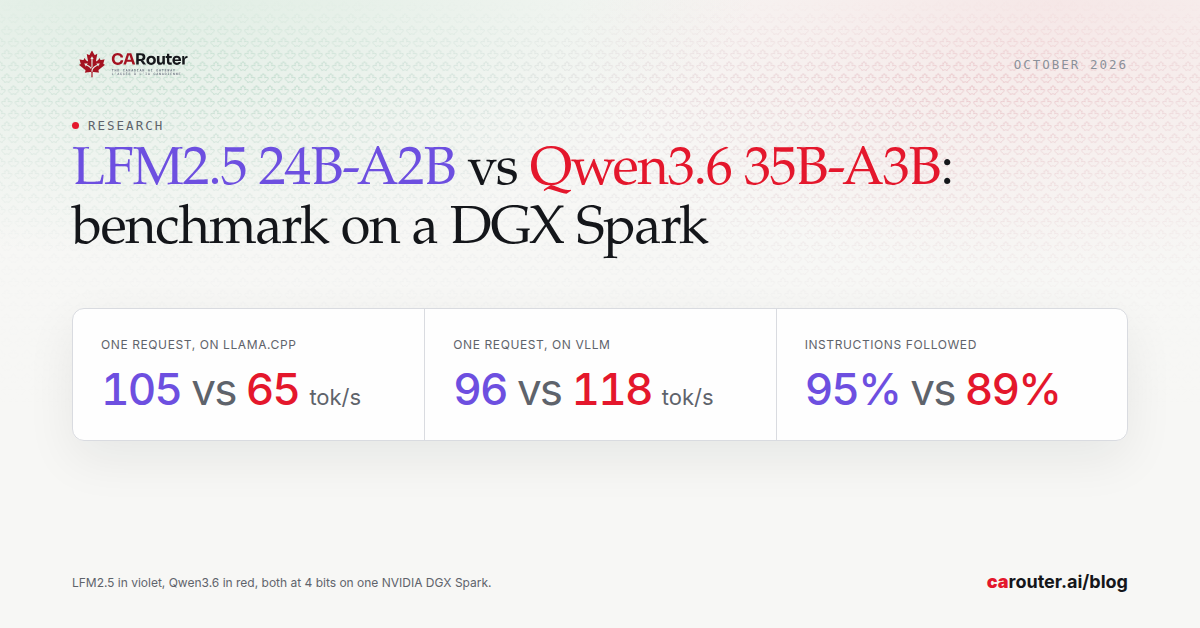
LFM2.5 24B-A2B face à Qwen3.6 35B-A3B : banc d'essai sur un DGX Spark
Liquid AI dit son nouveau LFM2.5 24B-A2B plus rapide que le Qwen3.6 35B-A3B que nous servons. Sur un DGX Spark, c'est vrai sur llama.cpp,…
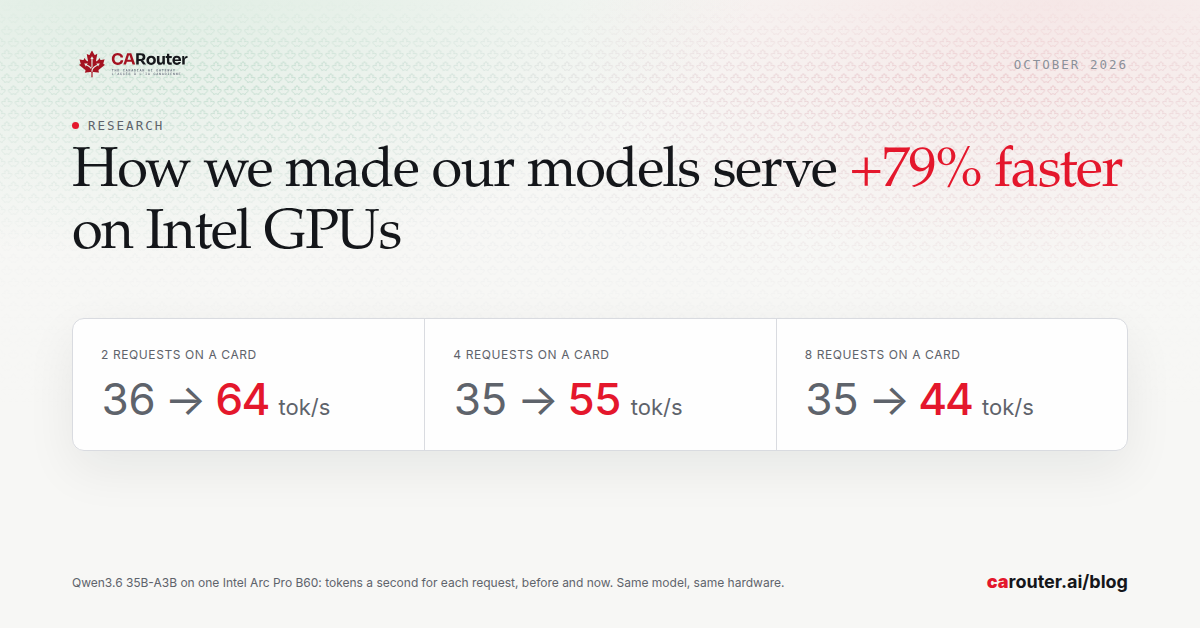
Lire l'articleComment nous avons rendu nos modèles 79 % plus rapides sur les GPU Intel
Nos deux cartes Intel Arc Pro B60 servent Qwen3.6 35B-A3B. L'essentiel de chaque étape se passait dans Python, sur le processeur du…
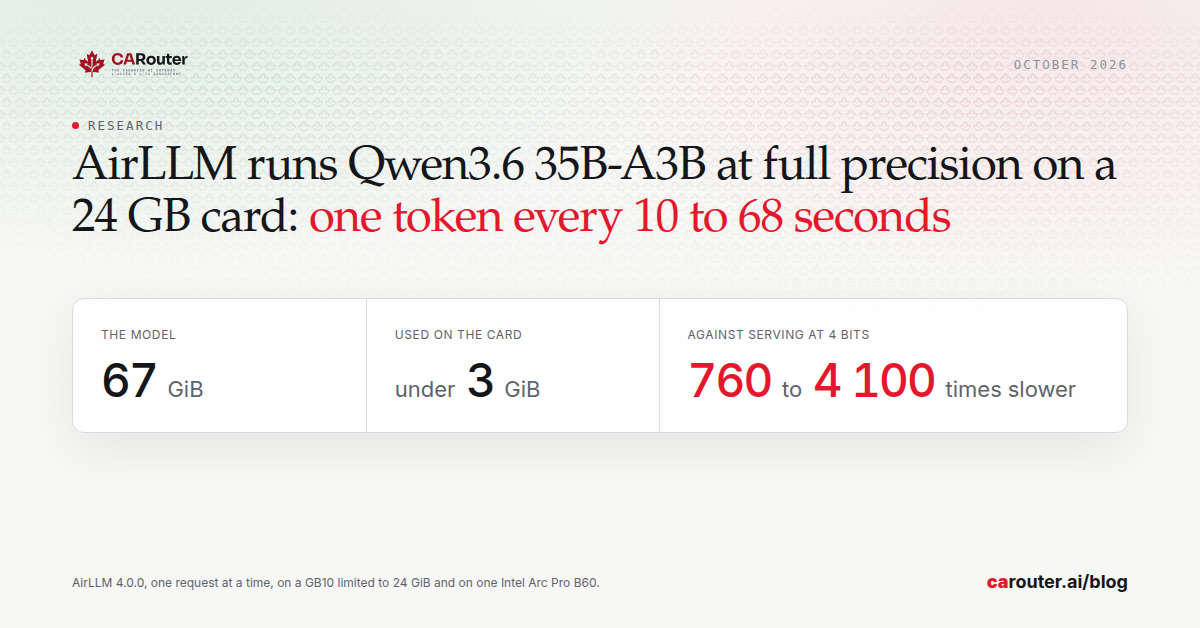
Lire l'articleAirLLM fait tourner Qwen3.6 35B-A3B en pleine précision sur une carte de 24 Go : un token toutes les 10 à 68 secondes
AirLLM est une bibliothèque libre qui fait passer un modèle par une carte graphique, une couche à la fois. Avec elle, Qwen3.6 35B-A3B en…
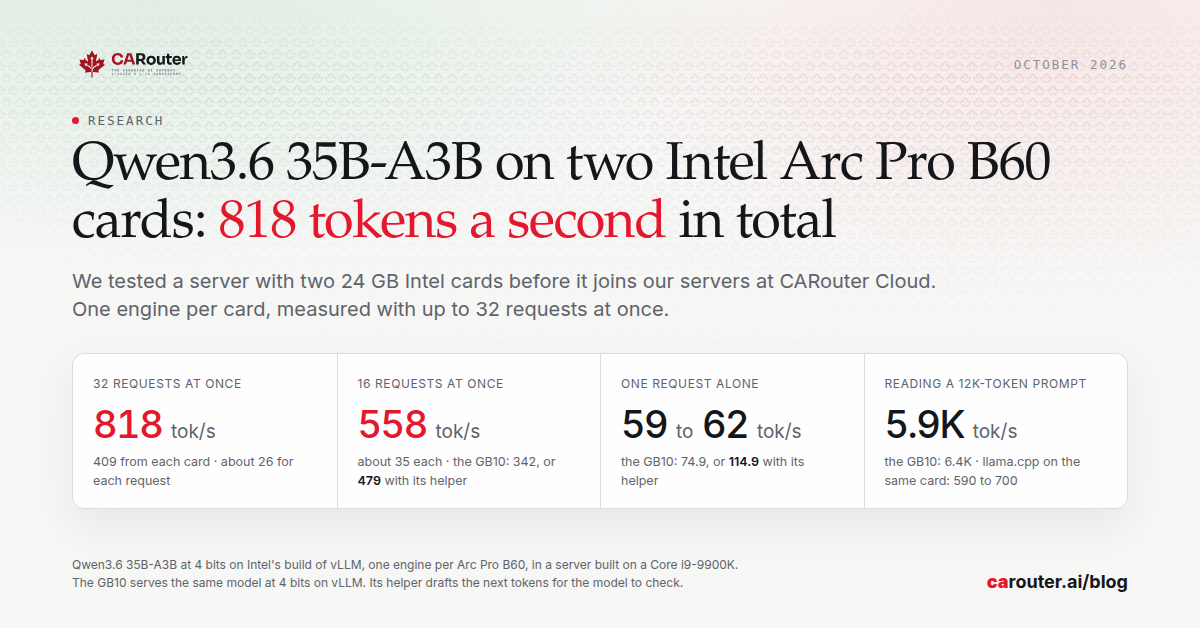
Lire l'articleQwen3.6 35B-A3B sur deux cartes Intel Arc Pro B60 : 818 tokens par seconde au total
Nous avons mis à l'essai un serveur équipé de deux cartes Intel Arc Pro B60. Avec Qwen3.6 35B-A3B à 4 bits et un moteur par carte, il écrit…
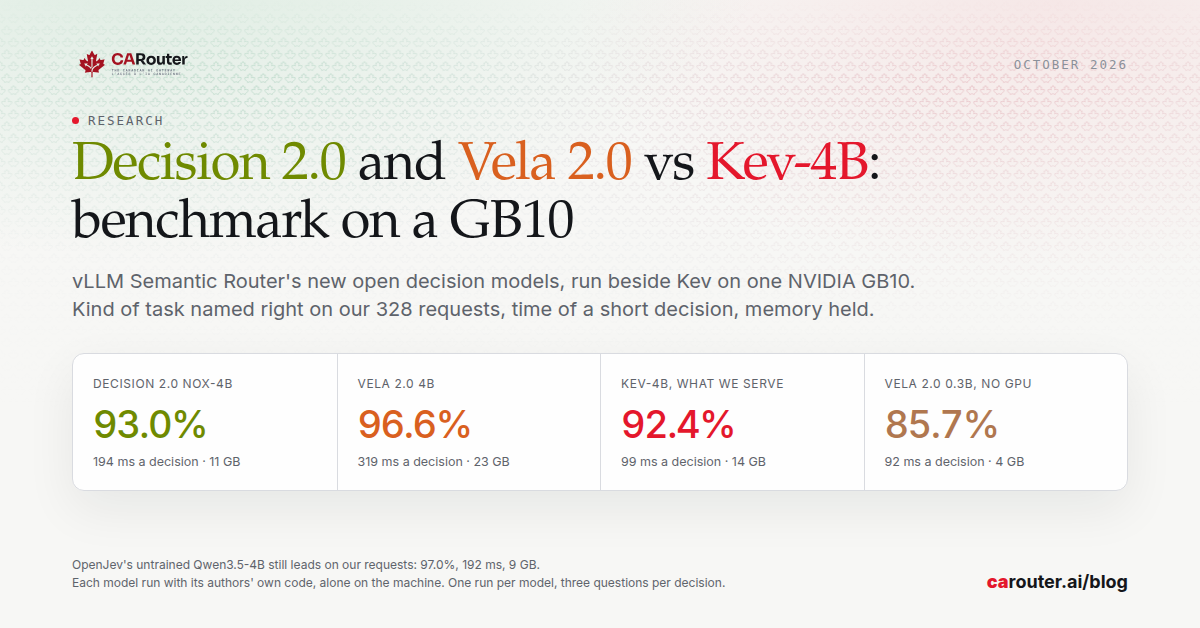
Lire l'articleDecision 2.0 et Vela 2.0 contre Kev-4B : benchmark sur un GB10
vLLM Semantic Router a publié deux familles de modèles de décision ouverts, Decision 2.0 et Vela 2.0. Sur un GB10, Vela 2.0 4B a reconnu le…
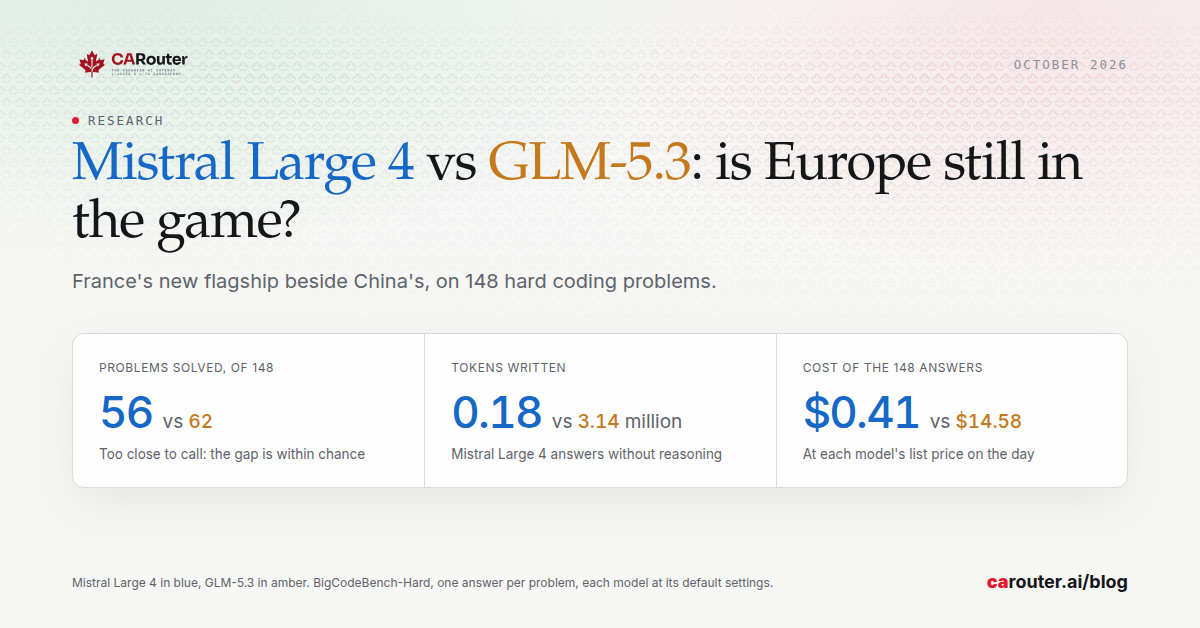
Lire l'articleMistral Large 4 face à GLM-5.3 : l'Europe est-elle toujours dans la course ?
Le nouveau modèle phare de Mistral a résolu 56 des 148 problèmes de programmation difficiles, contre 62 pour GLM-5.3, le modèle phare…
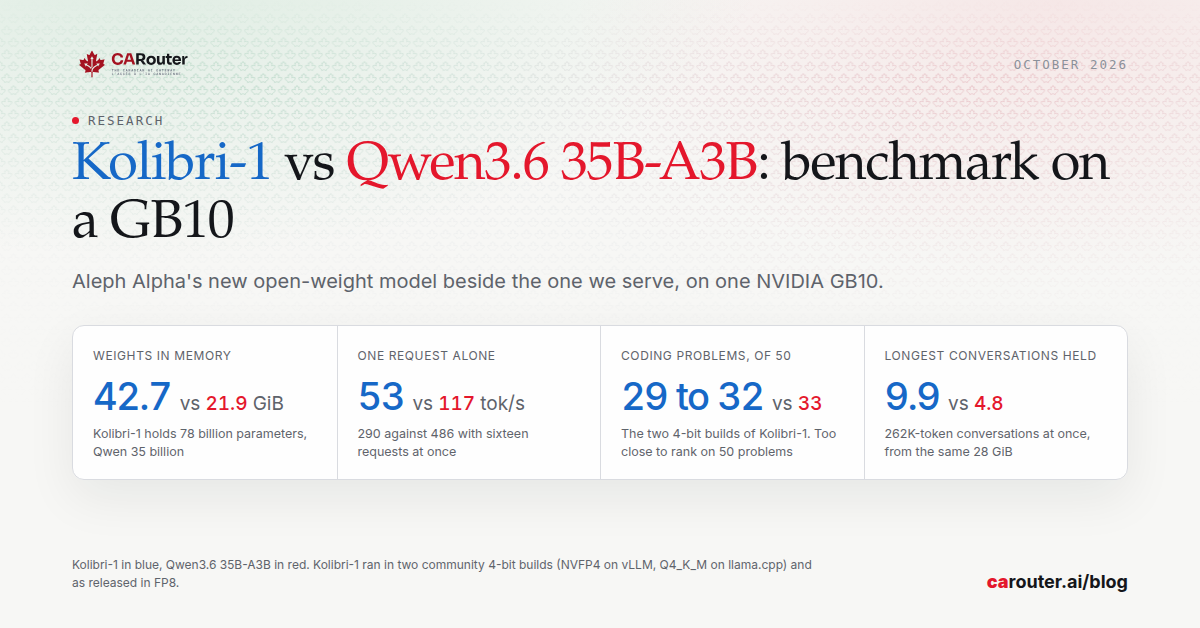
Lire l'articleKolibri-1 face à Qwen3.6 35B-A3B : banc d'essai sur un GB10
Kolibri-1, le nouveau modèle à poids ouverts d'Aleph Alpha, lit environ 3 milliards de paramètres par token, comme le Qwen3.6 35B-A3B que…
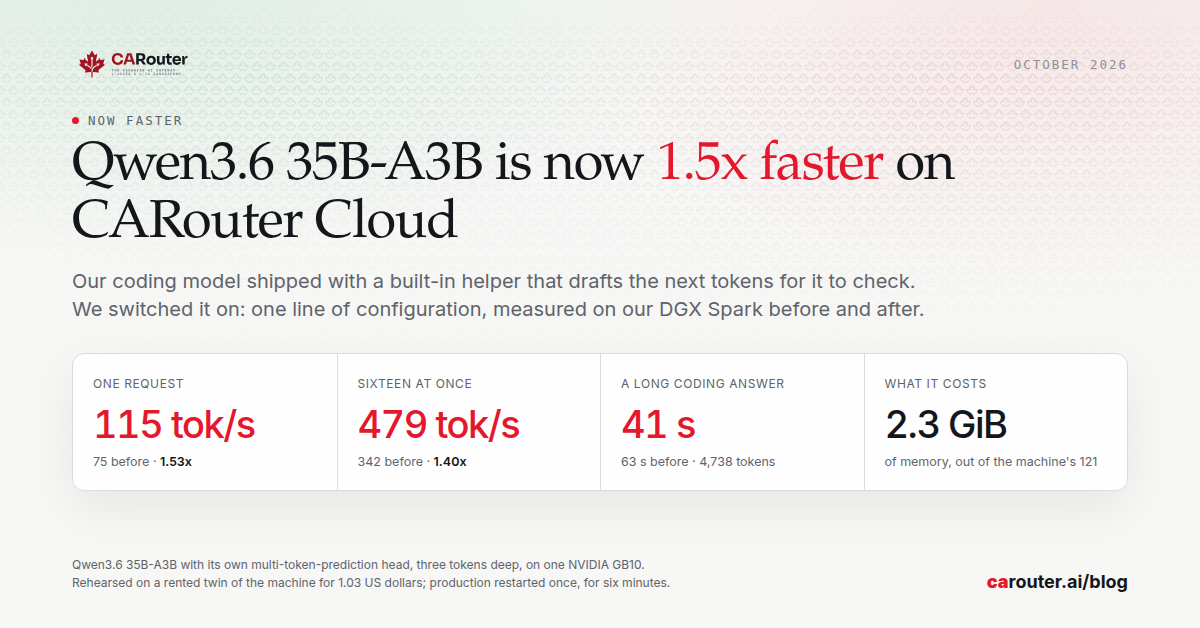
Lire l'articleQwen3.6 35B-A3B est maintenant 1,5 fois plus rapide sur CARouter Cloud
Notre modèle de programmation est livré avec un assistant intégré qui rédige les prochains tokens pour que le modèle principal les vérifie.…
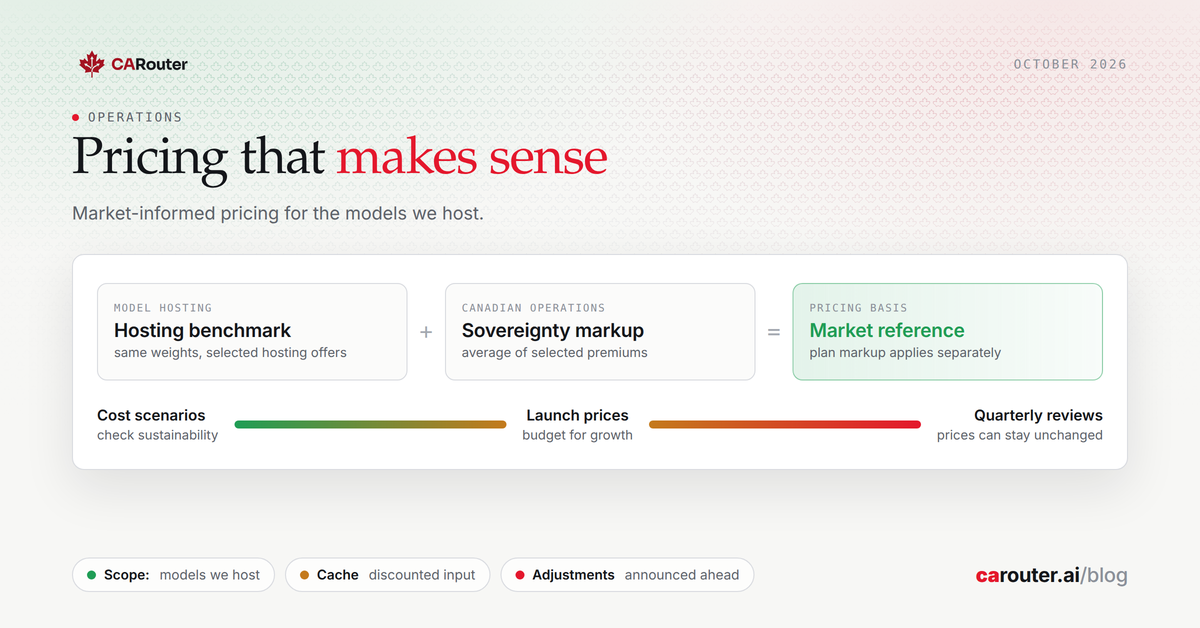
Lire l'articleUne tarification qui a du sens
Pour les modèles que nous hébergeons nous-mêmes, nos prix reposent sur une référence de marché ajustée pour la souveraineté, des hypothèses…
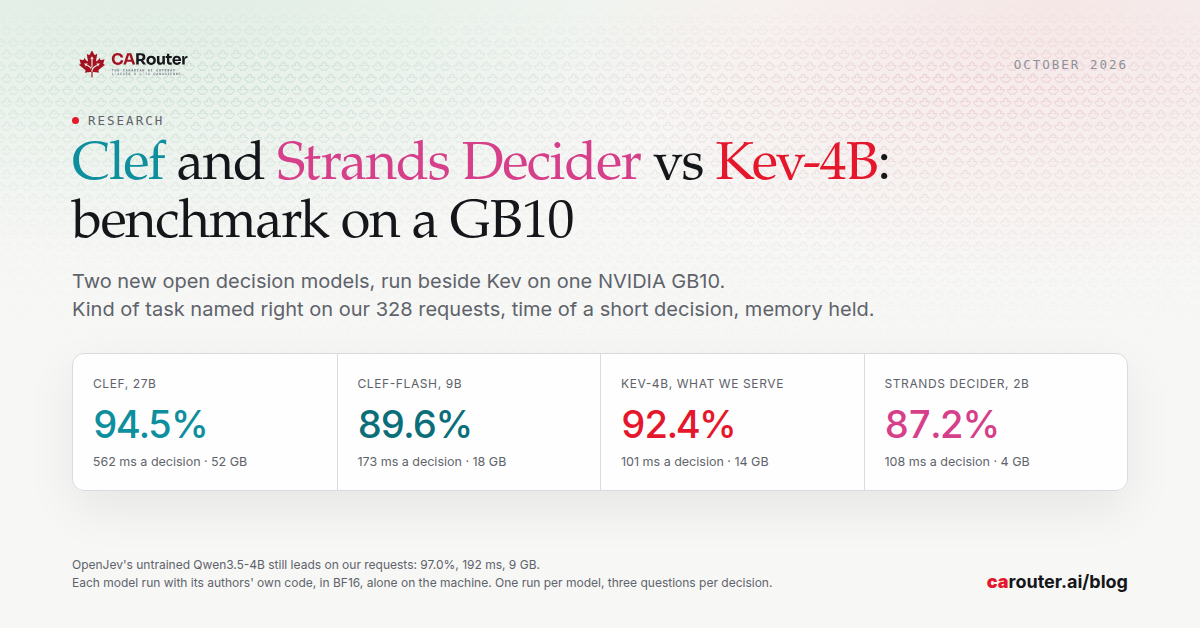
Lire l'articleClef et Strands Decider contre Kev-4B : benchmark sur un GB10
Clef, de Cloudflare, et Strands Decider, de Strands Labs, sont deux nouveaux modèles de décision ouverts. Sur un GB10, Clef a reconnu le…
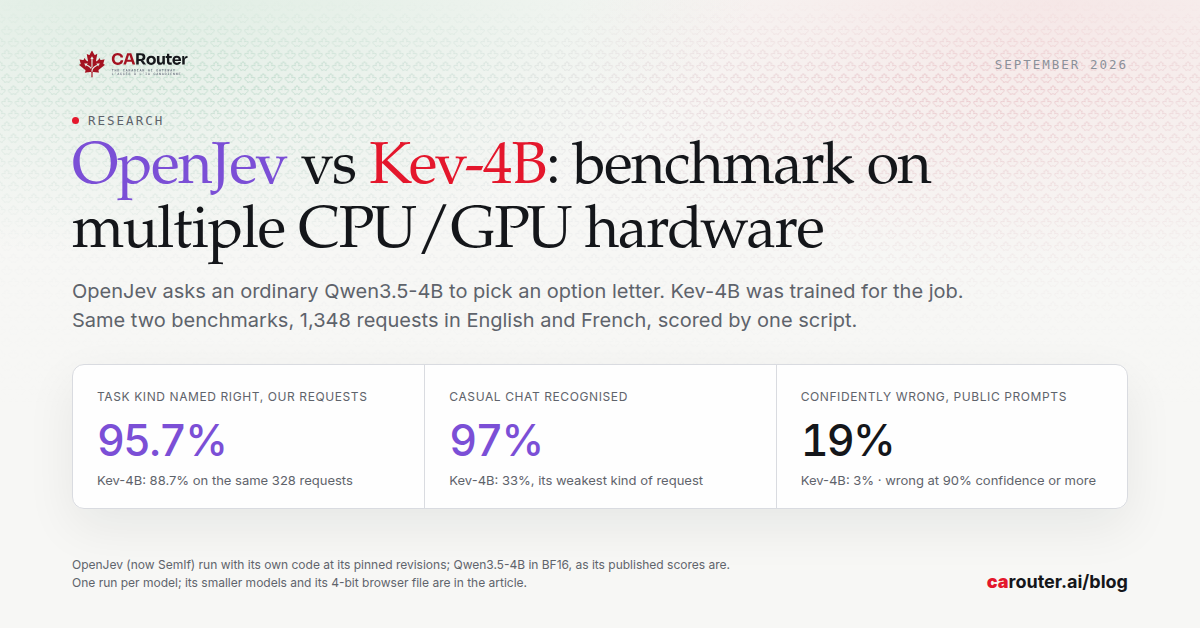
Lire l'articleOpenJev contre Kev-4B : benchmark sur plusieurs matériels CPU et GPU
OpenJev demande à un Qwen3.5-4B ordinaire de choisir la lettre d'une option, sans aucun entraînement pour la tâche. Sur les deux benchmarks…
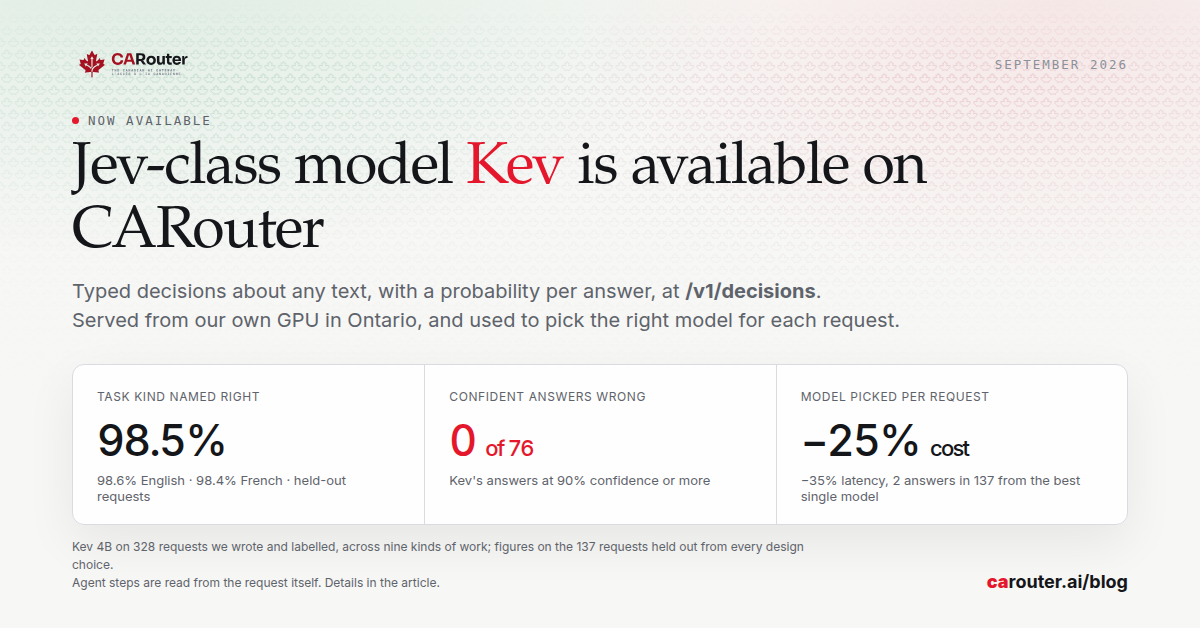
Lire l'articleKev, un modèle du calibre de Jev, est disponible sur CARouter (+ benchmarks)
Kev 4B, un modèle de décision ouvert qui répond à des questions typées comme le fait Jev de TypeSafe, s'appelle désormais sur…
Lire l'articleRoutage intelligent avec Kev : notre benchmark
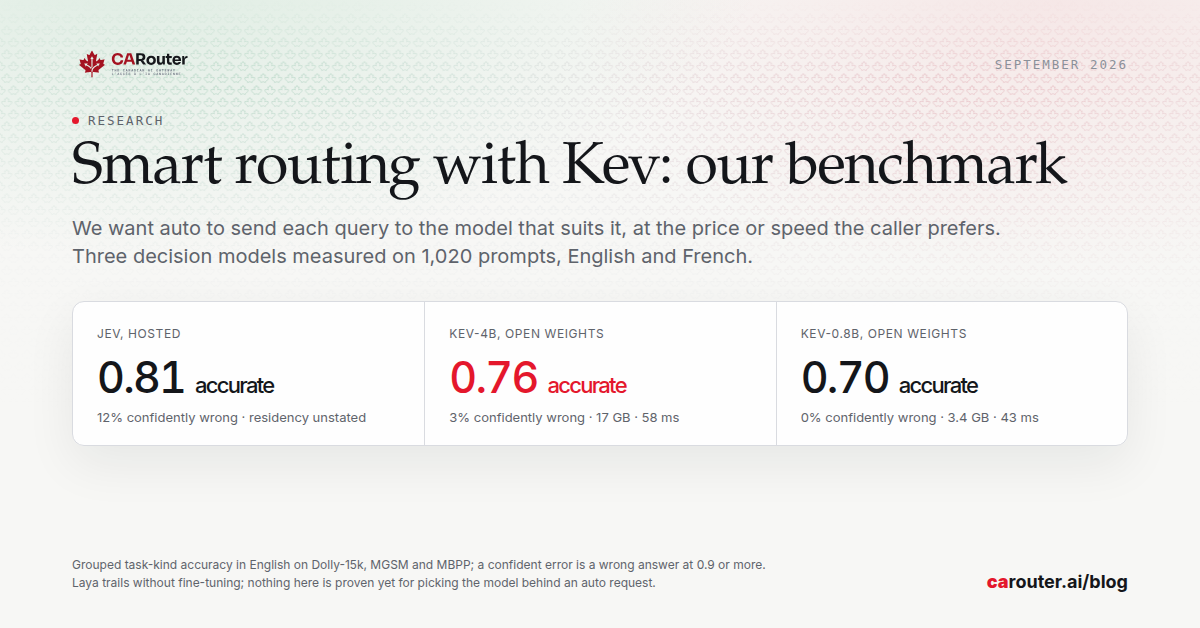
Une requête adressée à CARouter pourrait ne nommer aucun modèle et tomber quand même sur le bon, au prix ou à la vitesse de votre choix.…
Lire l'articleCKKS peut-il rendre l’IA confidentielle accessible?
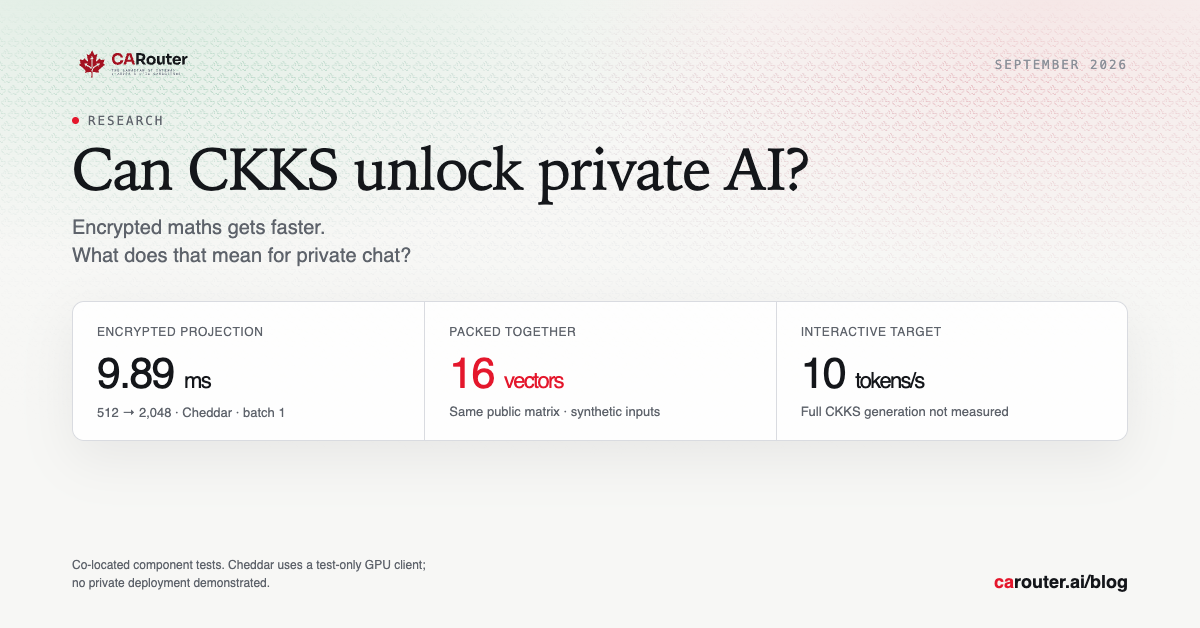
Nous avons testé des bibliothèques CKKS actuelles sur GPU avec les dimensions du modèle Qwen. Les opérations matricielles et le traitement…
Lire l'articleRépondre aux enjeux de souveraineté et de pénurie de GPU par l’inférence homomorphe des LLM
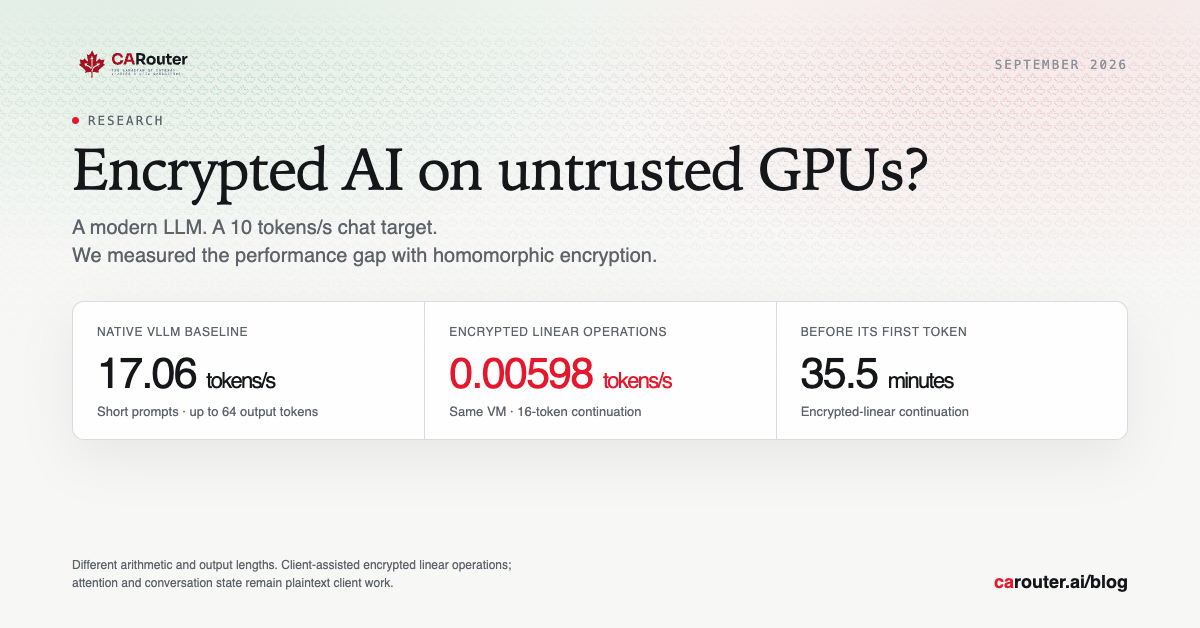
Nous avons testé l’inférence homomorphe assistée par un client, de GPT-2 à Qwen3.6-35B-A3B, avec un client CPU de confiance séparé.…
Lire l'articleL’ajout de l’affinité de cache pour réduire les coûts et accélérer les réponses
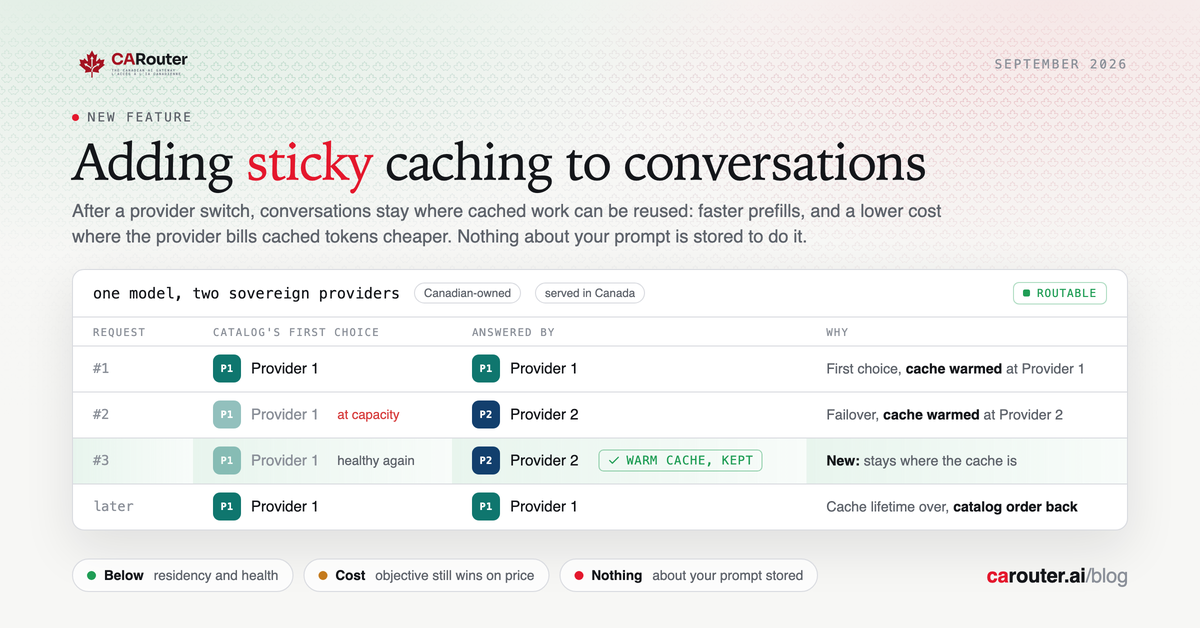
Un fournisseur d’IA peut traiter des instructions répétées plus vite et à moindre coût s’il peut réutiliser le travail déjà effectué.…
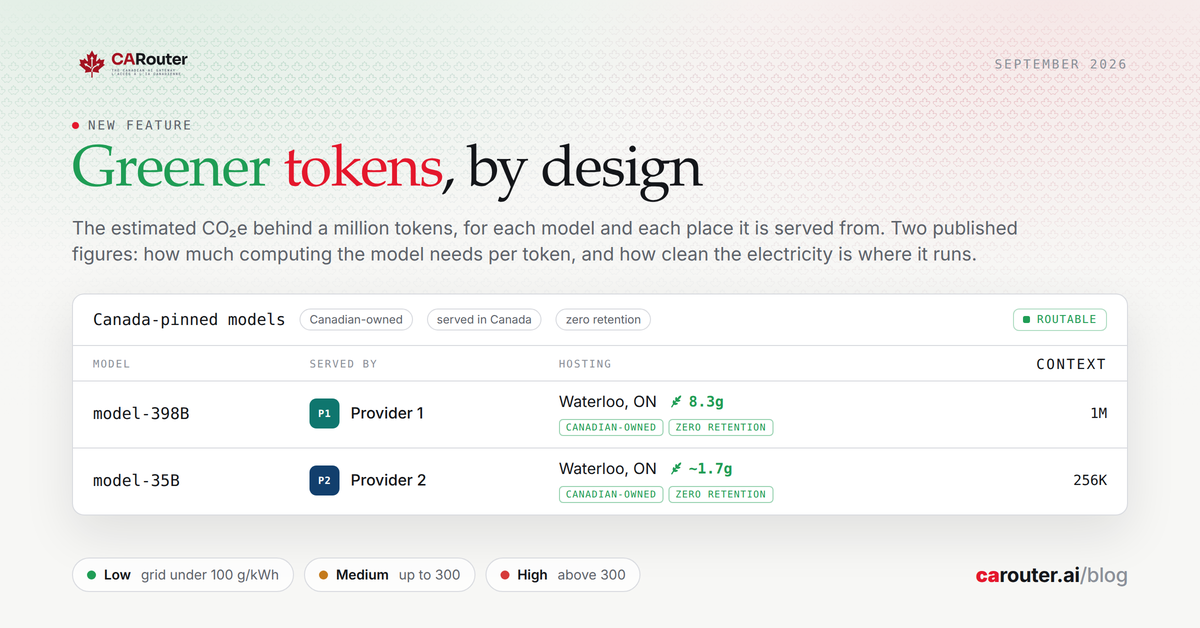
Lire l'articleDes tokens plus verts : l'empreinte carbone de chaque modèle, avant de le choisir
Chaque offre de notre documentation affiche désormais une estimation des émissions de carbone par million de tokens, avec une couleur selon…
Lire l'articleCARouter rejoint Denvr AI Ascend : des crédits infonuagiques pour mesurer les performances sur du matériel canadien
CARouter rejoint Denvr AI Ascend, le programme de démarrage d'un fournisseur infonuagique canadien qui exploite ses propres GPU à Calgary.…
Lire l'articlePartenariat avec Augure : deux modèles entraînés au Canada et servis exclusivement au Canada
Rosedale One et Tofino 3 sont en service sur notre plateforme. Servis au Canada ou refusés, jamais basculés à l'étranger, et aucune requête…
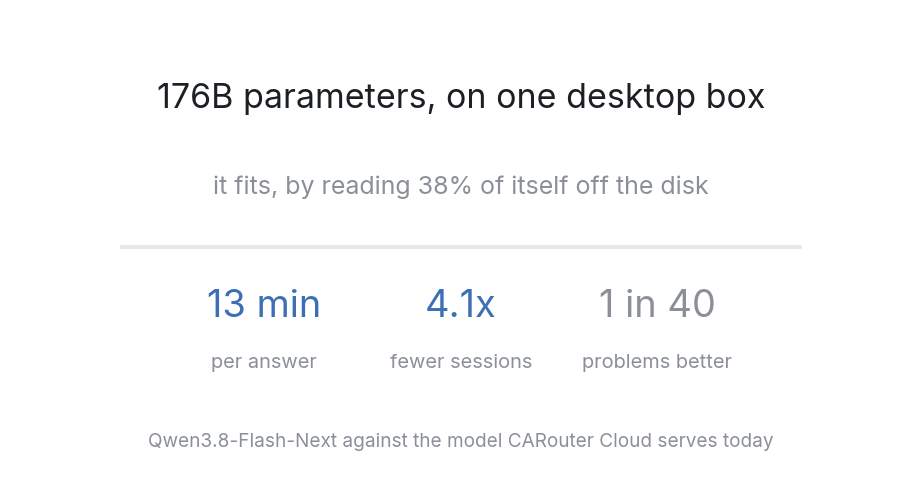
Lire l'articleQwen3.8-Flash-Next sur le DGX Spark de CARouter : de meilleures réponses, mais dix fois plus d'attente
L'aperçu de l'architecture Qwen4 de Qwen domine les palmarès de codage, et sa plus petite version servable pèse 125,9 Gio face à une…
Lire l'articlePourquoi nous servons désormais Qwen3.6 35B-A3B plutôt que Qwen3.8 27B
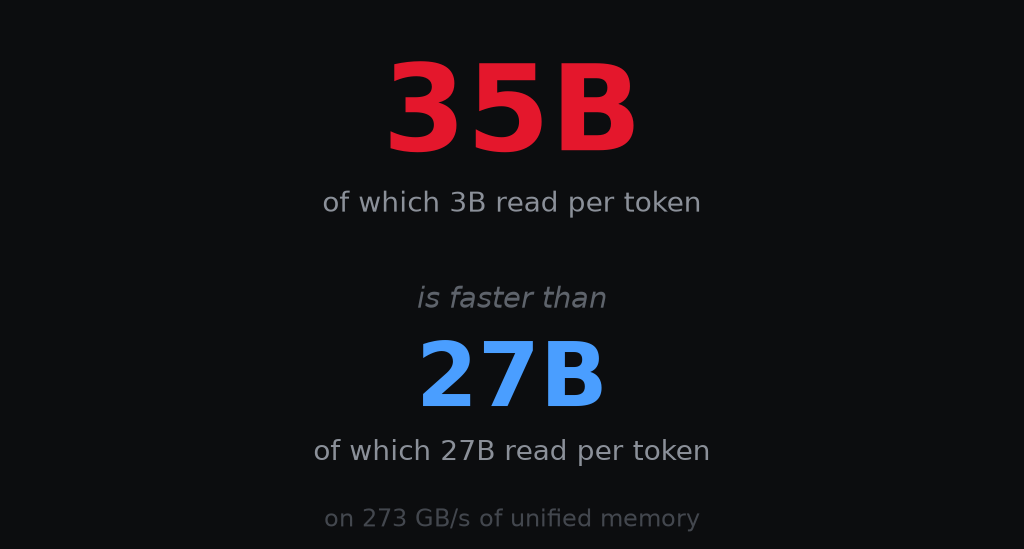
Un modèle dense de 27B doit lire ses 23,4 Go au complet pour écrire un seul token, ce qui, sur notre DGX Spark, plafonne à environ 12…
Lire l'articleRégler le décodage spéculatif sur le DGX Spark de CARouter : des réponses de code deux tiers plus rapides, à matériel constant
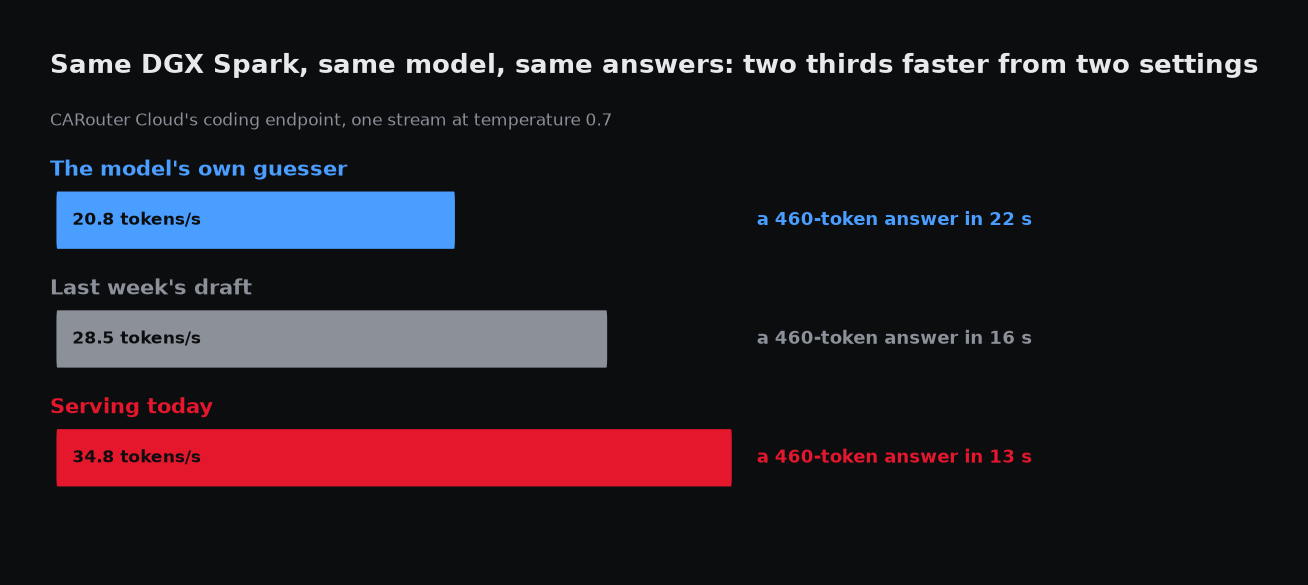
Le décodage spéculatif fait deviner à un petit modèle « brouillon » les tokens à venir, pour que le gros puisse en vérifier plusieurs d'un…
Lire l'articleMTP contre DFlash2 sur le DGX Spark de CARouter : 35 % de tokens en plus par pas, pas un pas plus rapide
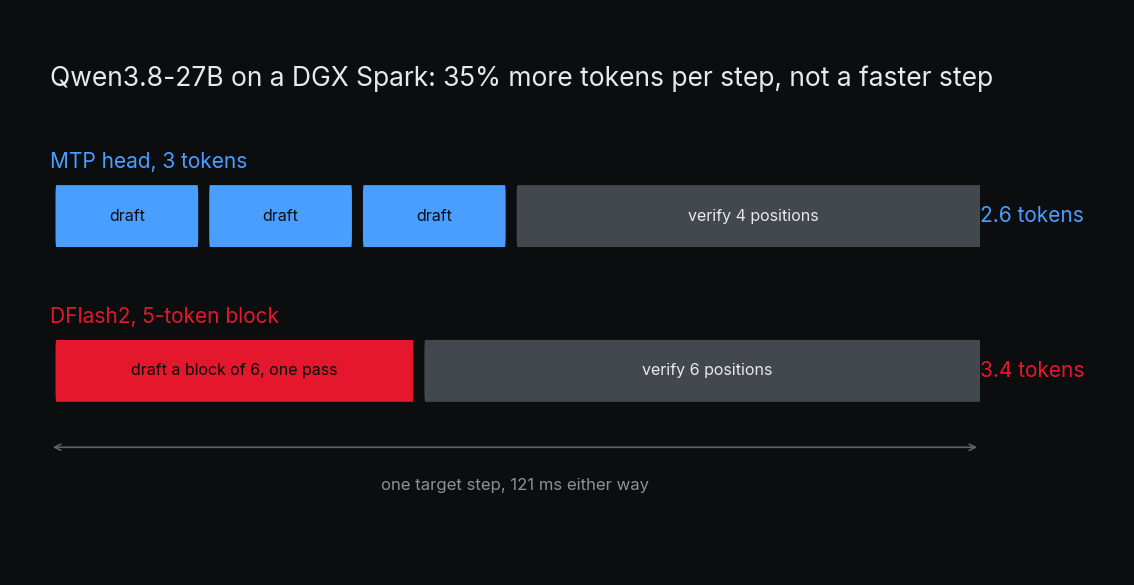
Une infolettre promettait 3× grâce au décodage spéculatif le matin même où vLLM 0.28.0 livrait le brouillon qui manquait à Qwen3.8-27B.…
Lire l'articleLaguna S 2.1 contre Qwen3.8-27B sur le DGX Spark de CARouter : la vitesse a perdu contre la mémoire
Laguna S 2.1 de Poolside décode deux fois et demie plus vite que Qwen3.8-27B sur notre DGX Spark de 128 Go. Nous avons quand même mis Qwen…
Lire l'article