Routage intelligent et auto : mêmes réponses, plus vite et pour moins cher
CArouter peut maintenant choisir le modèle pour chaque requête, et décider s'il réfléchit d'abord. Sur nos tests, auto a mieux répondu que n'importe quel modèle seul, et le mode intelligent a réduit la facture d'un modèle de 50 %.
L'essentiel de ce qu'une équipe envoie à un modèle d'IA est simple : un merci, une traduction, une question courte. Aujourd'hui, ces requêtes sont traitées comme les plus difficiles. Elles vont au plus gros modèle de l'équipe, qui réfléchit longuement avant de répondre, au plein tarif.
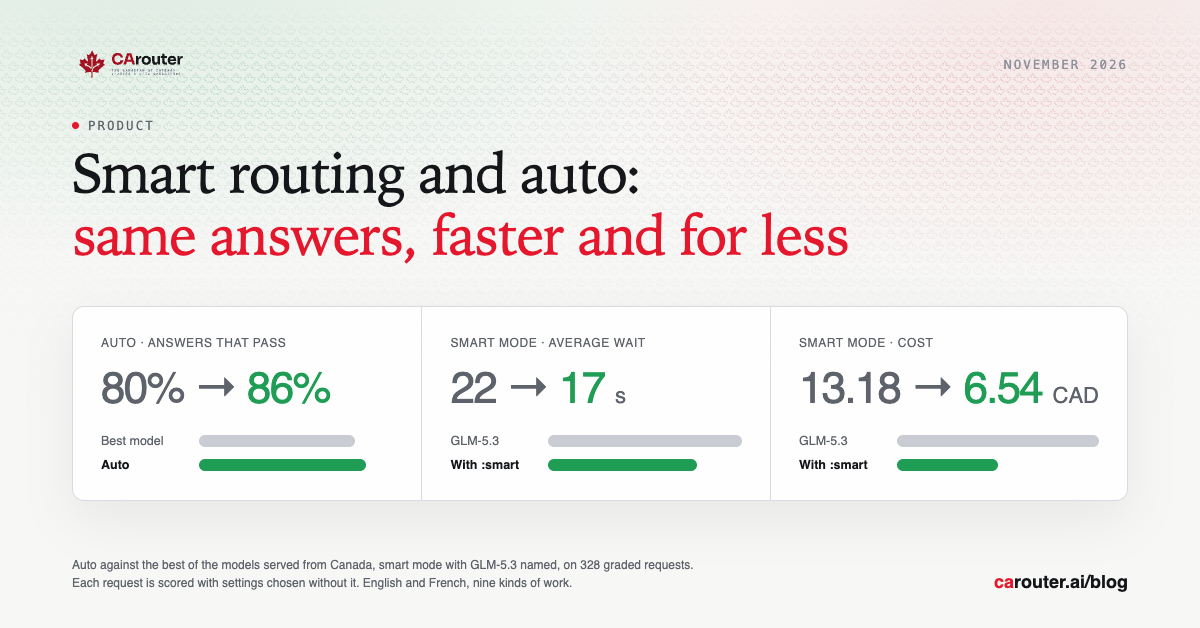
CArouter peut maintenant choisir, pour chaque requête, le modèle le plus susceptible d'y répondre correctement, et décider si ce modèle doit réfléchir d'abord. Sur les requêtes que nous avons notées, auto a donné plus de bonnes réponses que n'importe quel modèle seul : 85,7 % contre 79,9 %. Avec :smart sur un modèle que vous utilisez déjà, la part de bonnes réponses s'est maintenue à moins de deux points et la facture a baissé jusqu'à 50 %.
En bref
- Ce qu'il fait. Pour chaque requête, CArouter choisit le modèle le plus susceptible d'y répondre correctement, prend le moins cher quand plusieurs se valent, et saute le temps de réflexion du modèle quand la requête n'en a pas besoin.
- Comment l'utiliser. Votre application change un mot : elle écrit auto là où elle nomme un modèle aujourd'hui, ou elle garde le nom du modèle et ajoute :smart.
- Ce que nous avons mesuré. Sur 328 requêtes notées, auto a réussi 85,7 % des réponses, là où le meilleur de trois modèles pris seuls en a réussi 79,9 %. Avec :smart sur GLM-5.3, le plus cher des trois, 78,0 % des réponses ont réussi contre 79,6 %, les requêtes ont coûté 6,54 $ CA au lieu de 13,18, et une réponse a pris 17 secondes au lieu de 22.
- Ce qui ne change pas. Vos requêtes restent au Canada, sauf si votre clé en décide autrement, vous payez le prix du modèle qui a répondu, et chaque réponse nomme ce modèle.
- Disponibilité. Les deux fonctionnent d'abord sur nos propres espaces de travail. Nous les ouvrirons ensuite à tous les espaces de travail.
Le problème : un seul modèle pour toutes les requêtes
Une équipe choisit en général un modèle et lui envoie tout. Elle le choisit pour son travail le plus difficile : il est donc gros, il réfléchit avant de répondre, et son prix suit.
Voici trois requêtes que cette même équipe envoie en une matinée.
- « Merci, ça a fonctionné! » Aucune réflexion nécessaire.
- « Traduisez ce paragraphe en français. » N'importe quel bon modèle le fait en deux secondes.
- « Relevez tous les montants et toutes les échéances de ce contrat. » Celle-ci mérite le gros modèle, et toute son attention.
Avec un seul modèle pour tout, les deux premières attendent aussi longtemps et coûtent aussi cher que la troisième. Sur une journée de requêtes, c'est l'essentiel de la facture et de l'attente.
Ce que CArouter fait maintenant
CArouter lit chaque requête avant de l'envoyer où que ce soit, et prend deux décisions que votre équipe prenait une seule fois, pour toutes les requêtes à la fois.
Quel modèle répond. Chaque requête va à un modèle dont nous avons mesuré qu'il traite bien ce type de travail. Quand plusieurs conviennent, le plus petit, le plus rapide et le moins cher répond.
Si le modèle réfléchit d'abord. Beaucoup de modèles peuvent travailler un problème dans un brouillon privé avant d'écrire leur réponse. Ce brouillon, vous l'attendez et vous le payez. CArouter le désactive quand une réponse directe est tout aussi bonne, et le laisse actif quand le travail le demande.
Les trois mêmes requêtes prennent maintenant trois chemins différents. Le merci reçoit sa réponse tout de suite, sans réflexion. La traduction obtient une réponse directe en quelques secondes. Le contrat va au gros modèle, réflexion comprise.
Deux façons de l'activer
Dans les deux cas, c'est un mot dans la requête que votre application envoie déjà. Rien d'autre ne change dans votre code.
Aujourd'hui, les trois requêtes vont au même modèle, qui réfléchit avant chaque réponse. Avec auto ou :smart, le merci et la traduction reçoivent une réponse directe en quelques secondes, pour une fraction du prix, et le contrat garde toute l'attention d'un gros modèle.
Laisser CArouter choisir : écrivez auto
Là où votre application nomme un modèle, elle écrit auto. CArouter choisit le modèle et décide de la réflexion, requête par requête. Pour chaque requête, la référence est le modèle le plus susceptible de bien répondre à ce type de travail, parmi ceux que votre clé peut atteindre. Quand plusieurs se valent, le moins cher et le plus rapide répond.
C'est l'option d'une équipe qui veut la meilleure réponse à chaque requête et qui ne tient à aucun modèle en particulier.
Garder votre modèle comme référence : ajoutez :smart
Si votre équipe a arrêté son choix sur un modèle, elle garde le nom de ce modèle et ajoute :smart à la suite. Votre modèle répond toujours à chaque requête qui a besoin de lui. Une requête va à un autre modèle seulement quand celui-ci devrait y répondre aussi bien, sans coûter plus cher ni prendre plus de temps.
C'est l'option d'une équipe qui a testé un modèle, lui fait confiance, et veut cesser de le payer pour les requêtes faciles.
Ce que vous envoyez, et ce qui revient
Une requête qui laisse CArouter choisir ressemble à toutes les autres. Seul le champ model diffère.
curl https://carouter.ai/v1/chat/completions \
  -H "Authorization: Bearer $CAROUTER_API_KEY" \
  -d '{"model": "auto", "messages": [{"role": "user", "content": "Translate this paragraph into French: ..."}]}'
La réponse porte deux lignes que votre équipe peut journaliser : le modèle qui a répondu, et ce que CArouter a lu dans la requête pour le choisir. Ici, une traduction, jugée facile, servie sans réflexion.
X-CArouter-Model:   qwen3.6-35b-a3b
X-CArouter-Routing: {"mode":"auto","kind":"translation","difficulty":0.6,"effort":"none"}
Comment CArouter décide
- Il lit la requête. Un petit modèle, sur notre propre matériel au Canada, examine la requête pendant quelques dixièmes de seconde : de quel type de travail il s'agit, sa difficulté, et si la réponse sera longue. Un merci est reconnu sans aucun modèle.
- Il sait ce que vaut chaque modèle sur ce type de travail. Nous avons noté chaque modèle sur des centaines de requêtes, par type de travail. Ce relevé est mis à jour toutes les dix minutes avec les prix en vigueur et les vitesses mesurées.
- Il ne répond que si la qualité tient. Un modèle ne répond à une requête que si ses résultats sur ce type de travail valent ceux de la référence, avec une marge de sécurité pour ce dont nous sommes moins sûrs. Cette marge est réglée pour que la part de bonnes réponses reste à moins de deux points.
- Il a une solution de repli. Si le modèle choisi échoue ou renvoie une réponse défectueuse, la référence de cette requête répond à sa place, avant que vous receviez un seul mot.
Si CArouter ne peut pas lire une requête, pour quelque raison que ce soit, elle est servie exactement comme elle a été écrite. Choisir un modèle est une économie, et une réponse passe toujours avant.
Ce que nous avons mesuré
Nous avons écrit 328 requêtes du genre de celles que nos clients envoient, la moitié en anglais et la moitié en français : code, mathématiques, recherche, rédaction d'affaires, extraction, résumés, traduction, questions du quotidien et étapes d'agent. Chaque réponse est notée par un test, un résultat exact ou une grille.
Trois modèles à poids ouverts servis depuis le Canada ont répondu à toutes ces requêtes : Qwen3.8 Flash Next, GLM-5.3 et Qwen3.6 35B A3B. Qwen3.6 35B A3B y a répondu deux fois, avec et sans réflexion.
Chaque chiffre ci-dessous est mesuré hors échantillon : pour noter une requête, nous choisissons tous les réglages sur les autres requêtes, puis nous regardons ce que devient celle-ci.
Un seul modèle pour tout
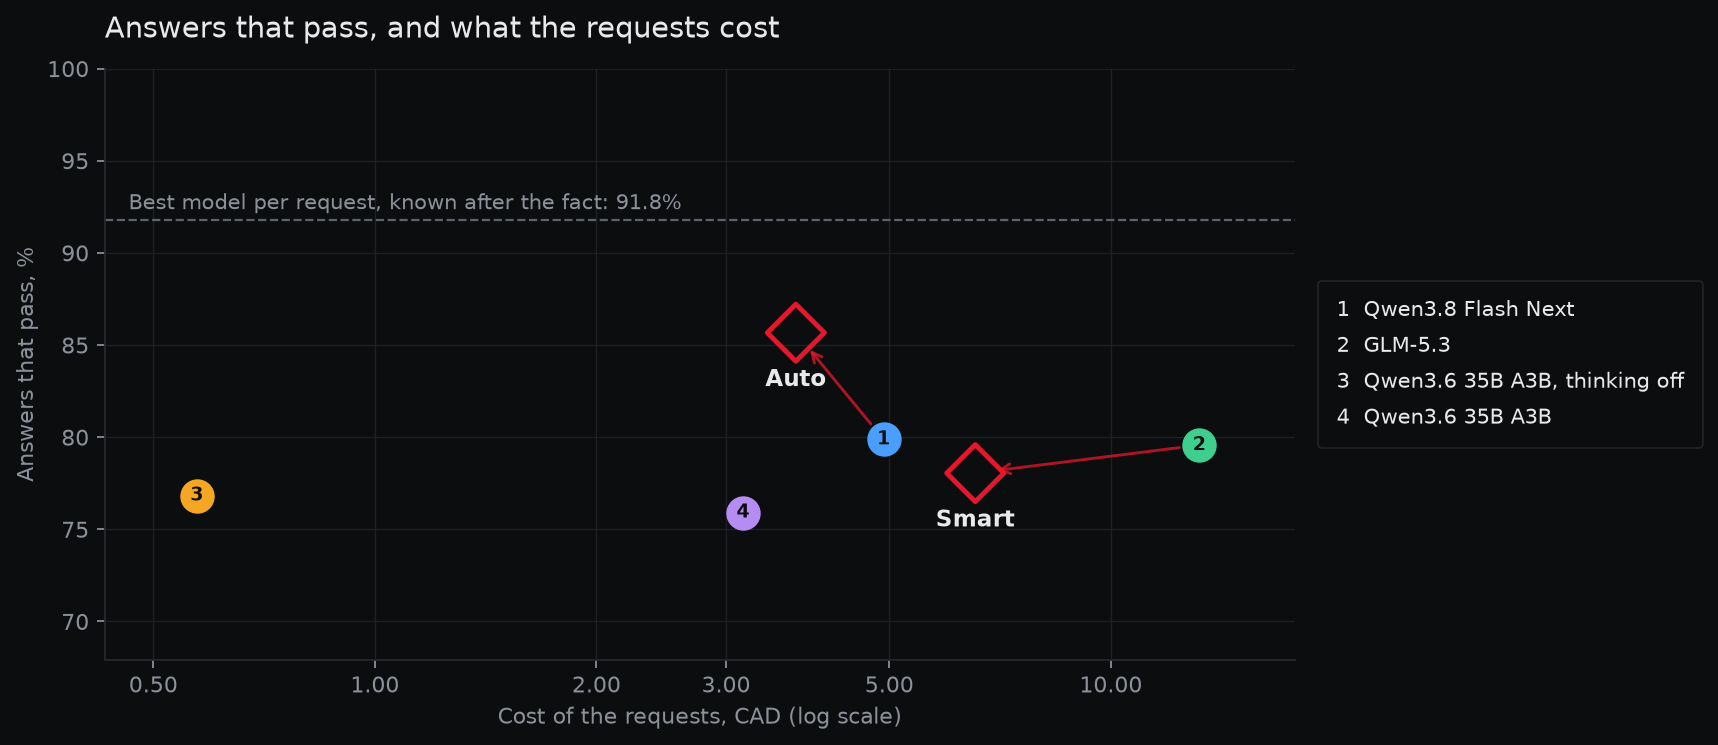
Pris un par un, les trois modèles sont proches : ils réussissent entre 75,9 % et 79,9 % des requêtes. Ce qui les sépare, c'est le prix, de 3,16 à 13,18 $ CA pour les 328 requêtes, et l'attente, de 17 à 69 secondes en moyenne.
Ils sont proches au total et diffèrent dans le détail. Qwen3.8 Flash Next réussit 92 % des requêtes de mathématiques et 44 % des étapes d'agent. Qwen3.6 35B A3B réussit 66 % des étapes d'agent et 67 % des requêtes de mathématiques. Aucun modèle n'est le meilleur partout.
Auto
Auto envoie chaque requête au modèle le plus susceptible de bien répondre à ce type de travail. Il a réussi 85,7 % des réponses, soit 5,8 points de plus que le meilleur modèle seul : sur 100 requêtes, 6 bonnes réponses de plus.
L'écart dépasse le bruit d'un jeu de cette taille : quand nous rééchantillonnons les requêtes, il reste entre 2,4 et 9,4 points.
Il a utilisé tous les modèles : 52 % des requêtes sont allées à Qwen3.8 Flash Next, 31 % à Qwen3.6 35B A3B sans réflexion, 11 % à GLM-5.3, et le reste à Qwen3.6 35B A3B avec réflexion.
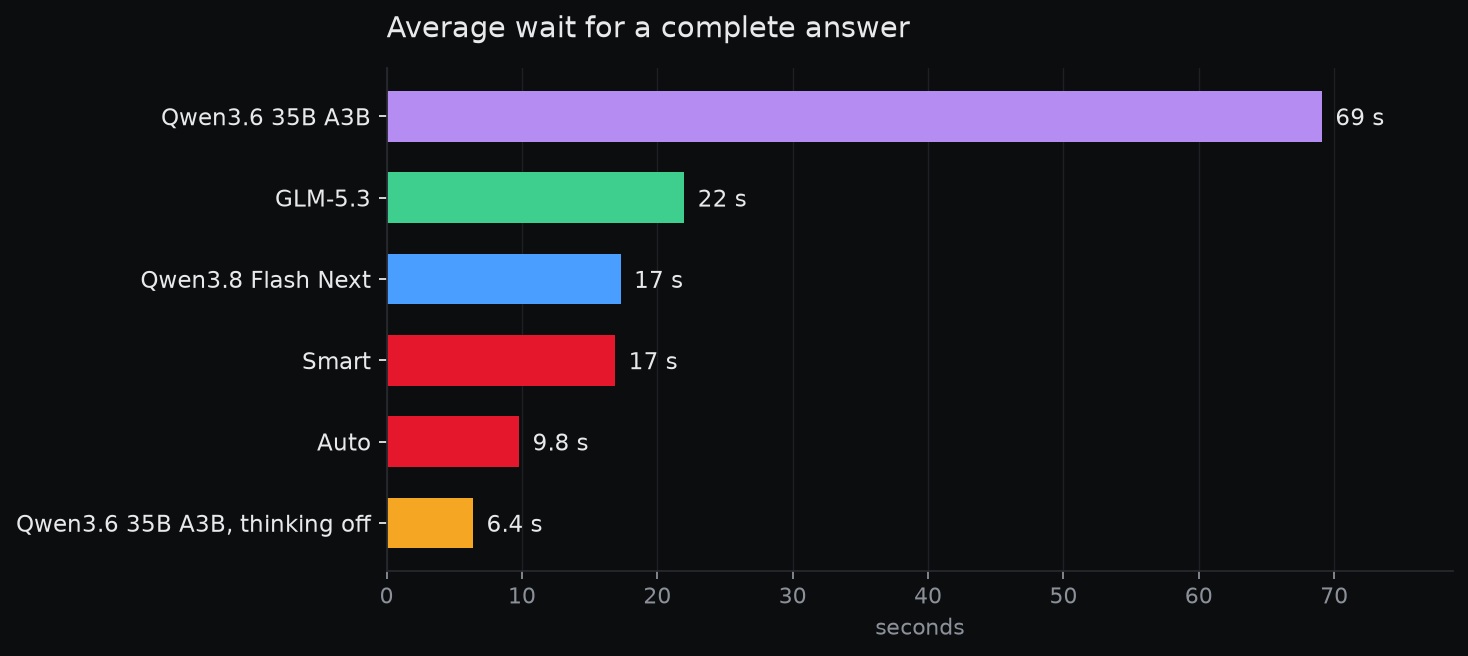
Une réponse a pris 9,8 secondes en moyenne et les requêtes ont coûté 3,73 $ CA. Le meilleur modèle seul, Qwen3.8 Flash Next, a coûté 4,91 $ CA et pris 17 secondes, et GLM-5.3 davantage sur les deux plans. Qwen3.6 35B A3B seul coûte 3,16 $ CA et répond en 69 secondes, avec 10 bonnes réponses de moins sur 100.
Le mode intelligent
Le mode intelligent garde comme référence le modèle que vous avez nommé et sert une requête par un autre modèle seulement quand celui-ci devrait répondre aussi bien, sans coûter plus cher ni prendre plus de temps. Avec GLM-5.3, le plus cher des trois, il a réussi 78,0 % des réponses, là où GLM-5.3 en a réussi 79,6 %. Les requêtes ont coûté 6,54 $ CA au lieu de 13,18, et une réponse a pris 17 secondes au lieu de 22.
L'économie dépend du modèle que vous nommez. Avec Qwen3.6 35B A3B : 79,6 % contre 75,9 %, 2,86 $ CA au lieu de 3,16, et 37 secondes au lieu de 69. Avec Qwen3.8 Flash Next, aucun autre modèle ne devait répondre aussi bien sans coûter plus cher ni prendre plus de temps, donc le mode intelligent a servi chaque requête par ce modèle.
Dans tous les cas, la part de bonnes réponses est restée dans les deux points que le mode intelligent est réglé pour respecter. Notre page de recherche présente chaque chiffre.
La réflexion aide pour certains travaux, et coûte pour tous
Pour savoir quand la réflexion vaut son attente, nous avons posé les 328 requêtes deux fois à Qwen3.6 35B A3B, avec et sans réflexion. Avec réflexion, il en a réussi 75,9 % et une réponse a pris 69 secondes en moyenne. Sans, 76,8 % et 6,4 secondes.
La moyenne cache les cas où la réflexion compte. En rédaction d'affaires, 27 réponses sur 28 ont réussi avec réflexion et 21 sans. En code, 46 sur 66 ont réussi avec réflexion et 56 sans, et une réponse a pris 127 secondes de plus. En code et en mathématiques, 30 des 130 réponses réfléchissaient encore en atteignant la limite de longueur, et comptent comme échouées.
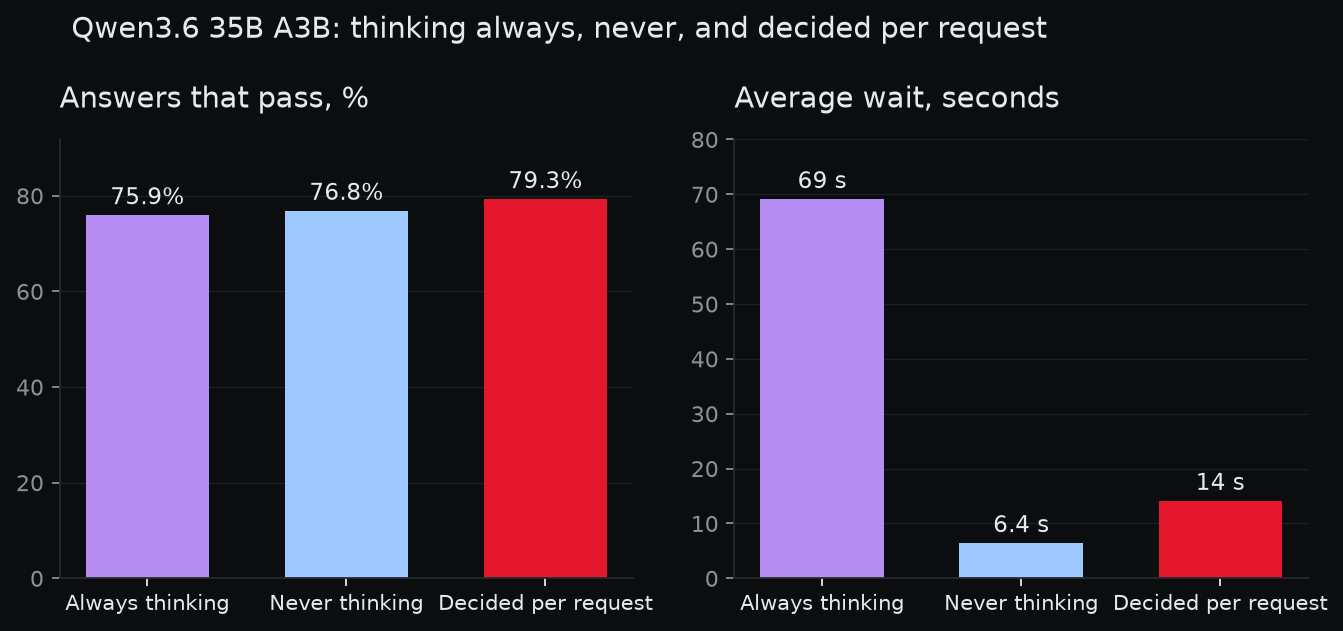
Toujours réfléchir fait attendre chaque requête et coûte 3,16 $ CA pour les 328 requêtes. Ne jamais réfléchir coûte 0,57 $ CA et perd le travail qui en a besoin. Décider pour chaque requête a sauté la réflexion sur 74 % d'entre elles et en a réussi 79,3 %, plus que l'un ou l'autre, pour 0,88 $ CA et 14 secondes en moyenne. Auto va plus loin, parce qu'il peut aussi changer de modèle.
Ce que nous avons essayé et qui n'a pas fonctionné
Nous espérions repérer une réponse faible dès ses premiers mots. Un modèle indique à quel point il est sûr de chaque mot qu'il écrit, et un début hésitant aurait pu nous dire de passer à un modèle plus fort avant que vous voyiez quoi que ce soit.
Sur nos requêtes, ce signal ne valait guère mieux qu'un tirage à pile ou face. Nous avons construit la vérification, nous l'avons mesurée, et nous l'avons laissée désactivée. Une protection qui ne fait rien n'a pas sa place dans un produit, et vous devez savoir lesquelles nous avons testées.
Ce qui ne change pas
- Vos données restent au Canada. Un modèle que CArouter choisit pour vous est servi depuis le Canada par un fournisseur de propriété canadienne. Une requête ne franchit une frontière que pour une clé API qui autorise les fournisseurs étrangers.
- La facture est le prix du modèle qui a répondu. Avec :smart, ce n'est jamais plus que le prix du modèle que vous avez nommé.
- Chaque choix est visible. Chaque réponse nomme le modèle qui a répondu et la raison, dans un en-tête que votre équipe peut journaliser.
- Le contenu de vos requêtes n'est pas conservé. La lecture d'une requête ne laisse que deux étiquettes : le type de travail et sa difficulté.
- Rien ne change sans que vous le demandiez. Une requête qui nomme un modèle sans rien ajouter est servie par ce modèle, comme avant.
De nouveaux modèles, de nouveaux prix, chaque semaine
De nouveaux modèles arrivent chaque mois, et les prix comme les vitesses bougent chaque semaine. Une liste de règles écrite à la main est dépassée dès le lendemain.
Le relevé de CArouter est reconstruit toutes les dix minutes à partir des modèles, des prix et des vitesses en service. Un nouveau modèle commence à recevoir des requêtes en votre nom une fois qu'il a répondu à nos requêtes notées. D'ici là, il est servi seulement quand vous le nommez.
Ce que cela ne prouve pas
- Il s'agit d'un seul jeu de requêtes, écrit et noté par nous. Un autre jeu pourrait faire bouger les chiffres.
- Chaque requête est notée avec des réglages choisis sur les autres requêtes. Une version antérieure de cet article utilisait 137 requêtes tenues à l'écart, que nous avons lues plusieurs fois à mesure que le travail évoluait.
- Une réponse qui s'est terminée par une erreur a été demandée une seconde fois, et compte comme un échec si elle a échoué de nouveau.
- Interrogé une seconde fois sur les mêmes 328 requêtes, Qwen3.6 35B A3B a changé de résultat sur 45 d'entre elles. Un écart d'un point ou deux entre deux lignes reste dans ce bruit.
- Les choix ont été rejoués sur des réponses déjà notées. En production, une requête attend en plus quelques dixièmes de seconde, le temps d'être lue.
- Auto s'appuie sur les résultats de chaque modèle pour chaque type de travail. Un modèle qui change, ou un travail différent de nos neuf types, demande de nouvelles mesures.
Fondé sur de la recherche publiée
Aucune de ces idées n'est de nous seuls. Envoyer les requêtes faciles à un modèle plus petit, décrire un nouveau modèle par ses résultats sur un jeu fixe de requêtes, régler une marge de qualité sur des données tenues à l'écart : tout cela vient de la recherche publiée. Notre page de recherche présente chaque article avec ce qu'il a établi.
Voir comment ça fonctionne, avec les mesures et les références.
Un article précédent sur le petit modèle qui lit chaque requête : Kev est disponible sur CArouter.
Le bon modèle pour une requête est le moins cher qui y répond bien. Le trouver, c'est maintenant le travail de CArouter.
Comparer les modèles et les fournisseurs disponibles. Consulter les règles techniques de routage.