Banc d'essai du modèle Ricursive Ripple-65B Preview : vitesse et qualité
Ripple-65B Preview, le modèle de programmation dense de Ricursive, écrit à 4 bits 4.1 tokens par seconde sur un GB10 et 23.1 sur une RTX PRO 6000 Blackwell, et son modèle brouillon DFlash2 porte ces chiffres à 19.0 et 64.8. Il suit mieux les consignes que le Qwen3.6 35B-A3B que nous servons, 96 % contre 89 %, programme aussi bien, et le suit de près sur les appels d'outils et les questions scientifiques.
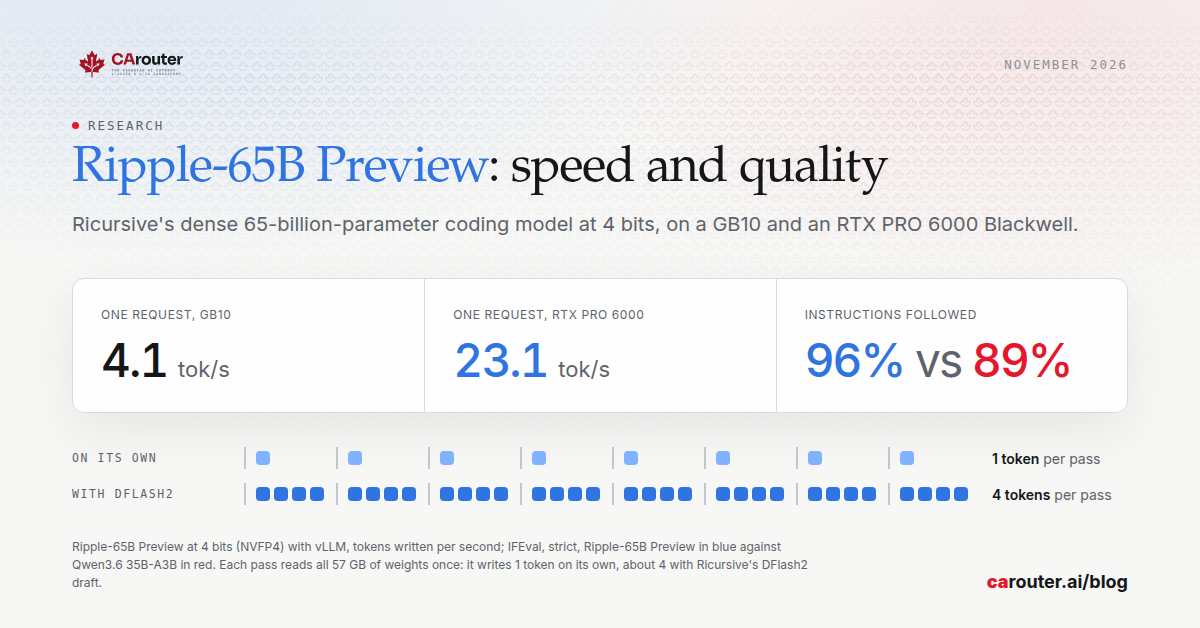
Ricursive Intelligence a publié Ripple-65B Preview cette semaine. C'est un modèle dense de 65 milliards de paramètres, entraîné pour la programmation par agents, et Ricursive annonce 80.5 % au Terminal-Bench 2.1.
Selon Ricursive, le modèle tient aussi sur un DGX Spark. Nous avons mesuré sa version à 4 bits avec notre outil de bancs d'essai sur deux puces : le GB10 du DGX Spark et de notre propre serveur, puis une RTX PRO 6000 Blackwell, une carte de station de travail dotée de 96 Go. Nous avons ensuite lancé nos cinq tests de qualité.
Le dernier modèle testé sur le GB10 : Nemotron 3.5 Lightning 30B-A3B face à Qwen3.6 35B-A3B.
En bref
- Vitesse sur un GB10. Ripple écrit 4.1 tokens par seconde pour une requête, et 19.0 avec le modèle brouillon DFlash2 de Ricursive.
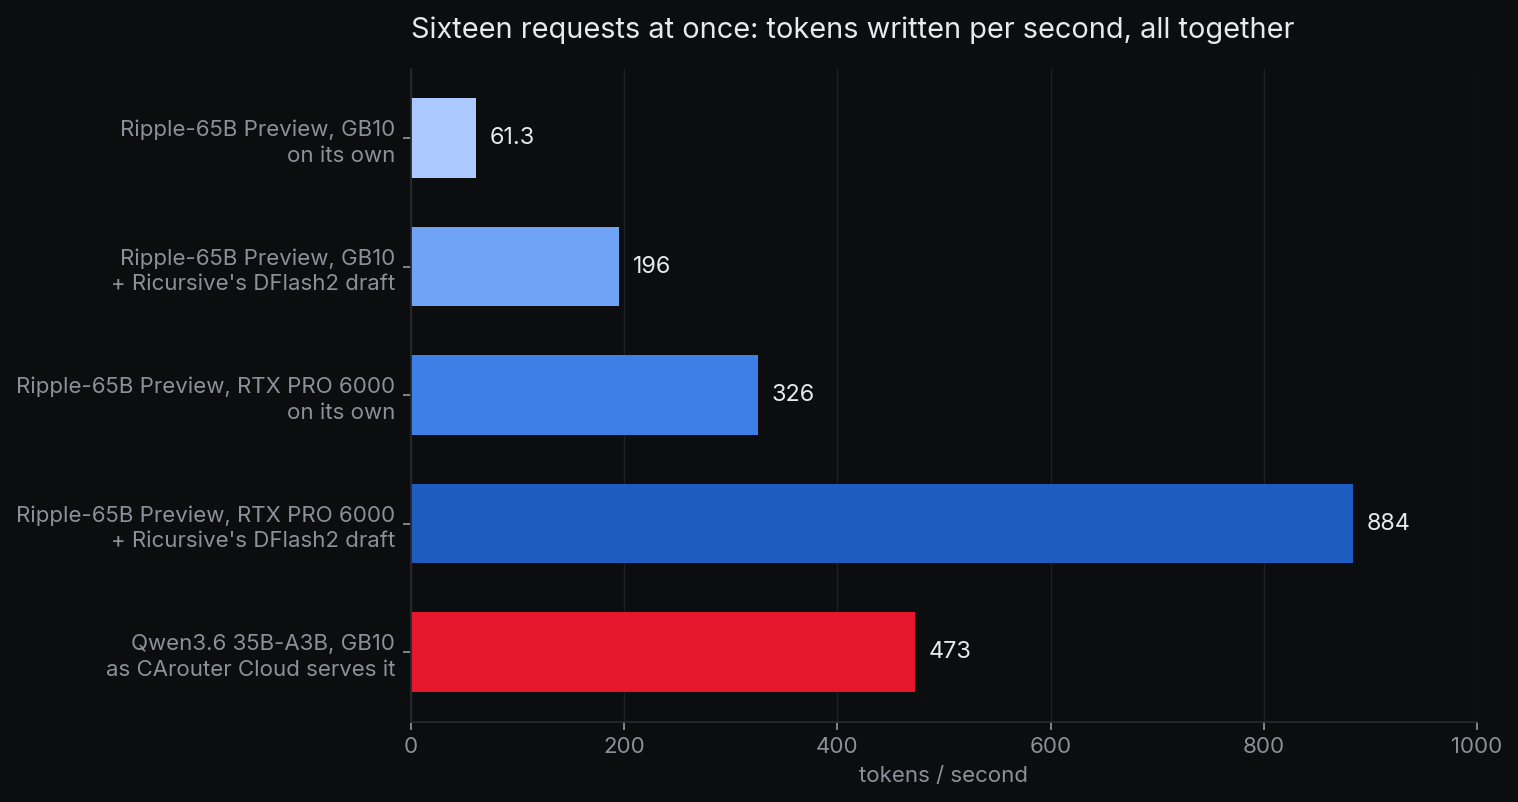
- Vitesse sur une RTX PRO 6000. Il écrit 23.1 tokens par seconde, 64.8 avec le brouillon, et 884 au total pour seize requêtes simultanées.
- Qualité. Ripple suit mieux les consignes que le Qwen3.6 35B-A3B que nous servons, 96 % contre 89 %, et programme aussi bien. Il reste un peu en retrait de Qwen sur les appels d'outils et les questions scientifiques.
- Mémoire. Les poids à 4 bits occupent 54 Gio : ils tiennent dans les 128 Go du GB10, avec la place pour un cache de contexte de 255 000 tokens dans 20 Gio.
Pourquoi un modèle dense écrit lentement
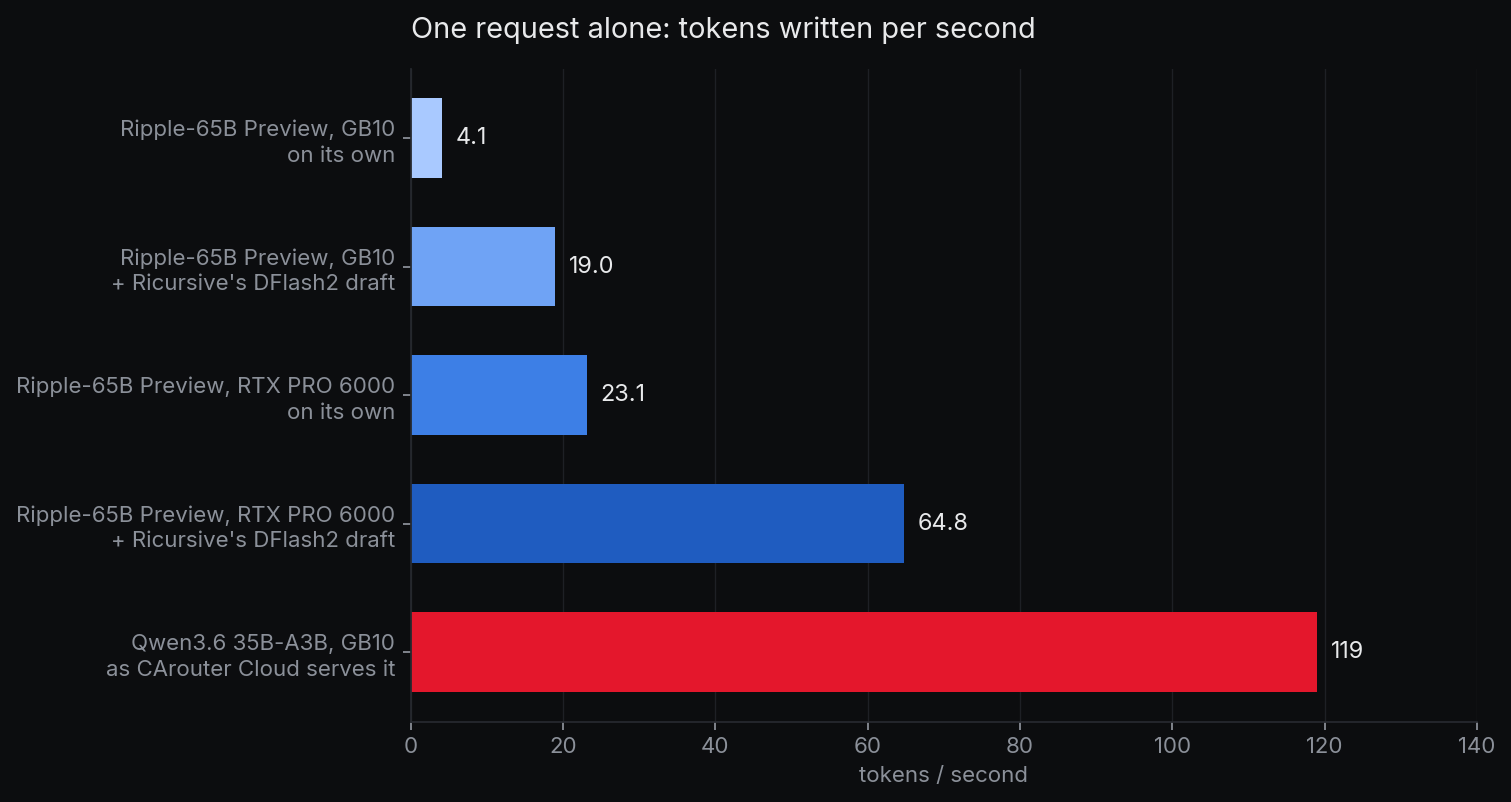
Un modèle dense relit tous ses poids en mémoire pour chaque token qu'il écrit, et les poids à 4 bits de Ripple pèsent 57 Go. Le GB10 déplace 273 Go par seconde : une requête plafonne donc vers 4.8 tokens par seconde, et Ripple atteint 4.1.
La RTX PRO 6000 déplace 1.8 To par seconde, six fois et demie plus. Ripple y écrit 23.1 tokens par seconde, soit 74 % du plafond de cette carte.
Qwen3.6 35B-A3B, le modèle derrière le point d'accès de programmation de CArouter Cloud, mobilise environ 3 milliards de ses paramètres pour chaque token. Sur le GB10, il écrit 119 tokens par seconde tel que nous le servons.
Le modèle brouillon DFlash2
Un modèle brouillon devine les quelques tokens suivants, et le modèle principal les vérifie tous en un seul passage sur ses poids. Ricursive publie DFlash2 pour Ripple, un brouillon de 8 Go, et nous l'avons laissé deviner 7 tokens à la fois, comme le prévoit la recette de vLLM pour Ripple.
Sur un GB10 où nous avons aussi relevé les compteurs de vLLM, Ripple a accepté en moyenne 3 des 7 propositions : chaque passage sur les poids a donc écrit 4 tokens au lieu d'un. Une requête est passée de 4.1 à 19.0 tokens par seconde sur le GB10, et de 23.1 à 64.8 sur la RTX PRO 6000.
Le gain diminue à mesure que les requêtes s'ajoutent : un passage sur les poids sert déjà toutes les requêtes à la fois, et vérifier les propositions de chacune ajoute du travail. Avec seize requêtes simultanées, le brouillon multiplie le total par 3.2 sur le GB10 et par 2.7 sur la RTX PRO 6000.
Lecture de la requête
Avant d'écrire, un modèle lit toute la requête. Sur le GB10, Ripple a lu une requête de 8 500 tokens à environ 830 tokens par seconde : le premier token est arrivé au bout d'une dizaine de secondes. La RTX PRO 6000 l'a lue à environ 3 400 tokens par seconde, en 2.5 secondes.
La lecture dépend du calcul plutôt que de la mémoire, et la taille du modèle y pèse de tout son poids. Sur le GB10, Qwen3.6 35B-A3B lit une requête environ huit fois plus vite.
Qualité
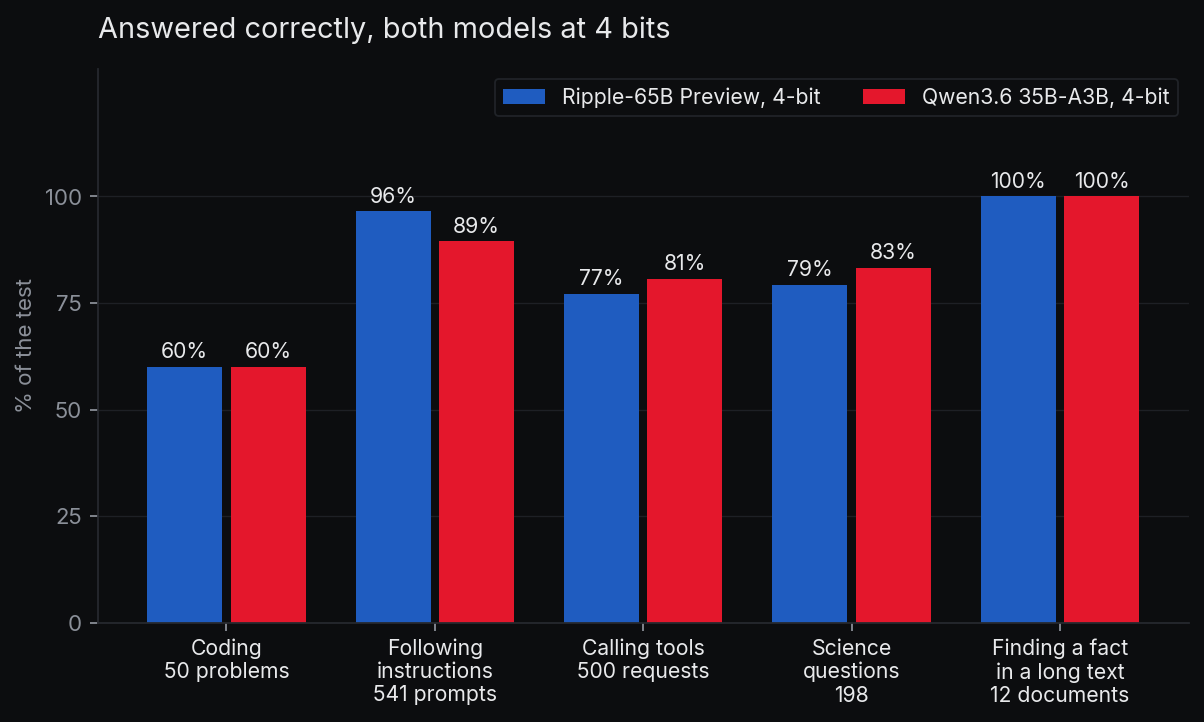
Nous avons lancé les cinq tests de nos bancs d'essai précédents sur une RTX PRO 6000, où ils ont pris moins de trois heures. Les scores de Qwen viennent de nos passages précédents sur les mêmes tests, avec le même outillage.
Les consignes sont le point fort de Ripple. Sur les 541 requêtes d'IFEval, il a suivi toutes les consignes de 522 d'entre elles, et Qwen de 484 : un écart trop net pour le hasard.
En programmation, les deux font jeu égal : sur 50 problèmes de BigCodeBench, chacun en a résolu 30. Tous deux ont aussi retrouvé une phrase cachée dans des documents de 16 000 à 100 000 tokens, 12 fois sur 12.
Pour les appels d'outils, le bilan est partagé. Quand une requête exige un outil, Ripple est souvent le plus précis : 60 appels simples réussis sur 62, contre 57 pour Qwen. Quand la bonne réponse est un simple texte, il sort plus souvent un outil, et réussit au total 386 requêtes sur 500, contre 403.
Les questions scientifiques prennent du temps à Ripple. Sur GPQA Diamond, il a répondu juste à 157 questions sur 198, contre 165 pour Qwen, et 20 de ses réponses ont atteint notre limite de 32 768 tokens en plein raisonnement, contre 7 pour Qwen : nous les comptons comme fausses. Ricursive annonce 85.2 % pour le modèle en pleine précision, à son effort maximal.
Avec des échantillons de cette taille, le hasard peut expliquer les écarts sur les appels d'outils et les questions scientifiques : les deux modèles restent proches sur ces deux points.
Notre méthode
Nous avons servi la version NVFP4 de Ricursive, avec les couches feed-forward à 4 bits et l'attention à 16, sur la première version de vLLM qui prend en charge Ripple, une nightly du 6 novembre.
Les chiffres de vitesse viennent de notre outil de bancs d'essai, qui démarre le modèle sur un GB10 ou une RTX PRO 6000 puis lance notre sonde de débit. La sonde maintient 1, 4 ou 16 requêtes en cours pendant 30 secondes après 10 secondes de mise en route, compte chaque token écrit dans cette fenêtre, puis chronomètre une longue requête seule. Les requêtes demandent du code.
Avec un brouillon, chaque fragment du flux porte plusieurs tokens : la sonde compte donc les tokens tels que le moteur les déclare. Comptée fragment par fragment, une fenêtre avec le brouillon donnait 3.4 tokens par seconde, là où le moteur en écrivait 15.8.
Nous avions fait tourner les deux configurations sur un second GB10 au préalable. Ripple seul y a obtenu les chiffres ci-dessus à 3 % près.
Les tests de qualité ont tourné avec le modèle brouillon, qui conserve la distribution des réponses, et avec l'échantillonnage par défaut de vLLM, que le checkpoint de Ripple laisse en place. Chaque réponse disposait de 32 768 tokens au plus, et de 8 192 pour le test du long texte.
Ce qui reste à mesurer
- Le travail d'agent. Ricursive annonce 80.5 % au Terminal-Bench 2.1 et 79.1 % au SWE-Bench Pro v2.0 Hard, et nos tests portent sur des requêtes isolées.
- L'échantillonnage. Ripple a tourné à la température par défaut de vLLM, 1.0, et Qwen avec les réglages de son checkpoint : l'un ou l'autre choix déplace un score de quelques points.
- Le long contexte. Ricursive a entraîné Ripple jusqu'à un million de tokens, et nous l'avons testé jusqu'à 100 000.
- Les autres moteurs et versions. Le notebook DGX Spark de Ricursive utilise SGLang avec 32 tokens de brouillon, et sa version en pleine précision demande 130 Go. Nous avons mesuré la version à 4 bits sur vLLM, avec 7.