Nemotron 3.5 Lightning 30B-A3B face à Qwen3.6 35B-A3B : banc d'essai sur un GB10
Sur un GB10 à 4 bits, le Nemotron 3.5 Lightning 30B-A3B de NVIDIA égale en vitesse le Qwen3.6 35B-A3B que nous servons, et son cache de contexte contient 5.6 fois plus de tokens dans la même mémoire. Il programme et suit les consignes aussi bien, mais appelle les outils moins sûrement, 76 % contre 81 %, et ne répond juste qu'à 68 % des questions scientifiques, contre 83 %.
NVIDIA a publié Nemotron 3.5 Lightning 30B-A3B en août. Le modèle compte 30 milliards de paramètres, dont environ 3 milliards travaillent sur chaque token. Qwen3.6 35B-A3B, le modèle derrière le point d'accès de programmation de CARouter Cloud, est bâti sur le même gabarit.
NVIDIA publie Lightning à 4 bits pour vLLM, le moteur que nous utilisons, avec un petit modèle brouillon recommandé pour le DGX Spark. Nous l'avons fait tourner sur le GB10, la puce du DGX Spark et de notre propre serveur, puis comparé à nos résultats précédents pour Qwen.
Le dernier modèle testé de cette façon : Nemotron 3.5 Bolt E4B face à Qwen3.6 35B-A3B.
En bref
- Vitesse pour une requête. Les deux font jeu égal. Avec le modèle brouillon DSpark de NVIDIA, Lightning écrit 116 tokens par seconde. Qwen en écrit 119 tel que nous le servons.
- Vitesse à plusieurs. Avec seize requêtes à la fois, Lightning totalise 489 tokens par seconde et Qwen 473. L'écart est trop mince pour compter.
- Place pour le contexte. Dans la même mémoire, le cache de contexte de Lightning contient 7.0 millions de tokens, contre 1.25 million pour Qwen.
- Qualité. Lightning programme et suit les consignes aussi bien que Qwen. Il appelle les outils moins sûrement, 76 % contre 81 %, et répond juste à moins de questions scientifiques, 68 % contre 83 %.
Vitesse
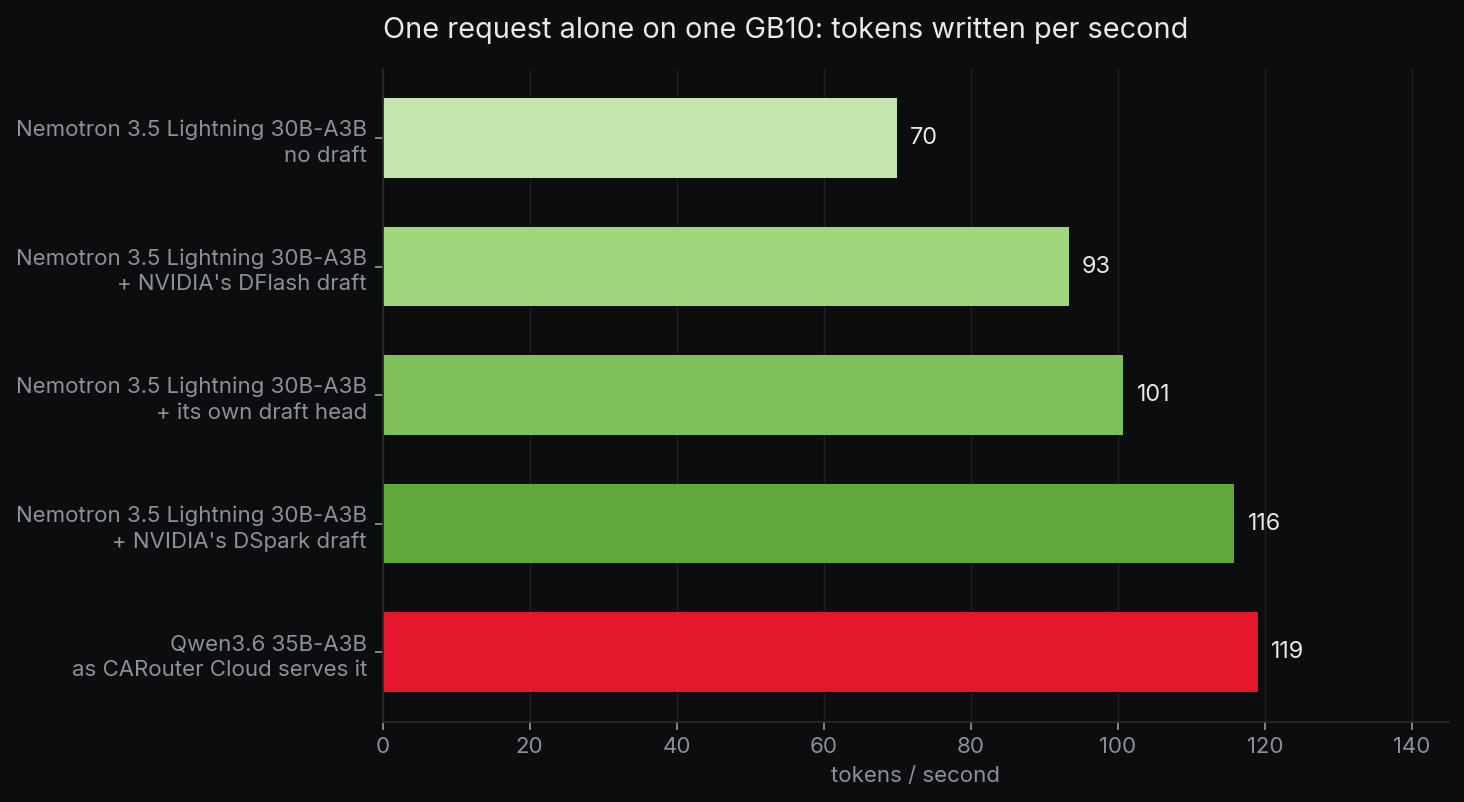
Un modèle brouillon est un petit modèle qui devine les quelques tokens suivants. Le modèle principal les vérifie ensuite d'un seul coup. Lightning peut en utiliser trois, et NVIDIA recommande DSpark sur un DGX Spark. Nos résultats lui donnent raison : DSpark va 1.66 fois plus vite que sans brouillon et devance les deux autres.
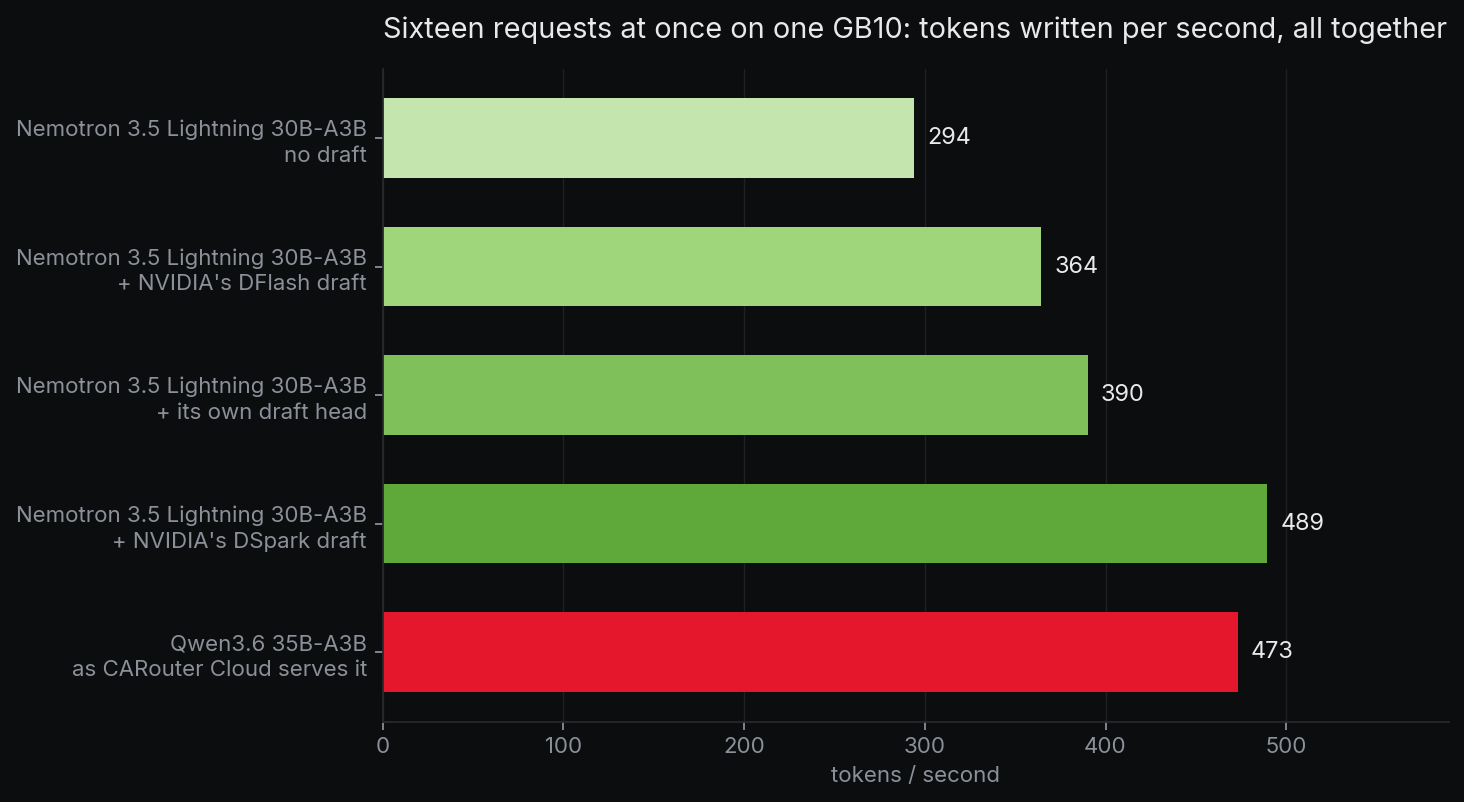
DSpark conserve tout son gain sous la charge : encore 1.66 fois plus vite avec seize requêtes. Lors de notre dernier essai, le modèle brouillon de Bolt E4B perdait les trois quarts de la vitesse à la même charge.
Les deux modèles lisent une requête à environ 6 500 tokens par seconde. Les chiffres de Qwen viennent de notre banc d'essai précédent. Une courte reprise sur cette machine de test les a retrouvés à moins de 4 % près : les deux séries se comparent donc.
De la place pour les longues conversations
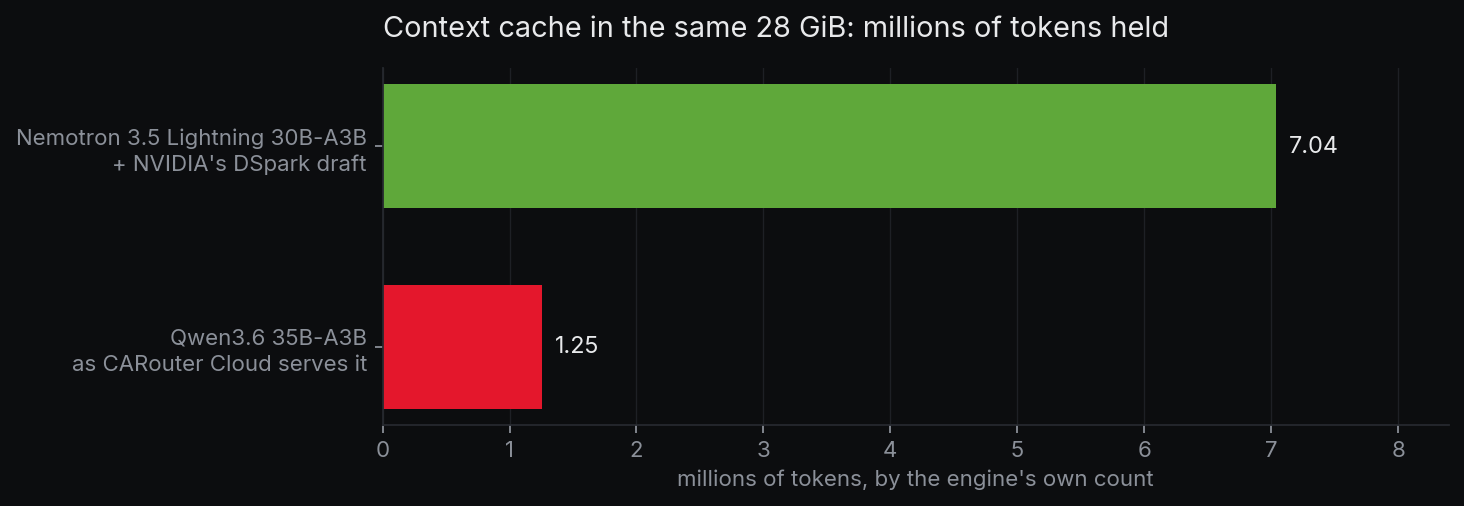
Un serveur garde le contexte de chaque conversation dans un cache, et ce cache limite le nombre de longues requêtes traitées en même temps. Nous avons donné 28 Gio à chaque modèle. Pour des requêtes de 262 144 tokens, la fenêtre de notre Qwen, Lightning en loge 27 et Qwen 5.
L'écart a deux causes. Seules 6 des 52 couches de Lightning sont des couches d'attention, celles qui doivent retenir chaque token ; ses 23 couches Mamba se contentent d'un petit état de taille fixe. La version de NVIDIA range aussi le cache sur 8 bits, celle de Qwen sur 16.
Ce chiffre est celui que donne le moteur au démarrage. Nous n'avons pas rempli le cache avec de vraies conversations : il reste un plafond tant que personne ne l'a fait.
Un court échange avec un agent
Nous avons repris notre essai de l'enceinte de cuisine : quatre outils et douze demandes d'une même personne, dont la moitié exigent un outil. Avec le raisonnement activé, Lightning et son brouillon commencent à répondre au bout de 1.1 seconde, Qwen au bout de 1.9. Lightning raisonne en 120 tokens environ, Qwen en 215.
Avec le raisonnement activé, les deux modèles ont choisi le bon outil, ou aucun, aux douze tours. Sans raisonnement, les deux démarrent en moins d'un quart de seconde, mais trois des quatre configurations de Lightning ont commis une erreur : elles ont annoncé les lumières du bureau éteintes sans appeler l'outil.
Qualité
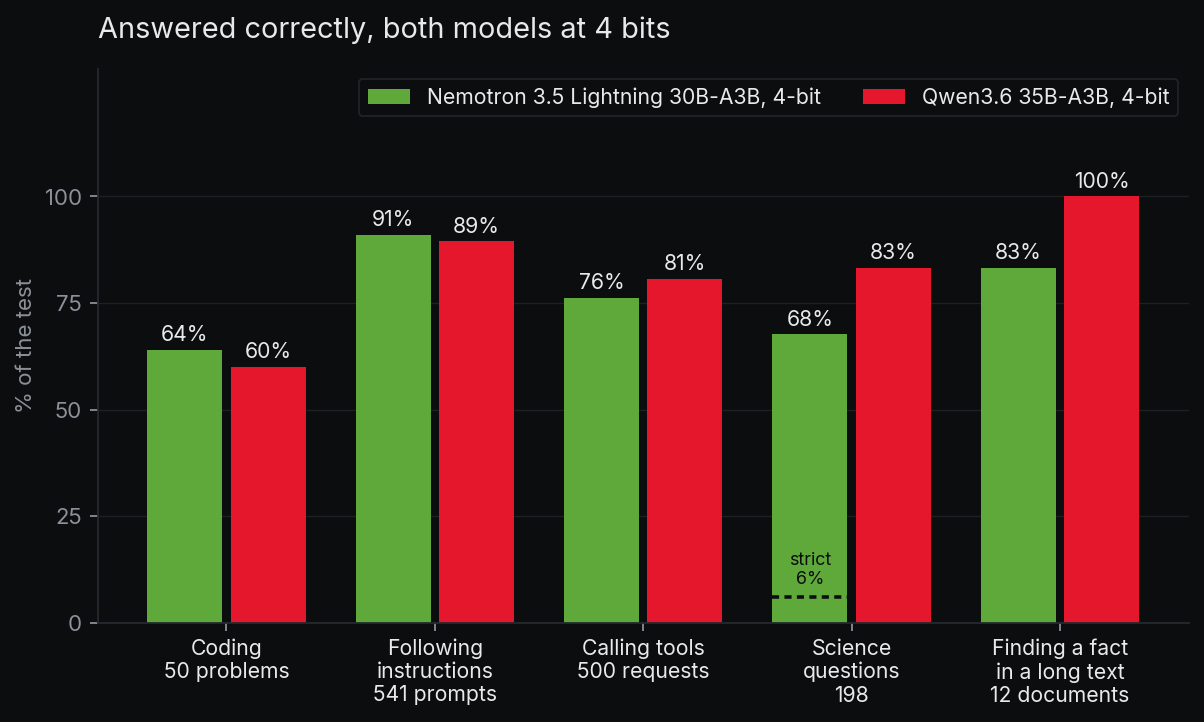
Sur 50 problèmes de BigCodeBench, Lightning en a résolu 32 et Qwen 30. Sur les 541 requêtes d'IFEval, Lightning a suivi toutes les consignes de 492 d'entre elles et Qwen de 484. Le hasard peut expliquer ces deux écarts.
Pour les appels d'outils, la différence est réelle. Sur 500 requêtes du banc d'essai d'appels de fonctions de Berkeley, Lightning en a réussi 381 et Qwen 403, et le hasard l'explique mal.
L'écart tient surtout à une catégorie, les requêtes qui exigent plusieurs outils différents à la fois : 19 sur 44 pour Lightning, 35 pour Qwen. Dans 22 cas, Lightning a fait un seul appel, puis s'est arrêté. Un agent pourrait obtenir les autres appels au tour suivant, mais ce test n'en lit qu'un.
Pour les sciences, une mise en garde s'impose. Le test demande la réponse sous la forme « ANSWER: $LETTER ». Lightning recopie le signe de dollar et en ajoute un second : « ANSWER: $D$ ». Le correcteur n'y voit aucune réponse, d'où un score de 12 sur 198.
Une fois ces signes acceptés, Lightning répond juste à 134 questions sur 198, et Qwen, dont le score ne bouge pas, à 165. Tout programme qui demande ce format à Lightning doit s'attendre à cette habitude.
Lightning raisonne aussi plus longtemps sur ces questions. Il a atteint notre limite de 32 768 tokens sans répondre sur 30 d'entre elles, contre 7 pour Qwen, et nous les comptons comme fausses. NVIDIA annonce 76 % à ce test pour la même version.
Nous avons aussi caché une phrase dans des documents de 16 000 à 100 000 tokens, puis demandé de la retrouver. Qwen y parvient 12 fois sur 12, Lightning 10 fois. Les deux échecs de Lightning surviennent en plein raisonnement, une fois épuisés les 8 192 tokens que nous accordons.
Ce que nous ne pouvons pas vous dire
- Comment les deux se comparent sur un long travail d'agent. Le tableau de NVIDIA donne à Qwen 70 % à SWE-bench Verified, contre 53 % pour Lightning, et nous n'avons testé que des requêtes isolées.
- Combien de longues conversations Lightning tient vraiment sous la charge. Le chiffre du cache vient du décompte du moteur et ne mesure aucun trafic réel.
- Comment il se comporte au-delà de 262 144 tokens. NVIDIA le valide jusqu'à un million, et nous ne l'avons pas testé.
- Ce qu'il donne sur llama.cpp. Nous n'avons mesuré la version à 4 bits que sur vLLM.
- Ce qu'il donne en français ou dans les autres langues de son entraînement. Nous n'avons testé que l'anglais.
- Si un écart de quelques points sur nos plus petits tests est réel. Cinquante problèmes de programmation ne suffisent pas à classer deux modèles aussi proches.