Kolibri-1 face à Qwen3.6 35B-A3B : banc d'essai sur un GB10
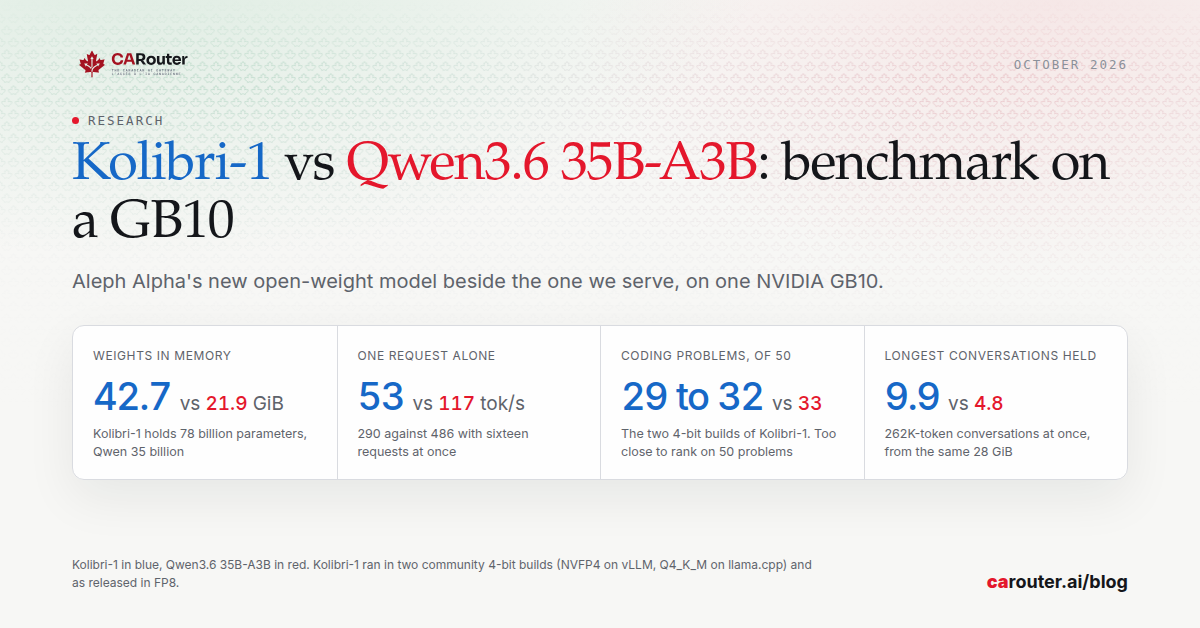
Kolibri-1, le nouveau modèle à poids ouverts d'Aleph Alpha, lit environ 3 milliards de paramètres par token, comme le Qwen3.6 35B-A3B que nous servons. Sur un GB10 et à 4 bits, il a résolu de 29 à 32 de nos 50 problèmes de programmation, contre 33 pour Qwen, avec deux fois plus de mémoire et une vitesse deux fois moindre.
Aleph Alpha a publié Kolibri-1 le 3 octobre. C'est un modèle allemand à poids ouverts, sous licence Apache 2.0, conçu pour l'allemand et l'anglais. Il compte 78 milliards de paramètres et n'en lit qu'environ 3,5 milliards pour chaque token qu'il écrit.
C'est ce dernier chiffre qui a retenu notre attention. Qwen3.6 35B-A3B, le modèle qui répond aux requêtes de programmation sur CARouter Cloud, lit environ 3 milliards de paramètres par token sur 35 milliards. Les deux modèles fournissent un travail comparable par token, et l'un est plus de deux fois plus gros que l'autre. Nous les avons fait tourner sur le même GB10 pour voir ce que coûte cette taille et ce qu'elle rapporte.
Un article précédent : pourquoi nous servons Qwen3.6 35B-A3B.
En bref
- Mémoire. À 4 bits, les poids de Kolibri-1 occupent 42,7 Gio, contre 21,9 Gio pour Qwen. Dans la version FP8 que publie Aleph Alpha, ils occupent 73,5 Gio et le modèle retient 103 Gio sur une machine qui en compte 121,6.
- Vitesse. Une requête seule reçoit 53 tokens par seconde de Kolibri-1 et 117 de Qwen. Avec seize requêtes à la fois, les totaux sont de 290 et de 486.
- Programmation. Sur nos 50 problèmes de programmation, Kolibri-1 en a résolu de 29 à 32 selon la version, et Qwen 33. Cinquante problèmes ne suffisent pas à départager ces résultats.
- Longues conversations. Kolibri-1 les retient pour moitié moins cher : les mêmes 28 Gio contiennent 9,9 conversations de 262 144 tokens, contre 4,8 pour Qwen.
- Notre décision. Nous n'ajoutons pas Kolibri-1 à la machine de CARouter Cloud. Il lui faudrait deux fois plus de mémoire pour répondre à peu près aussi bien aux requêtes de programmation, deux fois moins vite.
Deux modèles qui lisent autant l'un que l'autre par token
Les deux modèles sont des mélanges d'experts. Chaque couche contient des centaines de petits réseaux spécialisés, et chaque token n'est confié qu'à quelques-uns. Tous doivent tenir en mémoire, mais seuls ceux qui sont choisis sont lus.
Kolibri-1 garde 384 experts par couche et en sollicite 6 par token. Qwen3.6 35B-A3B en garde 256 et en sollicite 8. Le travail par token est voisin : la vitesse devrait donc l'être aussi, et la mémoire non.
Quel Kolibri-1 nous avons testé
Aleph Alpha publie Kolibri-1 en FP8, soit 8 bits par poids. Nous servons nos propres modèles à 4 bits, et Aleph Alpha ne propose aucune version à 4 bits. Nous en avons donc retenu deux, produites par la communauté dès les premiers jours :
- La plus téléchargée, un fichier Q4_K_M au format GGUF. Elle tourne sur llama.cpp, moyennant un correctif fourni par son auteur, car llama.cpp ne connaît pas encore cette architecture.
- Une version NVFP4. Elle tourne sur vLLM, le logiciel avec lequel nous servons nos modèles, dans le même format à 4 bits que notre Qwen. C'est elle qui permet de comparer à conditions égales.
Nous avons aussi testé la version FP8 d'origine, pour distinguer ce qui tient au modèle de ce qui tient à sa compression. Chaque modèle était seul sur la machine, avec les réglages par défaut de son éditeur et le raisonnement activé.
Mémoire
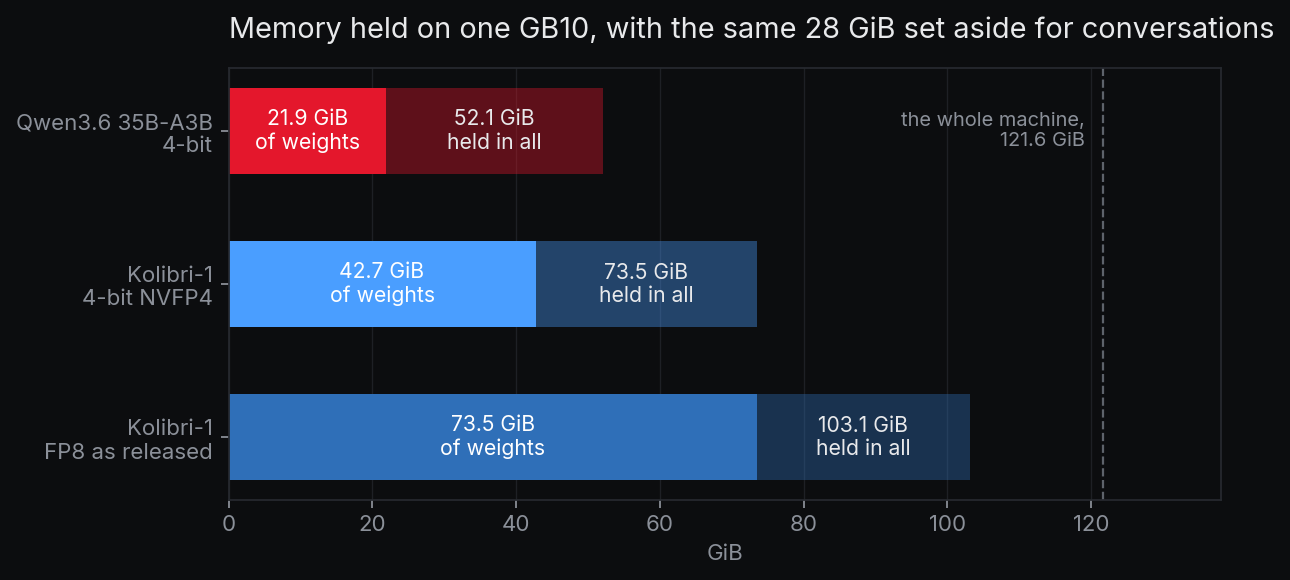
À 4 bits, Kolibri-1 demande 21 Gio de plus que Qwen, et ce ne sont que des poids. Sur une machine qui sert aussi des embeddings, un modèle de reclassement et notre modèle de décision, c'est exactement la place qu'occupent ces autres modèles.
La version FP8 tient sur la machine, mais elle y tient seule. Il ne restait que 10 Gio de libres.
Sur l'autre versant de la mémoire, l'avantage va à Kolibri-1. Un modèle doit aussi retenir chaque conversation en cours, et la plupart des couches de Kolibri-1 ne regardent que les 512 derniers tokens. Avec les mêmes 28 Gio, il retient 2,59 millions de tokens de conversation, contre 1,25 million pour Qwen.
Vitesse
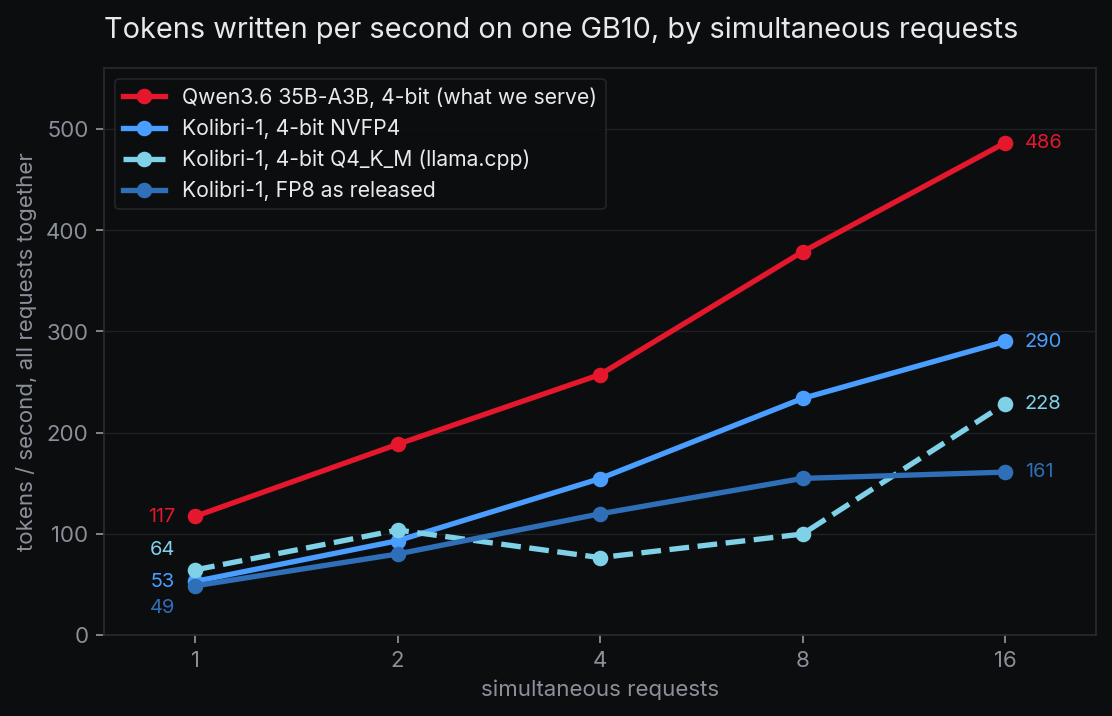
Qwen est de 1,6 à 2,2 fois plus rapide, quelle que soit la charge. Il le doit en partie à une fonction que Kolibri-1 n'a pas : Qwen est livré avec un petit assistant qui rédige les prochains tokens pour que le modèle principal les vérifie, ce qui lui fait gagner moitié plus de vitesse sur cette machine. Sans cet assistant, Qwen écrivait 75 tokens par seconde pour une requête seule, ce qui reste au-dessus des 53 de Kolibri-1.
Pour un utilisateur seul, une réponse type à l'un de nos problèmes de programmation prenait 37 secondes à Qwen. Le même problème en demandait environ 91 à Kolibri-1.
Pour la lecture du prompt, les deux modèles font jeu égal. Sur vLLM, l'un comme l'autre lit un prompt de 12 000 tokens à un rythme de 6 400 à 6 800 tokens par seconde.
La version GGUF, sur un autre moteur, se comporte tout autrement. Seule, c'est le Kolibri-1 le plus rapide, avec 64 tokens par seconde. Elle partage mal la machine, avec des totaux irréguliers entre deux et huit requêtes, et elle lit un prompt trois fois moins vite. Sur vLLM, passer de 8 à 4 bits a aussi accéléré Kolibri-1, jusqu'à 80 % sous charge.
Qualité
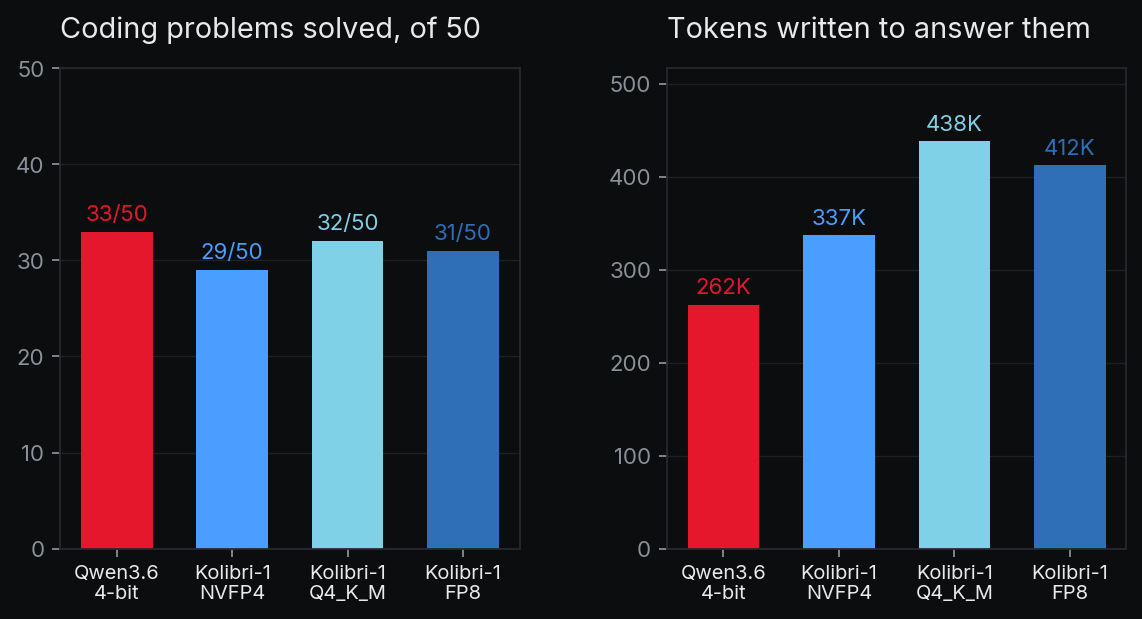
Nous soumettons les mêmes 50 problèmes de BigCodeBench à chaque modèle que nous étudions : le modèle écrit une fonction Python, puis cette fonction est exécutée contre des tests. Qwen en a résolu 33, comme sur notre propre machine en août.
Kolibri-1 en a résolu 32 dans la version Q4_K_M, 29 en NVFP4 et 31 en FP8. Les modèles s'accordent sur la plupart des problèmes : Q4_K_M et Qwen ont donné le même résultat pour 47 des 50. Sur 50 problèmes, aucun de ces écarts n'est statistiquement significatif.
Kolibri-1 réfléchit plus longtemps pour y arriver. Pour les mêmes 50 réponses, il a écrit de 1,3 à 1,7 fois plus de tokens que Qwen. Or ce sont les tokens qu'un client paie, et ce sont eux qu'il attend.
Nous avons aussi caché une phrase dans des documents allant jusqu'à 220 000 tokens, puis demandé au modèle de la retrouver. Chaque modèle y est parvenu chaque fois qu'il est allé au bout de sa réponse. Quatre fois sur quarante-huit, un modèle a épuisé en raisonnement tout le budget alloué à la réponse : Qwen une fois, Kolibri-1 trois fois.
Les résultats publiés par Aleph Alpha vont dans le même sens. Ils placent Kolibri-1 légèrement devant Qwen3.6 35B-A3B dans une épreuve de programmation, et derrière lui dans une autre.
Ce que nous ne pouvons pas vous dire
- Ce que vaut Kolibri-1 en allemand. C'est sa première langue et son principal argument, et nous ne l'avons pas testée. Nous n'avons pas testé le français non plus.
- Si un écart de quelques problèmes est réel. Pour détecter une différence aussi faible, il en faudrait plusieurs centaines.
- Comment se comporterait une version officielle à 4 bits. Les deux que nous avons testées viennent de la communauté, sans le concours d'Aleph Alpha.
- Ce que fait Kolibri-1 au-delà de 262 144 tokens. Aleph Alpha le valide jusqu'à un million.
- Ce qu'il obtient en raisonnant davantage. Nous avons laissé l'effort de raisonnement à sa valeur par défaut, alors que les résultats publiés par Aleph Alpha utilisent le réglage le plus élevé.
Ce que cela change pour CARouter
La machine de CARouter Cloud garde Qwen3.6 35B-A3B. Pour programmer en anglais, Kolibri-1 nous a donné à peu près les mêmes réponses, avec deux fois plus de mémoire et plus de deux fois plus d'attente.
Ce verdict vaut pour une machine et pour un usage. Kolibri-1 est un modèle sous licence Apache 2.0, entraîné de zéro en Europe. Il gère les longues conversations à peu de frais, et son allemand est justement ce que nous n'avons pas mesuré. Un usage en allemand, ou un fournisseur disposant de plus de mémoire par machine, pèserait ces chiffres autrement.