Pourquoi nous servons désormais Qwen3.6 35B-A3B plutôt que Qwen3.8 27B
Un modèle dense de 27B doit lire ses 23,4 Go au complet pour écrire un seul token, ce qui, sur notre DGX Spark, plafonne à environ 12 tokens par seconde avant toute spéculation. Un MoE de 35B n'en active que 3B et en lit 2,0 Go. Il est 1,5 à 1,9 fois plus rapide à tous les niveaux de simultanéité, préremplit 3,2 fois plus vite et tient 2,26 fois plus de sessions - et sur nos 50 problèmes BigCodeBench appariés, il fait 33 contre 33, pour la moitié des tokens.
Pendant quatre jours, CARouter Cloud a servi Qwen3.8 27B, et les trois billets qui précèdent racontent comment nous l'avons accéléré : un meilleur modèle brouillon, puis de meilleurs réglages pour ce brouillon, qui ensemble l'ont fait passer de 20,8 à 34,8 tokens par seconde et par flux. Cela n'a pas suffi. Un modèle dense de 27B sur une machine offrant 273 Go/s de bande passante mémoire doit lire ses 23,4 Go au complet pour produire un seul token, et aucun réglage ne change cette arithmétique. Depuis aujourd'hui, le point d'accès de codage fait tourner Qwen3.6 35B-A3B à la place - un modèle plus ancien, moins bien classé sur les palmarès publics de codage, et plus gros : 35B contre 27B. Il est aussi une fois et demie à deux fois plus rapide sur tout ce que nous avons mesuré, et nous n'avons pas réussi à trouver la qualité que nous étions censés y perdre.
En bref
- Le problème. Un modèle dense lit chacun de ses paramètres pour chaque token qu'il écrit. Sur les 273 Go/s du GB10, cela imposait à Qwen3.8 27B un plafond d'environ 12 tokens par seconde avant toute spéculation, et la conséquence concrète était l'attente : sur une plateforme agentique automatisée, une compilation de codage ordinaire prenait une heure.
- La solution, qui semble absurde. Un modèle plus gros. Qwen3.6 35B-A3B compte 35B de paramètres mais n'en active que 3B par token : il lit donc 2,0 Go par passe avant plutôt que 23,4. Il occupe les mêmes 21,8 Gio sur disque.
- Le débit. 62,2 tokens par seconde en flux unique contre 34,8, et 367 contre 241 avec seize flux simultanés - de 1,5x à 1,9x à chaque niveau de concurrence mesuré. Le préremplissage est 3,2x plus rapide : environ 6 600 tokens par seconde contre 2 088 sur une invite de 12K. La compilation qui prenait une heure en prend dix minutes.
- Les sessions simultanées. À partir du même budget KV de 36 Gio, il retient 1 837 064 tokens contre 813 427 - 7,0 sessions complètes de 262K tokens à la fois contre 3,1. Seules 10 de ses 40 couches conservent un cache qui grandit avec la conversation ; les 30 autres gardent une taille constante.
- La qualité que nous pensions perdre. Les palmarès publics le placent une dizaine de points derrière sur LiveCodeBench v6. Sur les cinquante problèmes BigCodeBench que nous exécutons nous-mêmes, appariés sur les mêmes problèmes et la même machine, il obtient 33/50 contre 32/50 pour le 27B - un écart d'un seul problème, avec un p exact de McNemar de 1,000. Sur la récupération en contexte long, il fait mieux : 10/10 contre 9/10, et 10/10 contre 8/10 à 220K tokens.
- La réserve honnête. Cinquante problèmes ne peuvent pas détecter un écart de dix points ; il en faudrait environ 218. L'affirmation n'est donc pas que les deux modèles sont aussi intelligents l'un que l'autre - c'est que nous avons cherché la différence sur notre propre charge de travail sans la trouver, alors que l'écart de vitesse était impossible à manquer.
Pourquoi un modèle dense finit par plafonner
Générer un token consiste à lire les poids du modèle en mémoire et à multiplier. Pour un modèle dense, c'est la totalité des poids, à chaque fois. Qwen3.8 27B en NVFP4 en représente 23,4 Go, et le GB10 déplace environ 273 Go/s : au mieux, il peut donc écrire 273 divisé par 23,4 - environ 12 tokens par seconde. Tout ce que les deux billets précédents ont obtenu, c'est du décodage spéculatif qui contourne ce chiffre sans le changer : un modèle brouillon devine plusieurs tokens d'avance, le gros modèle les vérifie en une passe, et ceux qui sont acceptés sortent d'un coup. Cela nous a menés à 34,8 tokens par seconde, soit environ trois tokens acceptés par étape à 12 par seconde.
Un modèle épars à mélange d'experts casse l'arithmétique au lieu de la contourner. Qwen3.6 35B-A3B contient 256 experts et achemine chaque token vers 8 d'entre eux : bien que les 35B de paramètres résident tous en mémoire, seuls 3B environ sont lus par passe avant - 2,0 Go au lieu de 23,4. Le plafond passe de 12 tokens par seconde à environ 140. Le modèle est plus gros et le fichier sur disque fait la même taille ; ce qui change, c'est la quantité qu'il faut toucher pour produire un mot.
Ce que nous avons mesuré
Les deux modèles sur la même machine, le même budget KV de 36 Gio, la même limite de 16 séquences, l'un remplacé par l'autre puisqu'ils ne tiennent pas ensemble. Décodage agrégé selon le nombre de flux simultanés :
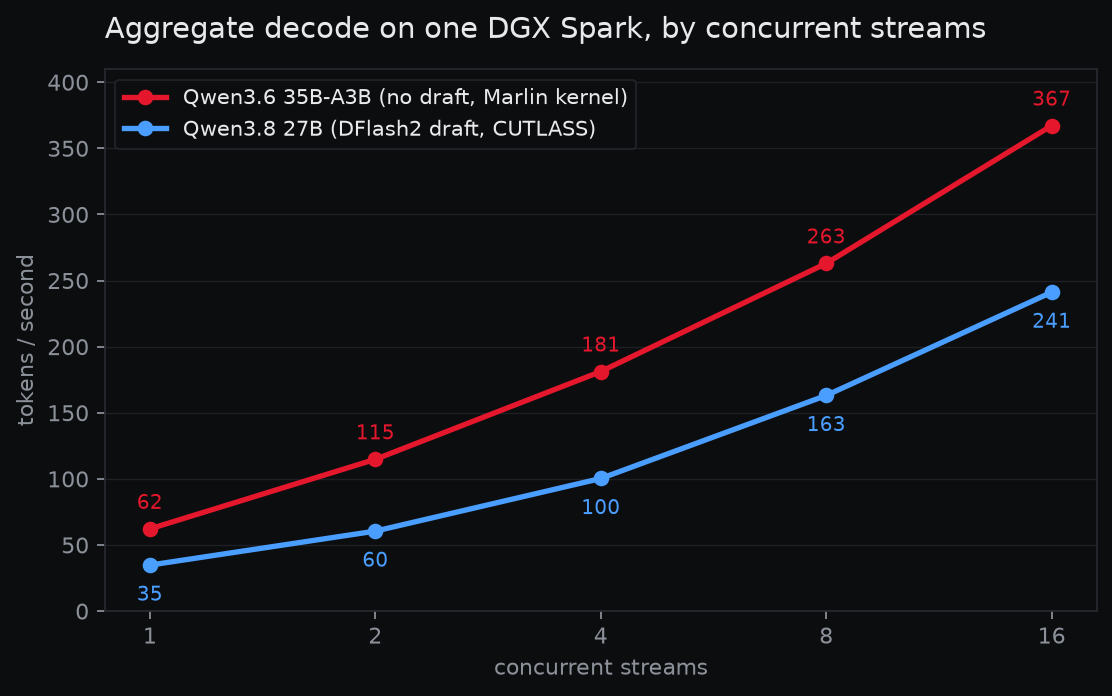
Deux détails font que ce graphique sous-estime le résultat. Le 35B-A3B tournait sans aucun décodage spéculatif, alors que le 27B disposait du brouillon DFlash2 à sept tokens livré dans le billet précédent, qui obtient environ 3,9 tokens acceptés par étape. Et ses experts tournaient sur le noyau Marlin de vLLM, qui décompresse les poids 4 bits et les multiplie en 16 bits, là où le 27B bénéficie du chemin CUTLASS de FlashInfer. Ce second point tient au checkpoint et non à la machine : NVIDIA quantifie ce modèle en W4A16, des poids sur quatre bits contre des activations sur seize, et les noyaux CUTLASS veulent aussi les activations en FP4, accompagnées de facteurs de calibration qu'un checkpoint W4A16 ne porte jamais. Ce sont donc des planchers sur les deux plans.
La mémoire est l'autre moitié, et sur une machine à mémoire partagée c'est celle qui détermine combien de personnes vous pouvez servir à la fois :
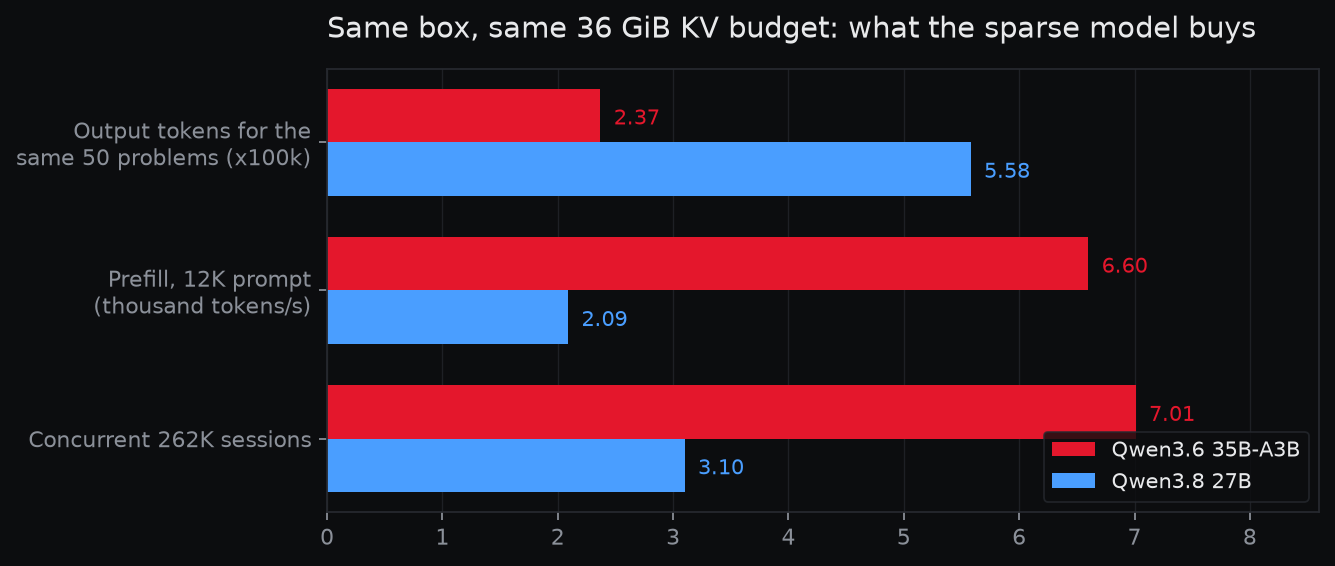
Le nombre de sessions simultanées provient du journal de démarrage du moteur lui-même : 1 837 064 tokens en cache contre 813 427 à budget identique. La raison est architecturale. Seules 10 des 40 couches du 35B-A3B utilisent le type d'attention dont le cache grandit avec la longueur de la conversation ; les 30 autres sont des couches à attention linéaire qui gardent un état de taille fixe par session, quelle que soit sa durée. Le 27B dense conserve un cache croissant sur 16 de ses 64 couches, et chacune coûte davantage par token. Deux fois plus de sessions, à mémoire égale, n'est pas un gain de réglage - c'est ce que donne la disposition des couches.
La partie qui devait faire mal
Qwen3.6 appartient à une génération antérieure à Qwen3.8, et les évaluations de codage publiées le disent : LiveCodeBench v6 place le modèle épars à 80,4 contre 90,3 pour le modèle dense. Dix points ne sont pas une erreur d'arrondi, et nous ne voulions pas le découvrir en production.
Nous avons donc soumis les deux modèles aux mêmes cinquante problèmes BigCodeBench, sur la même machine, dans le même bac à sable Docker, sans plafond de tokens et avec des réglages identiques. Puis nous avons fait ce que nous aurions dû faire plus tôt : remesurer le 27B au lieu de nous fier à son score d'il y a quatre jours. Cet ancien chiffre avait été obtenu avec un autre brouillon, une autre version de vLLM, et lors d'une exécution que le bogue de délai d'attente de l'outil d'évaluation avait morcelée et relancée. Réexécuté proprement, le modèle dense obtient 32/50 là où il obtenait 33/50 auparavant.
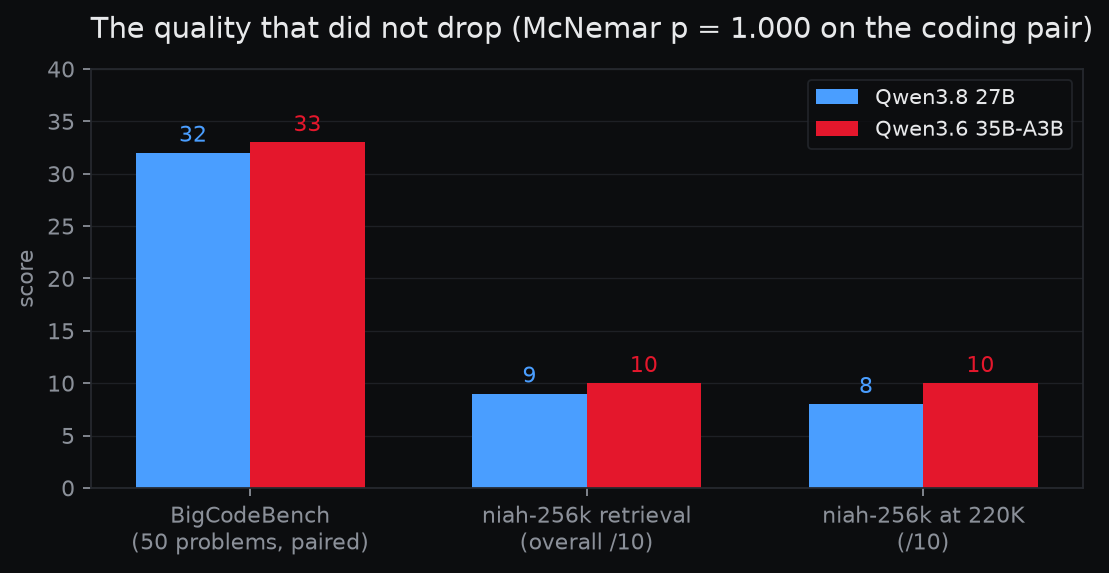
Appariés sur les mêmes cinquante problèmes, les deux modèles s'accordent sur 43 d'entre eux - 29 résolus par les deux, 14 échoués par les deux. Le modèle épars en résout quatre à lui seul, le dense trois, et un test exact de McNemar sur ces sept désaccords donne un p bilatéral de 1,000. C'est le résultat le plus plat qu'un test apparié puisse produire.
La récupération en contexte long est allée exactement dans l'autre sens. Nous cachons un fait dans une botte de foin allant jusqu'à 220 000 tokens et demandons au modèle de le retrouver, à trois profondeurs pour chacune des quatre longueurs. Le modèle dense obtient 9 sur 10 au total et descend à 8 à la longueur maximale. Le modèle épars obtient 10 sur 10, à chaque longueur et à chaque profondeur. C'était le résultat le plus susceptible de le disqualifier - nous vendons un contexte de 262 144 tokens, et un modèle qui répond vite mais perd le fil au fond d'un long fichier serait une régression qu'aucun score de codage ne révélerait - et c'est celui qui est revenu le plus solide.
Il atteint aussi le même score avec beaucoup moins de mots : 236 949 tokens sortants pour les cinquante problèmes contre 558 275, avec un échantillon médian de 4 773 tokens contre 9 142. Le modèle dense a atteint notre plafond de 32 768 tokens sur au moins un problème ; le modèle épars n'a jamais dépassé 12 253. Les deux modèles raisonnaient - l'épars a enregistré 219 951 tokens de raisonnement sur les cinquante échantillons - il s'agit donc de concision et non d'un mode de réflexion resté désactivé. Pour un point d'accès facturé au token et qui conserve un contexte par session, arriver à la même réponse en moins de la moitié des mots vaut autant que les tokens par seconde.
Ce que nous ne pouvons pas vous dire
Cinquante problèmes ne suffisent pas à détecter une différence de dix points. Détecter un effet aussi faible avec une puissance de 80 % exige environ 218 problèmes appariés, et les exécuter coûte une journée de machine pendant laquelle le point d'accès ne sert personne. Notre résultat ne réfute donc pas le palmarès ; il signifie que sur la seule évaluation de codage que nous exécutons nous-mêmes, les deux modèles étant mesurés la même semaine sur le même matériel, nous n'avons pas trouvé l'écart.
Nous n'avons par ailleurs mesuré que le codage et la récupération en contexte long, rien d'autre. Le raisonnement général, le suivi d'instructions et le comportement agentique multitour ne sont pas testés ici, et les écarts publiés sur ces plans sont peut-être bien réels. Ce que nous pouvons dire, c'est que sur une plateforme agentique automatisée qui exécute de longues compilations autonomes, plusieurs tâches de codage simples qui prenaient une heure sur le modèle dense se terminent en une dizaine de minutes sur celui-ci, sans baisse de qualité visible dans le résultat.
La forme honnête de la décision est celle-ci : nous avons échangé une différence que nous ne pouvions pas mesurer contre une différence que nous ne pouvions pas manquer. Une requête qui attend en file, ou qui défile à demi-vitesse, est un moins bon résultat pour la personne qui attend qu'une réponse légèrement plus faible arrivée rapidement - et un modèle trop lent pour répondre à la demande ne vaut rien du tout pour les requêtes qu'il refuse.
Ce qui tourne maintenant
Qwen3.6 35B-A3B en NVFP4, sur le même GB10 derrière le même proxy TLS, au même prix : 0,20 $ par million de tokens entrants et 0,80 $ par million en sortie. Il répond au nom qwen3.6-35b-a3b, conserve le contexte complet de 262 144 tokens, lit les images, appelle les outils et renvoie son raisonnement. Qwen3.8 27B est retiré du catalogue et, comme il n'était servi que depuis notre propre matériel, il disparaît simplement au lieu d'être acheminé ailleurs.
Son fichier de configuration reste dans le dépôt, et revenir en arrière tient en une ligne. Deux chantiers restent ouverts, et nous nous étions trompés sur les deux à la parution de ce billet. Le modèle brouillon n'a besoin d'être publié par personne : ce checkpoint porte déjà une tête de prédiction multi-tokens, une couche d'attention et d'experts entraînée à deviner le token d'après, inutilisée dans des poids que nous avions déjà téléchargés. Et le noyau ne consiste pas à réclamer CUTLASS, qu'aucun checkpoint W4A16 ne peut utiliser ; il faudrait soit une version de ce modèle quantifiée pour des activations FP4, soit le noyau SM12x fusionné de vLLM, écrit précisément pour cette puce et simplement jamais retenu automatiquement. Ce sont des mesures que nous vous devons et non des gains que nous pouvons revendiquer, et tous les chiffres ci-dessus ont été mesurés sans l'un ni l'autre.