Régler le décodage spéculatif sur le DGX Spark de CARouter : des réponses de code deux tiers plus rapides, à matériel constant
Le décodage spéculatif fait deviner à un petit modèle « brouillon » les tokens à venir, pour que le gros puisse en vérifier plusieurs d'un coup. Quelles suppositions il fait, et comment elles sont vérifiées, étaient deux réglages laissés à leur valeur par défaut. Les changer a fait passer notre point d'accès de code auto-hébergé de 20,8 à 34,8 tokens par seconde et par flux, sur la même machine - et a renversé la longueur de bloc que nous avions déployée une semaine plus tôt, qui s'est révélée être un fait sur le réglage par défaut plutôt que sur le matériel.
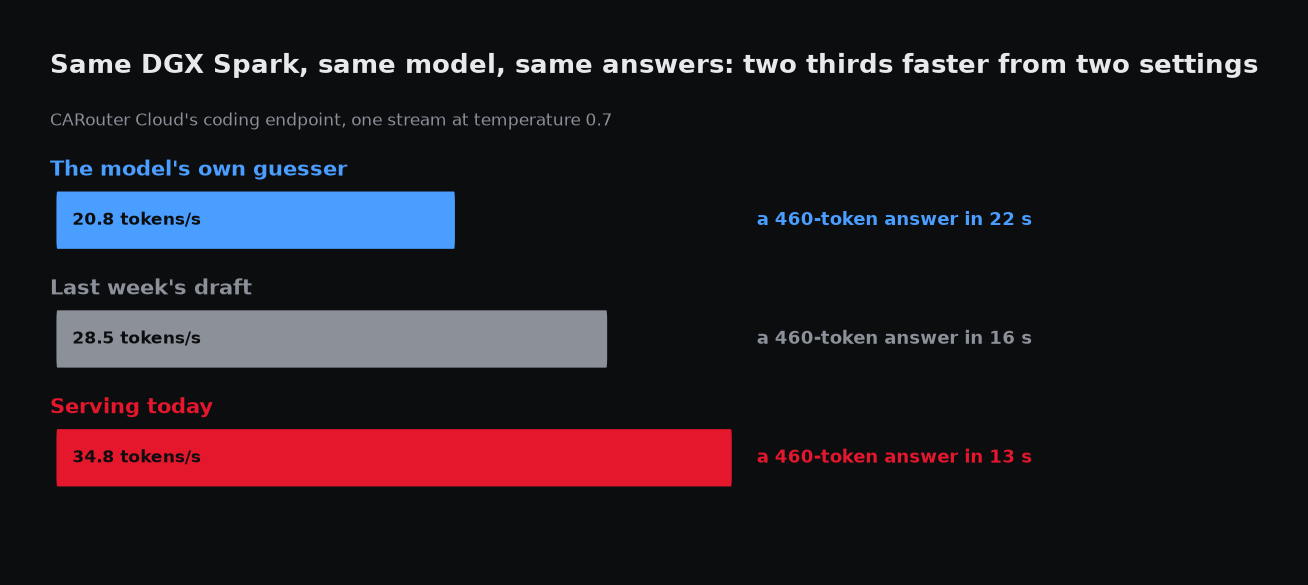
Le décodage spéculatif fait deviner à un petit modèle « brouillon » plusieurs tokens d'avance, pour que le gros puisse tous les vérifier en une seule passe et garder ceux avec lesquels il est d'accord. Quelles suppositions le brouillon fait, et comment elles sont vérifiées, se révèlent être deux réglages que nous avions laissés à leur valeur par défaut. Les changer - deux clés dans un fichier de configuration, aucun matériel neuf, aucun changement à ce que le modèle écrit - a fait passer le point d'accès de code de notre machine auto-hébergée de 20,8 à 34,8 tokens par seconde et par flux : deux tiers plus vite que le prédicteur intégré au modèle, et 22 % plus vite que ce que nous avions déployé la semaine dernière. Voici ce que fait chaque réglage, pourquoi chacun est une perte tout seul, et la conclusion de la semaine dernière que les deux ensemble ont renversée.
En bref
- Ce que voit un client. Le point d'accès de code écrit une réponse deux tiers plus vite qu'avant tout ce réglage : un token toutes les 29 ms au lieu de 48, une réponse typique de 460 tokens en 13 secondes environ au lieu de 22. Rien ne change dans les réponses elles-mêmes.
- Le réglage efficace. draft_sample_method: "probabilistic" fait échantillonner le brouillon dans sa propre distribution à la température de la requête, secoué par le même bruit aléatoire que l'échantillonnage du gros modèle, au lieu de toujours prendre sa meilleure supposition. Le test d'acceptation compare alors deux vraies distributions au lieu de lire une probabilité sur une certitude.
- Les deux réglages doivent être combinés. La vérification par bloc, la règle d'acceptation sans perte que nous recommandions à la fin du dernier article, perd toute seule : 22 % de moins à deux flux et 11 % de moins à huit, à la température que les clients obtiennent par défaut. Le brouillon probabiliste seul gagne à partir de deux flux et abandonne un dixième du décodage à flux unique, qui est exactement là où se trouve un agent de code. Ensemble, ils se couvrent l'un l'autre.
- Notre erreur nous a aussi appris quelque chose. La semaine dernière, nous avons mesuré les suppositions les plus profondes du brouillon, constaté qu'elles ne se rentabilisaient pas, et déployé un bloc raccourci. C'était vrai du réglage par défaut, dont nous n'avions pas remarqué qu'il était une prémisse.
- La longueur de bloc optimale a donc changé. Le brouillon échantillonné de façon probabiliste, nous avons relancé le balayage des longueurs de bloc sur quatre, cinq, six et sept. Le bloc natif de sept tokens du brouillon l'a emporté : 34,8 tokens/s à flux unique contre 29,3 pour le bloc de cinq, et 28,6 contre 24,7 à la température que les clients obtiennent par défaut.
- Le coût. Rien de mesurable. La distribution mise en cache du brouillon pèse environ 106 Mio, absorbés ; le chargement des poids est inchangé à 24,92 Gio ; le budget de cache cède 3 % au cache du bloc plus profond ; le traitement du prompt ne bouge pas.
Ce que nous avons dit la semaine dernière, et pourquoi c'était conditionnel
Le balayage de la semaine dernière a trouvé que les positions quatre à sept du bloc natif du brouillon étaient acceptées 28 %, 22 %, 15 % et 12 % du temps. Ces quatre positions ajoutaient 0,77 token accepté par étape, ce qui est gratuit à un ou deux flux et du vrai travail à seize ; raccourcir le bloc à cinq gardait donc le gain à flux unique et rendait le régime par lots positif à toutes les tailles. Nous avons écrit « un cinq statique fait l'affaire sur cette machine » et l'avons déployé.
Relisez cela avec une semaine de recul. Chaque chiffre y est un chiffre d'acceptation, et l'acceptation n'est pas une propriété de la machine, ni du modèle, ni de la charge de travail seule. C'est une propriété de la façon dont le brouillon est produit et vérifié. Nous avons mesuré une seule règle de brouillon - prendre la meilleure supposition, à chaque fois - et tiré une conclusion sur la profondeur du bloc comme si profondeur et brouillon étaient indépendants. Ils ne le sont pas, et c'est la partie de tout l'exercice qui se généralise : chaque fois que la règle de brouillon change, la question de la profondeur doit être reposée.
Le réglage : échantillonner le brouillon comme le modèle échantillonne
La configuration spéculative de vLLM a une clé que nous avions écartée. draft_sample_method vaut "greedy" par défaut : le brouillon propose son unique continuation la plus probable, et le test d'acceptation traite cette proposition comme une certitude - probabilité un sur le token choisi, zéro partout ailleurs. Mettez-la à "probabilistic" et deux choses changent.
La première est dans le brouillon. Le sélecteur de DFlash2 parcourt un faisceau de seize candidats par position ; en mode par défaut il prend celui au meilleur score, et en mode probabiliste il échantillonne parmi eux à la température propre à la requête. Le noyau qui fait cela porte un commentaire qui mérite d'être cité, parce qu'il contient toute l'idée en une ligne : « Les identifiants des candidats indexent le bruit, en accord avec l'échantillonnage du modèle cible. » Le brouillon et le gros modèle sont secoués par le même bruit aléatoire, si bien que lorsque le gros modèle échantillonne de façon stochastique, le brouillon tend à faire le même choix stochastique.
La seconde est dans le vérificateur. Avec une vraie distribution derrière lui, les scores du brouillon sont mis en cache et le test d'acceptation devient le véritable rapport entre la probabilité du gros modèle et celle du brouillon, au lieu d'une probabilité lue sur une certitude. C'est ce qui donne un sens au second réglage - la vérification par bloc.
Nous avions écrit dans nos propres notes que cette option s'appliquait à la tête intégrée de Qwen et non à ce brouillon. C'était faux, et c'est la lecture du code qui l'a corrigé : le spéculateur DFlash2 redéfinit précisément la méthode qui alloue le cache dont ce mode a besoin, justement pour qu'il fonctionne avec lui.
Constat 1 : le réglage sans perte recommandé ralentit le décodage lorsqu'il est utilisé seul
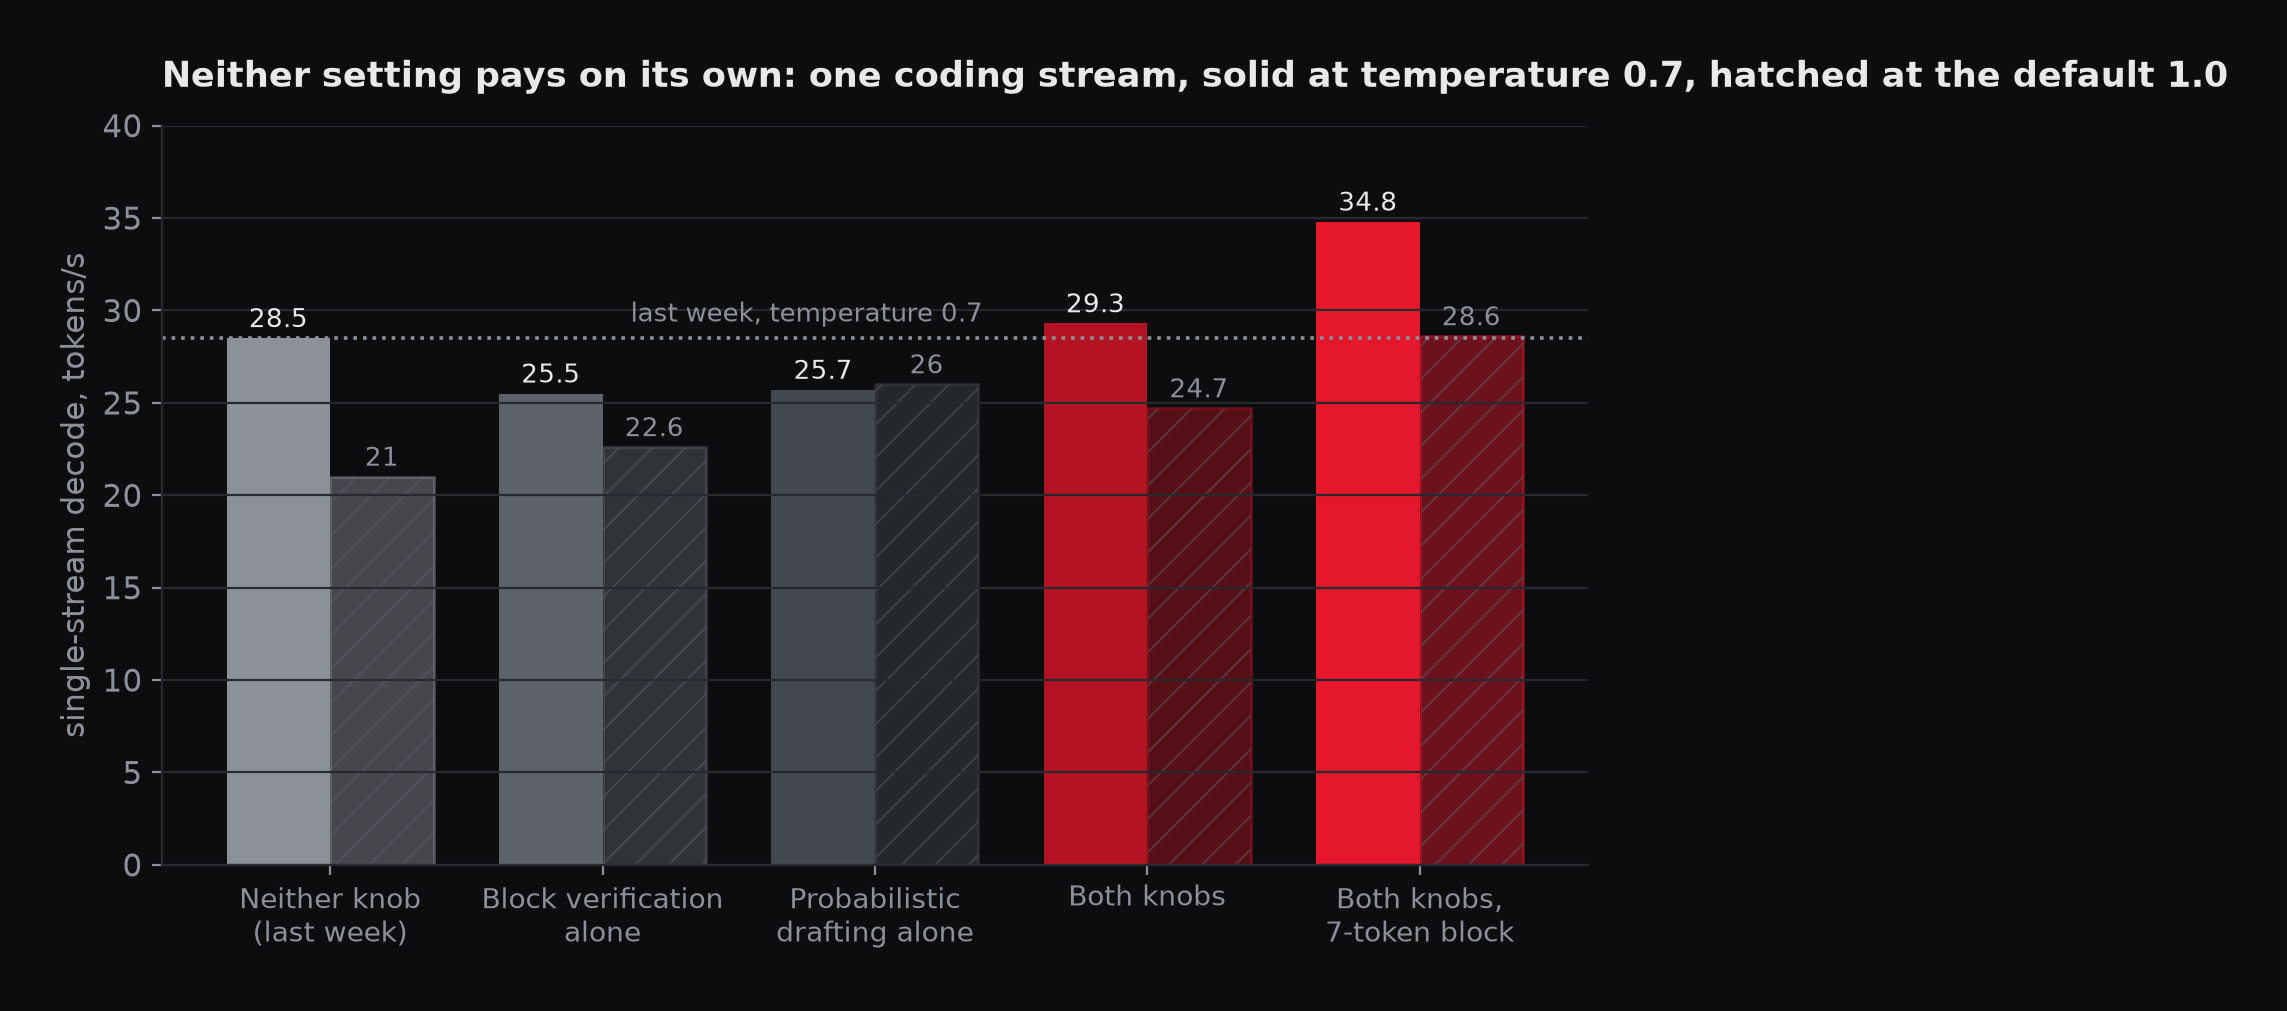
La dernière phrase de la semaine dernière désignait la vérification par bloc comme le levier suivant : une règle d'acceptation sans perte qui vérifie tout le bloc brouillonné d'un coup plutôt qu'un token à la fois. Elle existe bel et bien, elle fonctionne avec ce brouillon, et elle ne coûte pas de mémoire - le démarrage affiche le même chargement de poids et la même taille de cache. Elle perd aussi. À température 0,7 elle tombe partout dans la dispersion existante, ce que la théorie prédit : la vérification par bloc est démontrablement identique à la règle ordinaire quand rien n'est tiré au hasard, et une sonde de code à 0,7 en est proche. À température 1,0, là où le gain était censé se trouver, elle donne 37,8 tokens/s à deux flux contre 48,7 et 120,1 à huit contre 134,7 - et ce chiffre à huit flux est de trois exécutions à moins de 2,2 tokens/s les unes des autres, ce n'est donc pas du bruit. L'acceptation n'a jamais augmenté.
La raison est celle que pose la section précédente. Un brouillon qui prend sa meilleure supposition est une certitude ; la règle conjointe n'a donc presque rien de plus à exploiter que ce que la règle token par token obtenait déjà, tandis que son arithmétique supplémentaire est facturée à chaque étape et mord dès que le lot s'élargit. Une règle sans perte n'est pas automatiquement une règle gratuite.
Constat 2 : le brouillon probabiliste gagne par lots et perd là où se trouve l'agent
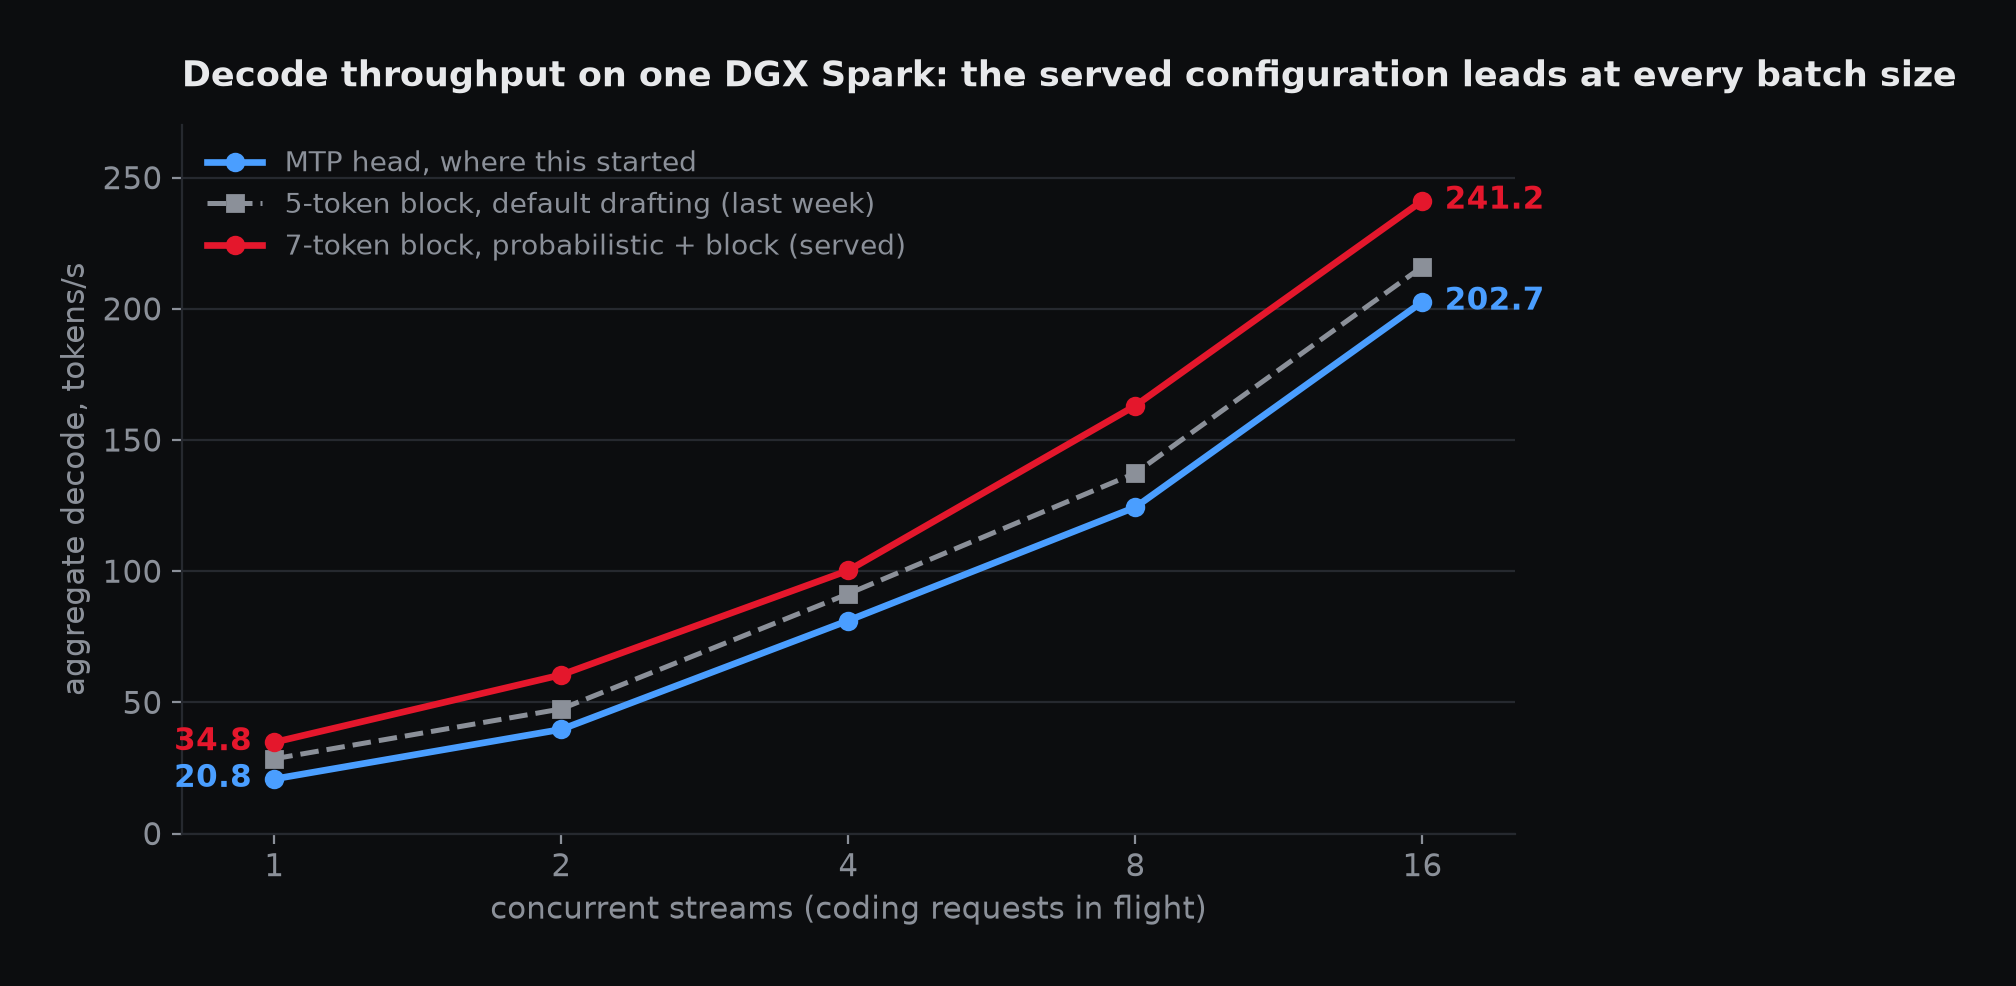
Échantillonné de façon probabiliste au bloc de cinq tokens, le décodage est de 25,7, 57,1, 101,2, 163,5 et 246,0 tokens/s à un, deux, quatre, huit et seize flux, contre 28,5, 47,5, 91,4, 137,4 et 216,1 pour le même bloc au réglage par défaut. À partir de deux flux, cela fait +20 %, +11 %, +19 % et +14 %, et l'acceptation monte avec - de 3,0 à 3,9 tokens par étape là où le brouillon au meilleur choix atteignait 2,7 à 3,0. À un flux il abandonne un dixième, et un flux est précisément là où se trouve un agent de code.
À la température que les clients obtiennent par défaut, le tableau s'inverse : le flux unique passe à 26,0 contre 21,0, soit +24 %, parce que coupler le hasard du brouillon à celui du gros modèle compte le plus précisément là où le gros modèle est le plus aléatoire. Un réglage qui vaut +24 % ou -10 % à flux unique selon un paramètre que le client contrôle n'est pas un réglage qu'on déploie seul.
Constat 3 : combiner les réglages change la longueur de bloc optimale
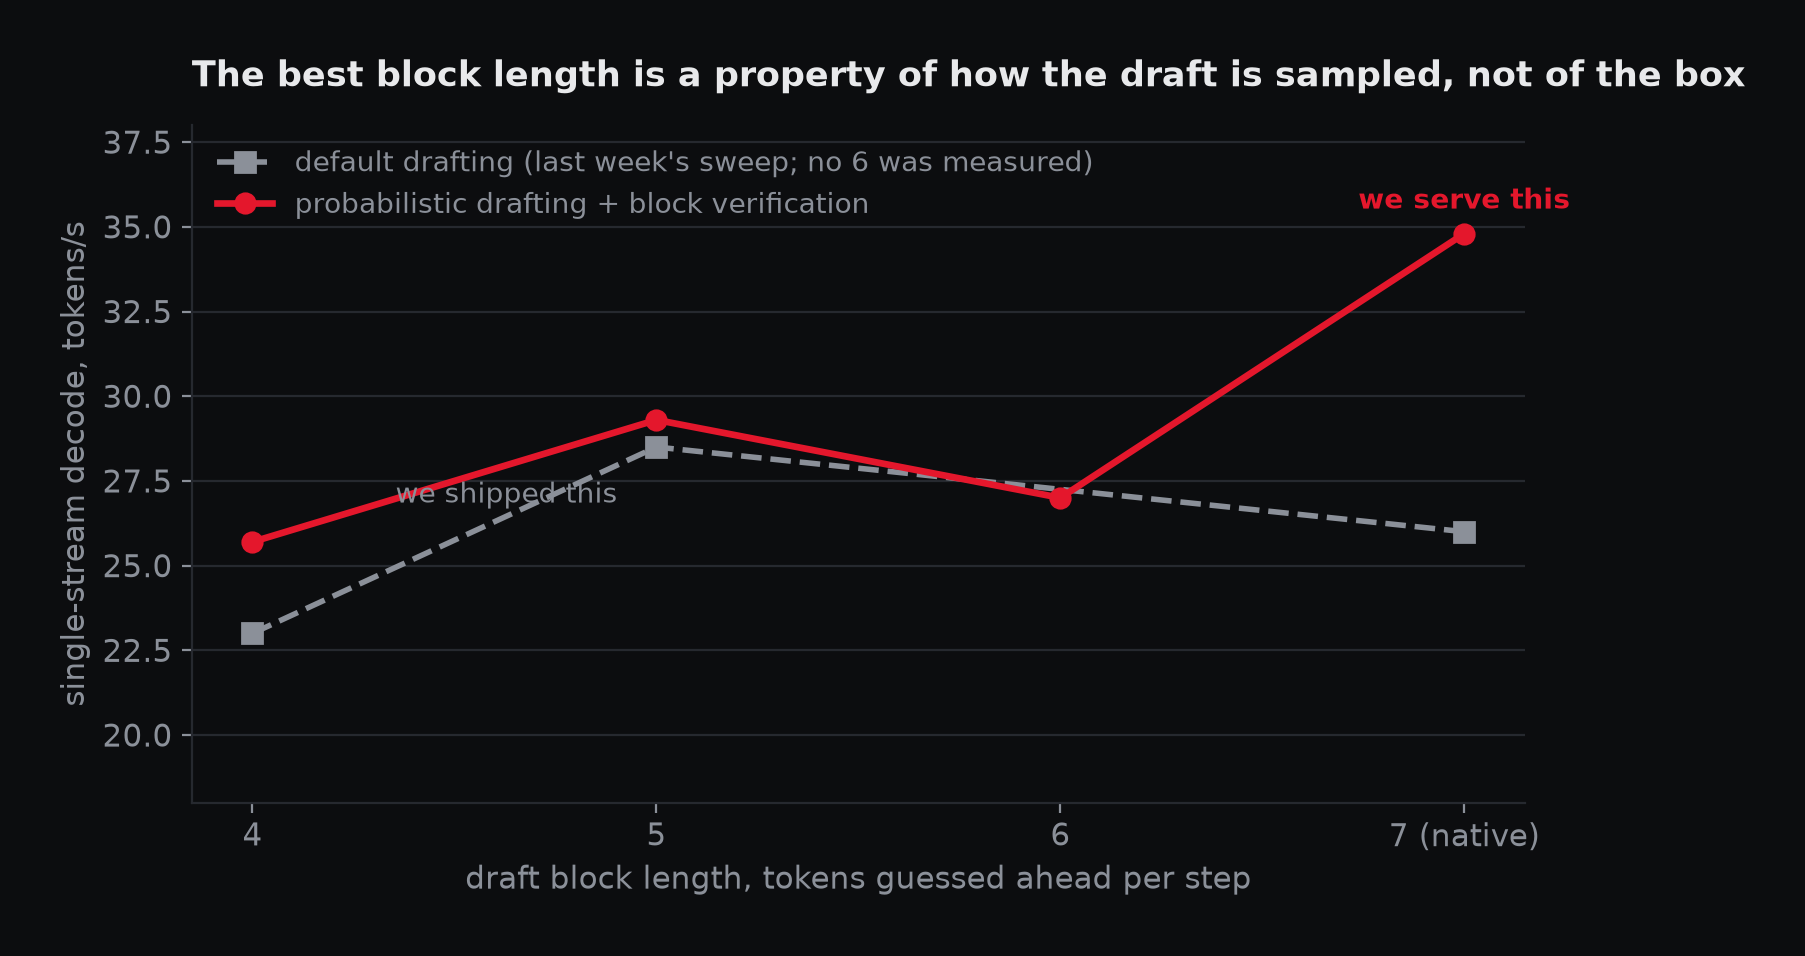
Ajouter la vérification par bloc par-dessus le brouillon probabiliste répare la case à flux unique - 29,3 tokens/s contre 25,7 - parce qu'il existe désormais une vraie distribution de brouillon sur laquelle la règle conjointe peut travailler. Cette combinaison n'a aucune case mesurée sous la règle ordinaire, à l'une ou l'autre température ; son pire cas est -2 %. Nous avons donc relancé le balayage des longueurs de bloc avec elle, pendant la nuit, quatre longueurs à deux températures, les cases bruitées répétées trois fois.
Sept - le bloc que le brouillon a été entraîné à prédire, et celui que nous avions rejeté il y a une semaine - gagne 19 % à flux unique à température 0,7 et 16 % à 1,0, et 9 % et 12 % à deux flux, pour 2 à 5 % rendus à quatre et seize. Comme notre plateforme fait tourner un ou deux agents à la fois, c'est l'arbitrage que nous voulons, et c'est le même que celui de la semaine dernière quand nous avons choisi cinq plutôt que quatre.
La preuve convaincante n'est pas le débit, bruité sur cette machine, mais l'acceptation : de 3,85 à 4,83 tokens par étape à sept contre 3,18 à 3,92 à cinq, six se plaçant entre les deux et quatre sous les deux. Un ordre net dans le sens que le mécanisme prédit vaut plus que n'importe quelle exécution rapide isolée.
Constat 4 : une exécution n'est pas une mesure, et cela a failli nous coûter cher
Le brouillon probabiliste seul a produit 178,5 tokens/s à huit flux - sa meilleure case, et 13 % devant la combinaison que nous allions déployer. Nous l'avons signalée dans la demande de fusion comme une exécution unique, donc non fiable, et l'avons remesurée pendant la nuit : 161,8, 167,8, 160,9, soit une moyenne de 163,5. Le 178,5 était une valeur aberrante, l'écart réel est d'environ 4 %, et la décision qu'elle aurait renversée était la bonne.
Nous le consignons parce que c'est la deuxième fois en deux articles que la variance de cette machine a failli écrire la mauvaise conclusion, et parce que la discipline qui l'a rattrapée est peu coûteuse : indiquer le nombre d'exécutions à côté de chaque chiffre, et remesurer tout ce qui changerait une décision à soi seul.
Ce que cela signifie pour nos clients
- Les réponses s'écrivent deux tiers plus vite qu'avant tout ce réglage. À flux unique et à température 0,7, les tokens arrivent toutes les 29 ms, contre 35 ms après le changement de la semaine dernière et 48 ms avec le prédicteur intégré au modèle. La réponse moyenne sur notre trafic fait environ 460 tokens : à peu près 13 secondes, contre 16 la semaine dernière et 22 auparavant.
- À la température par défaut, le gain est plus grand que celui de la semaine dernière, pas plus petit. Un client qui ne règle rien obtient 28,6 tokens/s là où la configuration de la semaine dernière en donnait 21,0. C'est le cas que ce changement aide le plus, et c'est le plus fréquent.
- Une machine chargée partage désormais le gain correctement. Avec quatre à seize agents qui décodent en même temps, chacun obtient 19 à 31 % de plus que la tête intégrée, là où le bloc de la semaine dernière donnait 7 à 13 %.
- Le premier token arrive toujours au même moment. Le décodage spéculatif ne touche pas au traitement du prompt, et celui-ci n'a pas bougé : environ 2 000 tokens/s tout du long.
- Régler une température rapporte toujours plus que ce que nous pouvons vous donner. Un client qui envoie 0,7 pour du code au lieu de laisser la valeur par défaut de 1,0 obtient environ 22 % de décodage en plus, contre les 10 % que nous annoncions la semaine dernière.
- Le code est inchangé, par construction. Le décodage spéculatif accepte exactement les tokens que le gros modèle aurait produits de toute façon - voyez toutefois la première réserve ci-dessous, qui porte sur la qualité de notre vérification plutôt que sur la véracité du principe.
Ce que cela coûte, et ce que nous avons déployé
La distribution mise en cache du brouillon pèse environ 106 Mio, absorbés sans rien changer d'autre : le même chargement de poids de 24,92 Gio, le même démarrage à froid de sept minutes. Le bloc plus profond taille davantage dans le budget de cache de 36 Gio pour son propre usage, si bien que le budget tient 813 427 tokens au lieu de 838 501 - 3,10 contextes de 262K simultanés au lieu de 3,20, une réduction de 3 %. Le traitement du prompt est inchangé.
Déployé : Qwen3.8-27B NVFP4 avec un brouillon DFlash2 de sept tokens, draft_sample_method "probabilistic" et rejection_sample_method "block", sur la même image vLLM 0.28.0, même proxy, même nom servi, même contexte de 262K. Les deux réglages vont ensemble dans la spécification, avec un commentaire qui le dit, parce que l'un ou l'autre pris seul est une régression quelque part.
Les réserves honnêtes
- Nous n'avons pas vérifié empiriquement l'absence de perte. Le décodage spéculatif accepte exactement les tokens que le gros modèle aurait produits - c'est une propriété de la construction, et c'est pourquoi nous répétons que la qualité est intacte. Mais nous avons changé le chemin d'échantillonnage et n'avons confirmé que le bon fonctionnement du chat, des appels d'outils, de l'entrée image et du raisonnement, pas que la distribution de la sortie soit inchangée. L'exécution de référence qui l'aurait vérifié a échoué sur un bogue de notre propre outil d'évaluation, qui écrasait les réglages par tâche sur toutes les tâches d'une exécution multitâche ; c'est corrigé, et la vérification reste due.
- Les mesures à flux unique varient beaucoup. Les trois exécutions derrière les 34,8 du bloc en service étaient 39,7, 33,1 et 31,5. Chaque chiffre ici est une moyenne accompagnée de son nombre d'exécutions, et les cases par lots comptent deux à trois exécutions là où celles de la semaine dernière n'en avaient souvent qu'une.
- Une machine, une sonde, une nuit. Même GB10, même checkpoint, même sonde de génération de code que dans les deux articles précédents, chaque configuration faisant l'objet d'un redémarrage distinct.
- Le modèle brouillon n'est toujours pas adapté aux poids utilisés. DFlash2 a été entraîné sur les poids bf16 de Qwen ; nous servons une quantification NVFP4 communautaire, et le brouillon lit des états internes que la quantification perturbe. Une partie de la dispersion à flux unique vient probablement de là. Un brouillon entraîné sur la cible quantifiée reste l'expérience que nous n'avons pas faite, et c'est désormais le seul levier restant que nous connaissions.
Ce que nous avons appris et qui survivra aux chiffres
Deux choses, et aucune ne porte sur cette machine.
La première : un résultat de réglage peut porter une prémisse que vous n'avez pas écrite. « Sept, c'est trop profond » était un fait sur un réglage de brouillon déguisé en fait sur le matériel. Il a survécu une semaine parce que rien dans notre façon de le consigner ne rendait la prémisse visible, et le remède n'est pas de mesurer davantage mais de nommer les conditions dont un chiffre dépend au moment où on l'écrit.
La seconde : « sans perte » et « gratuit » sont deux mots différents. La vérification par bloc ne change rien à ce que le modèle produit et nous a tout de même coûté 11 % à huit flux, parce qu'une garantie de correction ne dit rien du coût de calcul de cette garantie. L'estimation que nous avons ratée la semaine dernière chiffrait un brouillon en divisant ses octets par la bande passante ; l'estimation que nous aurions ratée cette semaine chiffrait une règle d'acceptation en lisant sa démonstration.