OpenJev contre Kev-4B : benchmark sur plusieurs matériels CPU et GPU
OpenJev demande à un Qwen3.5-4B ordinaire de choisir la lettre d'une option, sans aucun entraînement pour la tâche. Sur les deux benchmarks qui nous ont fait choisir Kev-4B, il a reconnu le bon type de tâche sur 95,7 % de nos 328 requêtes, contre 88,7 % pour Kev-4B, mais il s'est trompé avec assurance bien plus souvent sur les requêtes publiques.
Kev-4B est le modèle de décision que CARouter sert à l'adresse /v1/decisions. Nous l'avons choisi sur 1 020 requêtes publiques, puis mesuré sur 328 requêtes rédigées à l'image du travail que nous envoient nos clients.
OpenJev prend un autre chemin : il n'entraîne rien. Il demande à un modèle de conversation ordinaire de choisir la lettre d'une option, puis lit la probabilité de chaque lettre. Nous l'avons passé sur les deux benchmarks, noté par le même script que Kev, pour savoir s'il aurait été le meilleur choix.
Lire le premier benchmark. Lire le deuxième, paru avec le lancement de Kev.
En bref
- Sur nos requêtes. Le Qwen3.5-4B d'OpenJev a reconnu le bon type de tâche sur 95,7 % de nos 328 requêtes, contre 88,7 % pour Kev-4B. Il obtient le même score en anglais et en français.
- Les points faibles de Kev. Il a reconnu la conversation courante 97 % du temps, et une étape isolée du travail d'un agent 88 % du temps. Kev-4B n'y voit juste qu'une fois sur trois et une fois sur deux.
- Sur les requêtes publiques. Il y arrive aussi en tête, à 79 % en anglais et 81 % en français, à égalité avec Jev, le service hébergé. Mais il s'y est trompé avec assurance sur 19 % des requêtes, contre 3 % pour Kev-4B.
- L'assurance sur nos requêtes. Il était sûr à 90 % ou plus de 294 réponses, et deux d'entre elles étaient fausses. Kev-4B l'était de 183 réponses, sans jamais se tromper.
- Le fichier du navigateur. Le fichier de 3 Go que télécharge openjev.com fait aussi bien que le modèle complet. Les deux petits modèles que propose le site sont loin derrière, et se trompent souvent avec assurance.
- Vitesse. Sur le GPU de ce portable, le fichier du navigateur rend une décision à trois questions en 267 millisecondes pour une requête courte. Sur le seul processeur d'un serveur, il lui faut de 9 à 12 secondes, plus qu'aux deux modèles Kev, alors que Kev-4B répond en 143 millisecondes sur le GPU qui le sert.
Ce qu'est OpenJev
OpenJev est un projet libre et indépendant, rebaptisé SemIf par son auteur, sans lien avec TypeSafe, l'entreprise derrière Jev. Son code est sous licence MIT, et openjev.com le fait tourner directement dans le navigateur. openjev.com · Code source.
Il place le texte et la question dans une invite, présente les options sous forme de lettres A, B, C, et demande au modèle de répondre par une seule lettre. Le modèle n'écrit jamais rien. OpenJev lit la probabilité que le modèle attribue à chaque lettre : ce sont les probabilités de la réponse.
Son meilleur modèle est Qwen3.5-4B. Kev-4B a été entraîné à partir de la version de base de ce même modèle. Ce test pose donc aussi une question simple : l'entraînement de Kev fait-il mieux que ce que Qwen sait déjà faire après son propre ajustement aux instructions ?
Comment nous avons testé
Nous avons posé à OpenJev exactement les questions posées à Kev. Sur les requêtes publiques, c'est une seule question, avec neuf types de tâche. Sur nos requêtes, ce sont trois questions : le type de tâche, sa difficulté, et si la réponse sera longue.
Un seul script a noté tous les modèles. Avant de noter quoi que ce soit de nouveau, il recalcule les chiffres des deux articles précédents à partir de leurs réponses brutes, et s'arrête si un seul diffère.
OpenJev a tourné avec son propre code, dans une version figée. Pour vérifier notre montage, nous avons d'abord passé ses 144 décisions de test. Nous avons obtenu la réponse publiée par ses auteurs sur les 144, et le même score de 0,813.
Chaque modèle d'OpenJev a tourné deux fois : en pleine précision, d'où viennent ses scores publiés, puis sous la forme du fichier allégé que le site télécharge vraiment. OpenJev prend une question à la fois avec une liste d'options. Une échelle de difficulté est donc devenue cinq options, et une question fermée, Oui et Non.
Nous avons aussi passé Kev-0.8B et les deux modèles Laya sur nos 328 requêtes, que seul Kev-4B avait vues. Jev et Kev-9B n'y figurent pas : Jev est un service hébergé payant que nous n'avons pas rappelé, et Kev-9B ne tient pas sur le portable que nous avons utilisé.
Ce que nous avons trouvé : la justesse
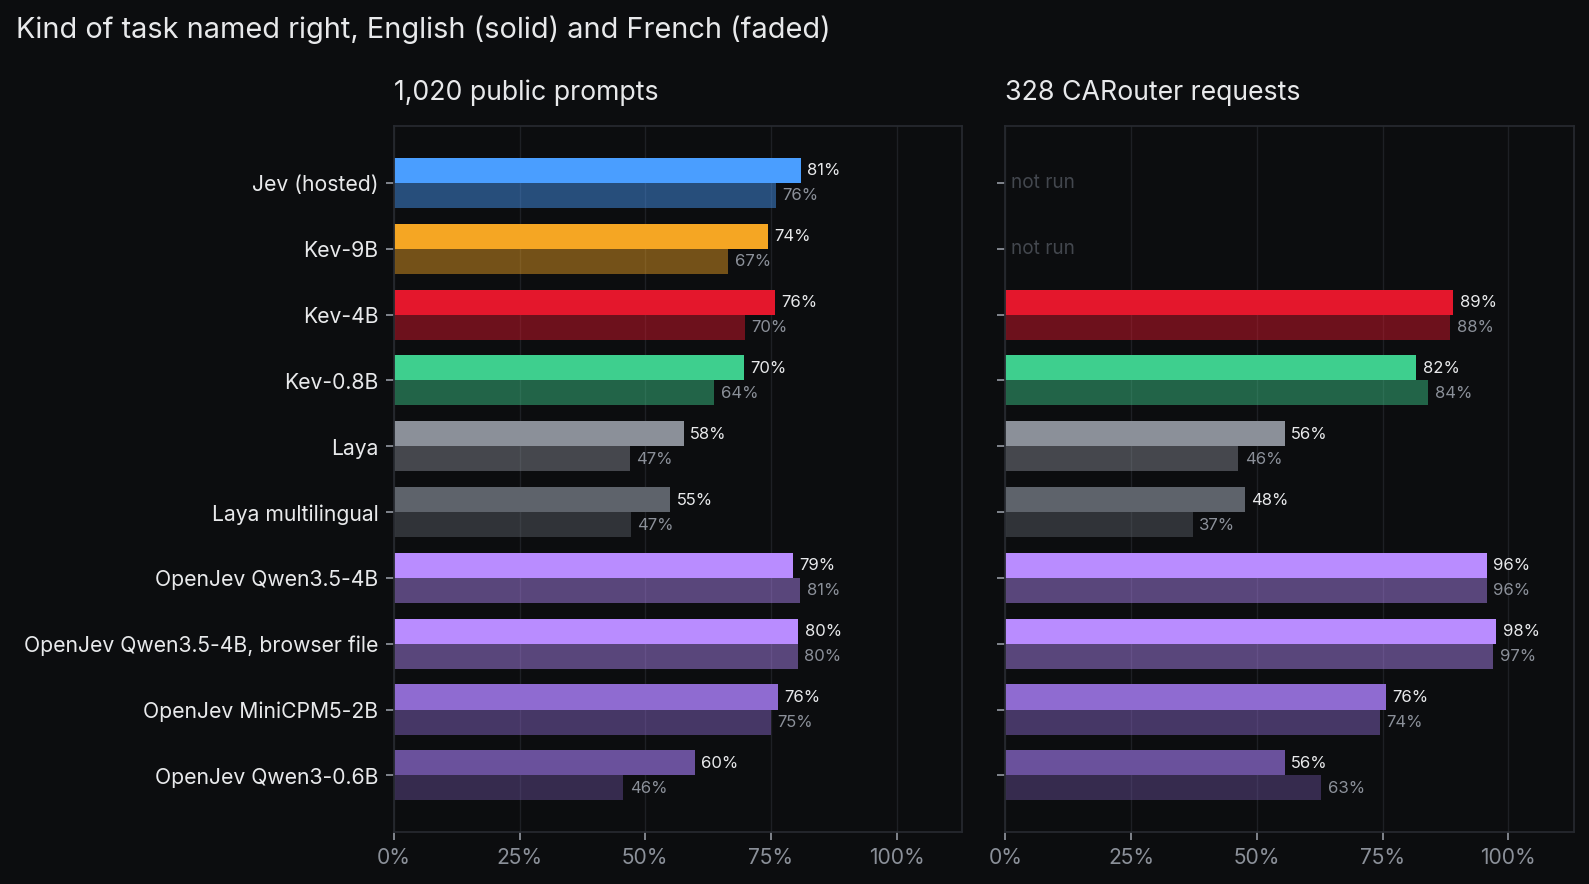
Sur nos requêtes, le Qwen3.5-4B d'OpenJev est le modèle le plus juste que nous ayons mesuré : 95,7 % en pleine précision et 97,3 % avec le fichier du navigateur, contre 88,7 % pour Kev-4B. L'anglais et le français obtiennent le même score.
Sur les requêtes publiques, il égale Jev et dépasse Kev-4B de quatre points en anglais et de onze en français. Dans le premier benchmark, le français coûtait de cinq à huit points à chaque modèle. À OpenJev, il n'a rien coûté.
| Modèle | Requêtes publiques, anglais | Requêtes publiques, français | Erreurs assurées, publiques, anglais | Nos 328 requêtes | Erreurs assurées, nos requêtes |
|---|---|---|---|---|---|
| Jevhébergé | 80,9 % | 76,0 % | 11,7 % | non testé | non testé |
| Kev-9B | 74,3 % | 66,5 % | 4,8 % | non testé | non testé |
| Kev-4B | 75,7 % | 69,8 % | 3,3 % | 88,7 % | 0,0 % |
| Kev-0.8B | 69,6 % | 63,7 % | 0,0 % | 82,9 % | 0,0 % |
| Laya | 57,6 % | 46,9 % | 0,0 % | 50,9 % | 0,0 % |
| Laya multilingual | 55,0 % | 47,1 % | 3,7 % | 42,4 % | 3,0 % |
| OpenJev Qwen3.5-4Bmodèle complet | 79,3 % | 80,8 % | 19,3 % | 95,7 % | 0,6 % |
| OpenJev Qwen3.5-4Bfichier du navigateur | 80,4 % | 80,3 % | 19,0 % | 97,3 % | 0,9 % |
| OpenJev Qwen3.5-4Bfichier du navigateur, formulation de la page | 79,3 % | 77,4 % | 20,5 % | 92,7 % | 1,8 % |
| OpenJev MiniCPM5-2Bmodèle complet | 76,3 % | 75,0 % | 20,2 % | 75,0 % | 13,7 % |
| OpenJev MiniCPM5-2Bfichier du navigateur | 73,0 % | 74,6 % | 13,0 % | 77,1 % | 9,1 % |
| OpenJev Qwen3-0.6Bmodèle complet | 59,8 % | 45,6 % | 35,6 % | 59,1 % | 23,5 % |
| OpenJev Qwen3-0.6Bfichier du navigateur | 59,6 % | 45,8 % | 34,1 % | 61,9 % | 19,5 % |
Les petits modèles du site changent la donne. MiniCPM5-2B, choisi par défaut sur un ordinateur, tient bon sur les requêtes publiques mais tombe à 75 % sur les nôtres. Qwen3-0.6B, proposé pour les téléphones, arrive derrière tous les modèles sauf Laya.
D'où vient l'écart
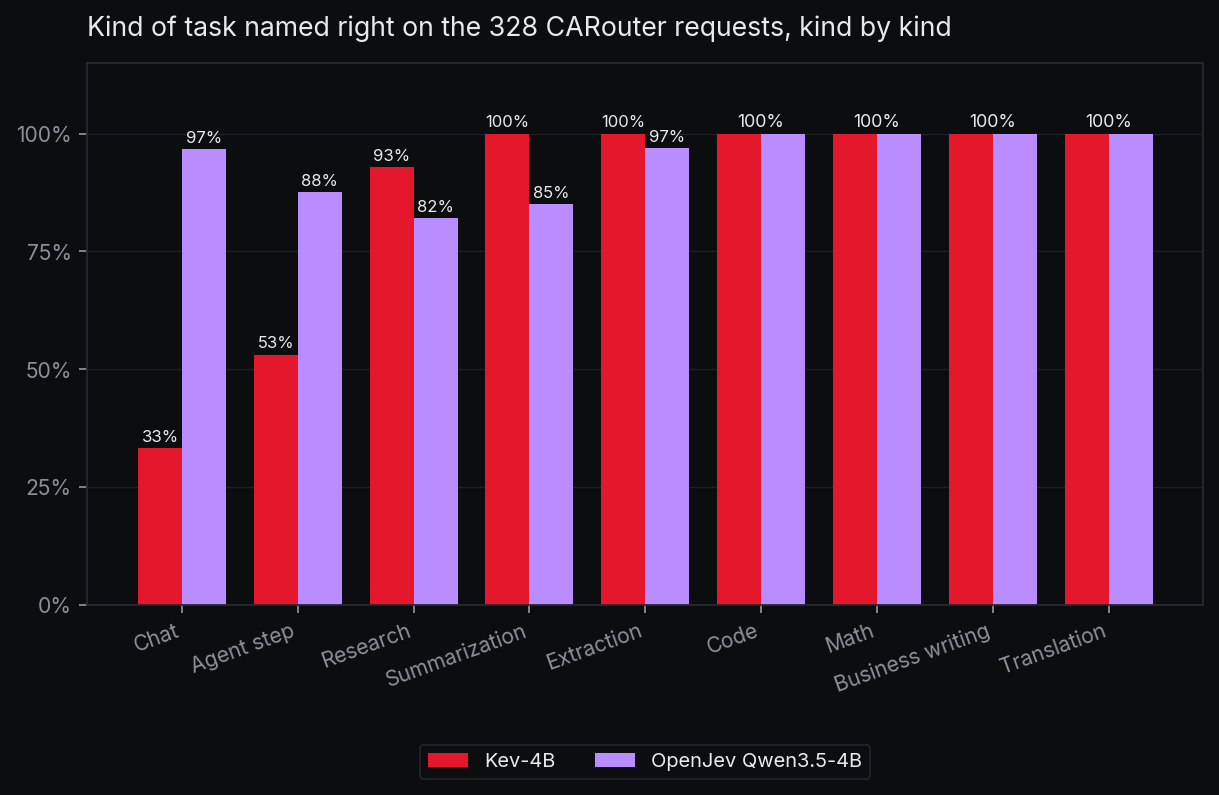
L'écart tient à deux types de requêtes. OpenJev a reconnu la conversation courante 97 % du temps, et les étapes isolées d'un agent 88 % du temps. Kev-4B, lui, prend une question de culture générale pour de la recherche, et la prochaine étape d'un agent pour du code.
Kev-4B s'en sort mieux avec les documents : 93 % contre 82 % en recherche, et 100 % contre 85 % pour les résumés. OpenJev a tendance à prendre une longue requête de recherche pour de la rédaction d'affaires. Les deux font un sans-faute sur le code, les mathématiques, la rédaction d'affaires et la traduction.
Ce que nous avons trouvé : l'assurance
Un modèle qui décide à la place de quelqu'un ne devrait agir que lorsqu'il est sûr de lui. Le premier article mesurait la part des réponses fausses données avec au moins 90 % d'assurance. Sur ce point, les deux benchmarks ne disent pas la même chose d'OpenJev.
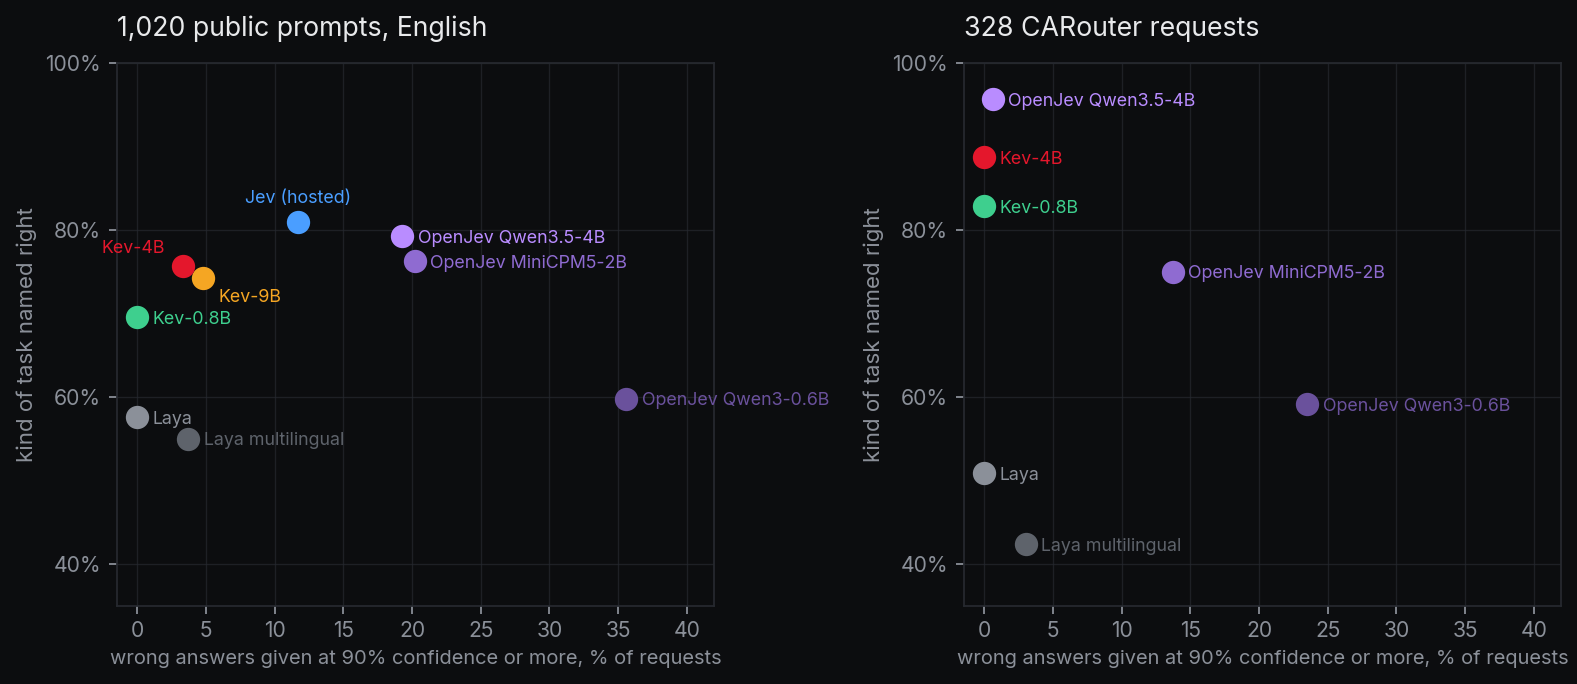
Sur nos requêtes, OpenJev était aussi sûr de lui pour 294 réponses sur 328, et s'est trompé deux fois, en prenant chaque fois une requête de recherche pour de la rédaction d'affaires. Kev-4B l'était pour 183 réponses, sans jamais se tromper. Avec un seuil à 90 %, OpenJev déciderait seul de neuf requêtes sur dix, et Kev-4B d'un peu plus de la moitié.
Sur les requêtes publiques, OpenJev s'est trompé avec assurance sur 19 % des requêtes en anglais, contre 3 % pour Kev-4B et 12 % pour Jev. Beaucoup de ces étiquettes se discutent.
Le jeu de données range « How many U.S. Presidents have served in the military? » parmi les remue-méninges. OpenJev y a vu une question factuelle, sûr à 99,8 %, et nous l'avons comptée fausse, comme pour tous les modèles.
Les étiquettes n'expliquent pas tout. Compté par famille de tâches, là où ces désaccords ne pèsent plus, OpenJev se trompe encore avec assurance sur 15 % des requêtes publiques. Son assurance a tenu sur des requêtes comme les nôtres ; ailleurs, elle reste à vérifier.
Le fichier du navigateur et les petits modèles
Le fichier de 3 Go que télécharge openjev.com est une copie de Qwen3.5-4B en 4 bits. Il obtient 97,3 % sur nos requêtes et 80 % sur les requêtes publiques dans les deux langues, aussi bien que le modèle complet.
Deux choses changent dans le navigateur. La page pose sa question dans ses propres mots, et avec eux, le même fichier obtient 92,7 % sur nos requêtes au lieu de 97,3 %, toujours devant Kev-4B. Elle ne donne aussi au modèle qu'une fenêtre de 2 048 tokens, où 14 de nos 328 requêtes ne tiennent pas.
Les deux petits modèles sont moins justes, et trop sûrs d'eux en plus. MiniCPM5-2B s'est trompé avec assurance sur 14 % de nos requêtes et Qwen3-0.6B sur 24 %, alors que Kev-4B et Kev-0.8B ne l'ont jamais fait.
Difficulté et réponses longues
Sur les deux autres questions, les deux modèles 4B se tiennent. OpenJev place une requête exactement à notre niveau de difficulté 36 % du temps, contre 41 % pour Kev-4B, et à un niveau près, 87 % contre 88 %.
Ni l'un ni l'autre ne prévoit bien une réponse longue. Seules 10 de nos 328 requêtes en demandent une : OpenJev en a repéré 4, et Kev-4B 3.
Vitesse et mémoire
OpenJev pose une question par passage sur le texte. Trois questions demandent donc trois passages, ou un passage sur le texte suivi de trois courts, le mode le plus rapide qu'offre son code. Kev lit le texte une seule fois et répond à toutes les questions à partir de ce passage.
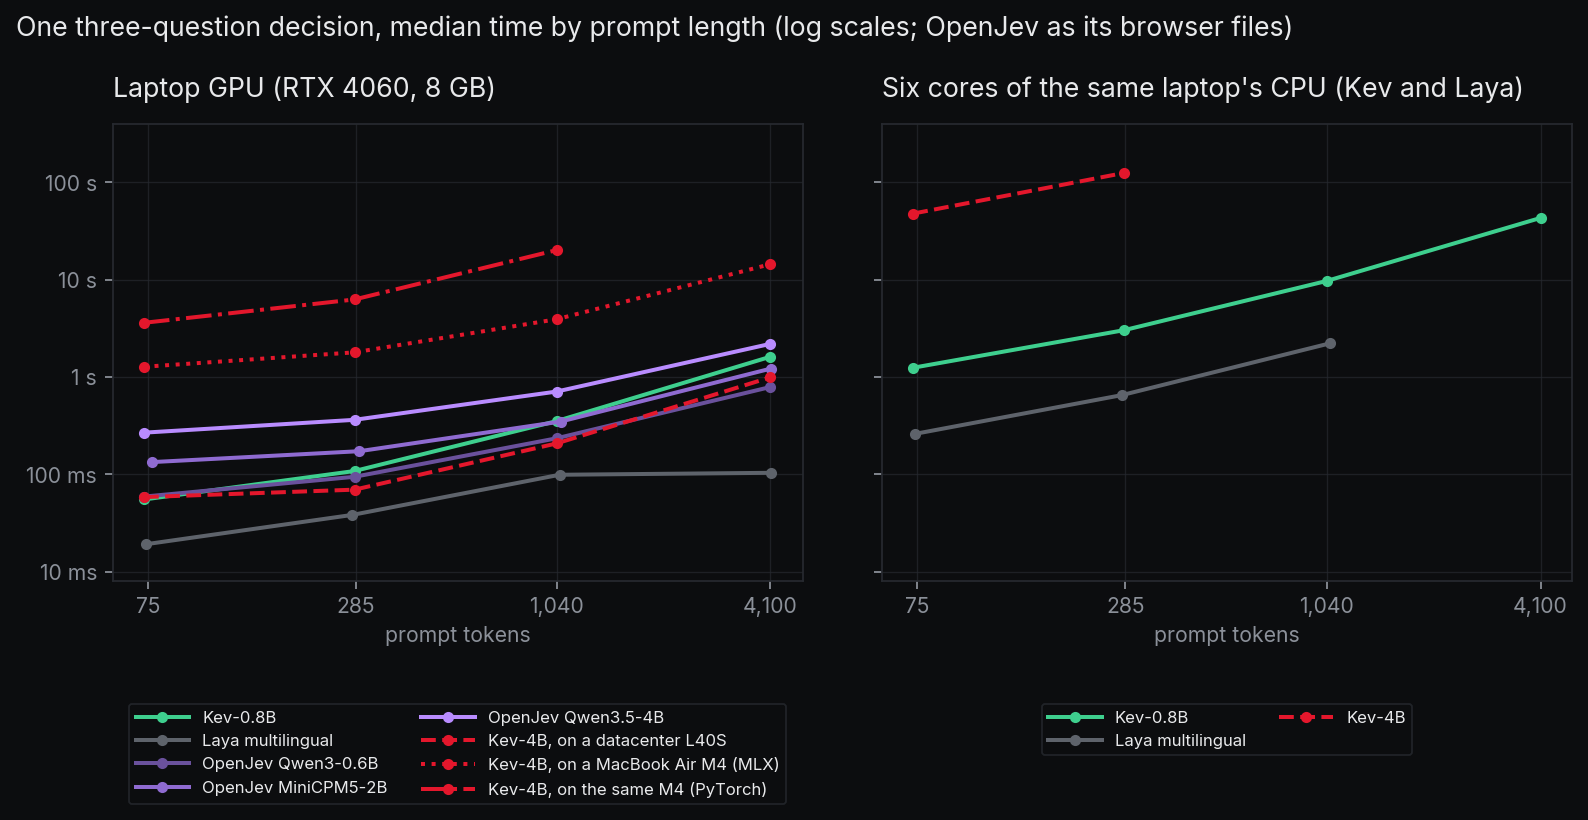
Sur le GPU de ce portable, le fichier du navigateur du Qwen3.5-4B d'OpenJev rend une décision à trois questions en 267 millisecondes pour une requête courte, et en 2,2 secondes pour une requête de 4 000 tokens. Kev-4B ne tient pas sur ce GPU : les deux modèles 4B n'ont donc jamais été chronométrés côte à côte. Sur le GPU de centre de données du premier benchmark, Kev-4B prenait 58 millisecondes et 1 seconde.
Kev-4B tient en revanche sur un MacBook Air équipé de la puce M4 d'Apple et de 24 Go de mémoire, que son GPU partage avec le processeur. Avec MLX, la bibliothèque d'apprentissage automatique d'Apple, que Kev prend en charge, la même décision y a pris 1,3 seconde pour une requête courte et 14 secondes pour une requête de 4 000 tokens.
Avec PyTorch, la bibliothèque qui fait tourner Kev sur notre propre serveur, il a fallu 3,6 secondes pour une requête courte et 20 secondes pour une requête de 1 000 tokens. Sur un Mac, PyTorch n'a pas de version rapide des couches récurrentes de Kev et relit le texte pour chaque question. À 4 000 tokens, il lui fallait plus de mémoire que n'en a le Mac. Sur six requêtes de contrôle, les deux ont donné les mêmes réponses que le GPU de centre de données.
Le Qwen3.5-4B complet demande 8,7 Go pour ses poids, plus que ce que contient le GPU de ce portable. Nous avons donc mesuré sa justesse en gardant une partie du modèle en mémoire système, sans le chronométrer.
Le fichier du navigateur occupe environ 3 Go sur le GPU, tout compris. Kev-4B montait jusqu'à 17 Go sur le GPU du premier benchmark, et tient sous 9 Go sur la machine qui le sert.
Sur le processeur seul
Nous avons chronométré la même décision à trois questions sur deux processeurs de serveur, sans aucun GPU à portée. Le premier est une machine virtuelle avec quatre cœurs AMD EPYC (Milan) et huit fils d'exécution. Le second, ce sont huit des dix cœurs Arm rapides de la machine GB10 qui sert Kev, à la priorité la plus basse, à côté des modèles qu'elle sert. Kev a tourné comme notre serveur le fait tourner : il lit le texte une fois, puis chaque question. OpenJev a utilisé le fichier de son navigateur, dans le plus rapide de ses deux modes. Les pointillés montrent Kev sur le GPU du GB10, pour les mêmes requêtes.
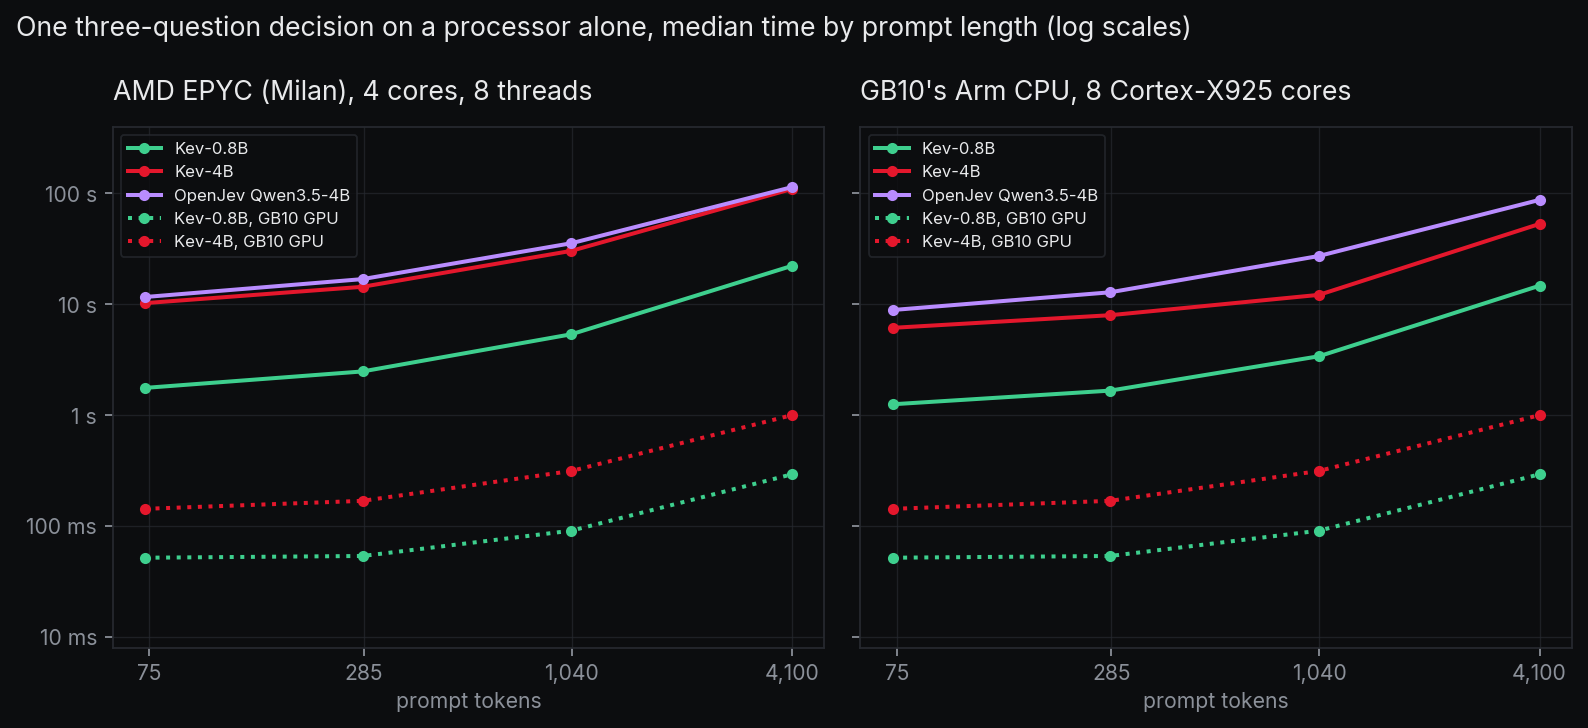
Sur un processeur, le fichier 4B d'OpenJev est le plus lent des trois. Sur les cœurs du GB10, il a pris 8,9 secondes pour une requête courte et 87 secondes pour une requête de 4 000 tokens, contre 6,1 et 53 secondes pour Kev-4B, et 1,3 et 15 secondes pour Kev-0.8B. Sur les cœurs EPYC, OpenJev et Kev-4B se tenaient, à 12 et 10 secondes pour une requête courte, et Kev-0.8B prenait 1,8 seconde.
Rien de tout cela ne convient quand quelqu'un attend la réponse. Sur le GPU de la même machine, Kev-0.8B répond en 52 à 293 millisecondes et Kev-4B en 143 millisecondes à 1 seconde : environ 25 à 50 fois plus vite que le même modèle sur son processeur le plus rapide.
Deux détails comptent sur un processeur. L'EPYC n'a pas d'arithmétique rapide pour les nombres sur 16 bits dans lesquels Kev est stocké : Kev-0.8B y a tourné de sept à huit fois plus lentement que sur 32 bits. Les cœurs Arm du GB10 ont cette arithmétique, et les deux formats y ont tourné à peu près à la même vitesse. Par ailleurs, les huit fils d'exécution de la machine EPYC ne représentent que quatre cœurs : avec quatre fils, Kev n'était qu'environ 20 % plus lent.
Sur le GB10, passer un modèle sur le processeur ne libérerait pas non plus de mémoire : processeur et GPU puisent dans la même réserve, et un modèle y occupe la même place d'un côté comme de l'autre. Kev-4B lit en outre ses poids en nombres sur 32 bits, environ 16 Go, pour y intégrer exactement son adaptateur. Cela ne tient pas à côté des modèles que sert la machine : sur son processeur, nous avons donc chronométré Kev-4B sur 16 bits, avec l'adaptateur à part.
Ce que cela ne prouve pas
- Chaque modèle n'a tourné qu'une fois, sur deux ensembles de requêtes. Pour un type qui compte 20 requêtes, une seule erreur déplace le chiffre de cinq points.
- Nous avons rédigé et étiqueté nous-mêmes les 328 requêtes. Sur les 144 décisions de test d'OpenJev, la fiche du modèle Kev rapporte l'inverse : 0,896 pour Kev-4B contre 0,813 pour le Qwen3.5-4B d'OpenJev. Le gagnant dépend donc des requêtes.
- Le fichier du navigateur a tourné avec llama.cpp sur le GPU du portable, pas dans un navigateur. Sa justesse reste la même, mais pas sa vitesse : les auteurs d'OpenJev ont mesuré 3,3 secondes pour une décision dans Chrome, sur une RTX 3090.
- Les temps sur portable viennent de deux portables, et ceux des processeurs d'une seule machine EPYC et d'un seul GB10, mesurés une fois chacun avec cinq requêtes par longueur. Les cœurs du GB10 servaient en même temps ses autres modèles.
Ce que cela change pour CARouter
Nous avons choisi Kev-4B parce qu'il était le modèle ouvert le plus juste sur les requêtes publiques, et le plus franc sur ses doutes. Sur des requêtes comme celles de nos clients, un Qwen3.5-4B sans entraînement les comprend mieux, y compris les deux types que Kev-4B rate le plus.
Pour l'instant, Kev-4B reste derrière /v1/decisions, sur le GPU : aucun de ces modèles n'a sa place sur un processeur quand quelqu'un attend la réponse. Avant tout changement, nous mesurerons ce Qwen3.5-4B sur le GPU qui sert Kev, à la vitesse que verrait un client, et nous passerons le test de sélection complet dont a besoin le choix automatique du modèle. Toutes les mesures derrière cet article sont conservées, et nous les partagerons avec quiconque le demande.