Banc d'essai du modèle Sparset Thinklite-27B : vitesse et qualité
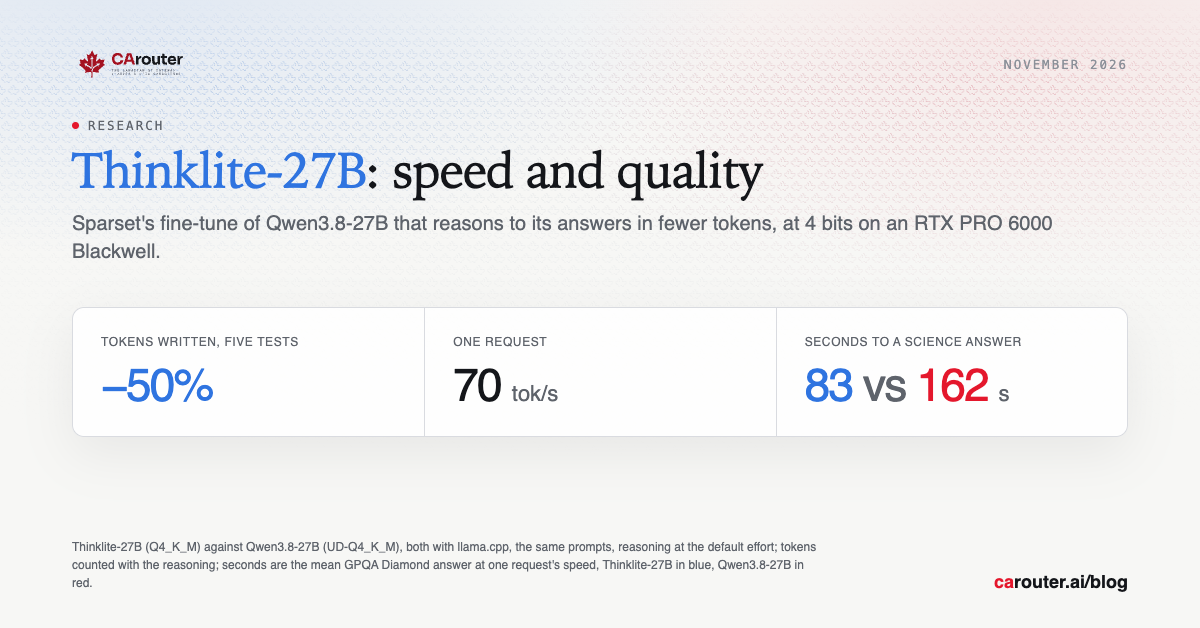
Thinklite-27B, de Sparset, est Qwen3.8-27B entraîné à raisonner en moins de tokens. À 4 bits sur une RTX PRO 6000 Blackwell, il a écrit deux fois moins de tokens que Qwen3.8-27B sur nos cinq tests, à la même vitesse par token : une réponse scientifique a pris 83 secondes au lieu de 162. Il fait aussi bien en programmation, en appels d'outils et sur les longs documents, et suit un peu moins bien les consignes, 91 % contre 94 %.
Sparset a publié Thinklite-27B le 4 novembre. C'est Qwen3.8-27B, entraîné sur ses propres réponses justes pour y arriver par un chemin plus court : le raisonnement raccourcit, et la réponse garde sa longueur et sa forme.
Sparset publie une seule version, à 4 bits, pour llama.cpp. Nous l'avons opposée à une version à 4 bits de Qwen3.8-27B de même taille, sur le même moteur et une RTX PRO 6000 Blackwell, une carte de station de travail dotée de 96 Go, pour mesurer sa vitesse et lui faire passer nos cinq tests de qualité.
En bref
- Tokens. Sur les cinq tests, Thinklite a écrit 2.17 millions de tokens et Qwen3.8-27B 4.33 millions, raisonnement compris : deux fois moins.
- Vitesse. Token pour token, les deux vont au même pas : 70 tokens par seconde pour une requête, contre 73.5. Comme il écrit deux fois moins de tokens, Thinklite termine une réponse scientifique en 83 secondes en moyenne, contre 162.
- Qualité. Thinklite programme, appelle des outils et retrouve une information dans un long document aussi bien que Qwen. Il suit un peu moins bien les consignes, 91 % contre 94 %, et répond juste à plus de questions scientifiques dans notre limite de tokens, 87 % contre 81 %.
- Mémoire. Les poids à 4 bits occupent 15.4 Gio : une seule carte contient le modèle, avec beaucoup de place pour de longs contextes.
Deux fois moins de tokens
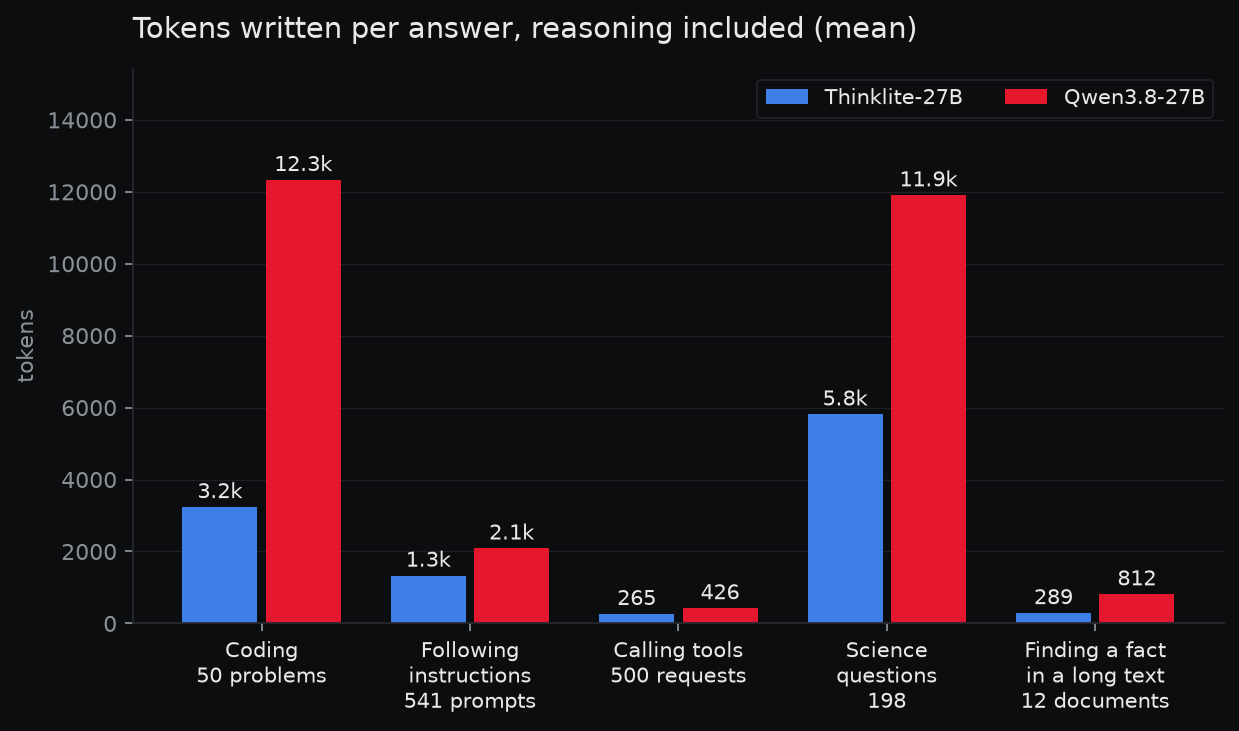
Un modèle qui raisonne écrit sa réflexion avant sa réponse, et sur une question difficile, la réflexion fait l'essentiel du texte. Thinklite la raccourcit sur chacun de nos tests : 74 % de tokens en moins sur les problèmes de programmation, 36 % sur les consignes, 38 % sur les appels d'outils, 51 % sur les questions scientifiques et 64 % sur le test du long texte.
La coupe est la plus nette là où Qwen réfléchit le plus longtemps. Sur les questions que les deux modèles ont réussies, Thinklite a utilisé 38 % des tokens de Qwen en sciences et 25 % en programmation.
Sparset annonce 48 % de tokens de raisonnement en moins sur ses six propres tests. Nous comptons tout ce qu'écrit un modèle, réponses comprises, et avons mesuré 50 % de moins sur les nôtres.
La même vitesse par token
Thinklite garde l'architecture et la taille de Qwen3.8-27B : sur le même moteur, il écrit donc au même rythme, 70 tokens par seconde pour une requête contre 73.5, et 574 contre 605 au total pour seize requêtes simultanées. L'écart de 5 % vient très probablement de la façon dont chaque fichier a été quantifié.
Un modèle dense lit tous ses poids en mémoire pour chaque token qu'il écrit. Un fichier de 16.5 Go sur une carte qui déplace 1.8 To par seconde plafonne vers 108 tokens par seconde pour une requête, et les deux modèles en atteignent environ les deux tiers.
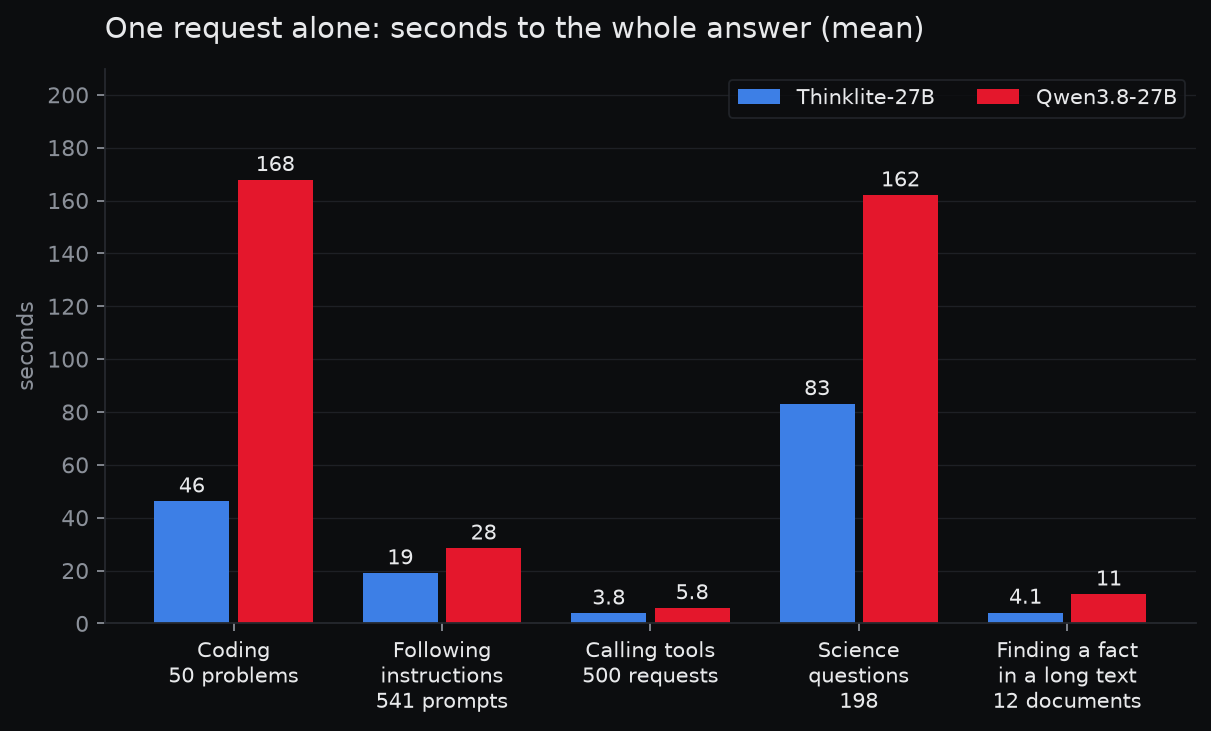
Le temps jusqu'à la réponse complète suit donc le nombre de tokens. Une requête attend 83 secondes une réponse scientifique de Thinklite et 162 de Qwen, et 46 secondes une réponse de programmation contre 168.
C'est aussi vrai avec beaucoup de requêtes à la fois. Douze à la fois sur le même modèle de carte, Thinklite a traité les 198 questions scientifiques en 89 minutes, et Qwen en 3 heures 36 minutes.
Les deux lisent un prompt de 11 810 tokens à une vitesse comprise entre 3 800 et 3 900 tokens par seconde : le premier token arrive donc après environ 3 secondes.
Qualité
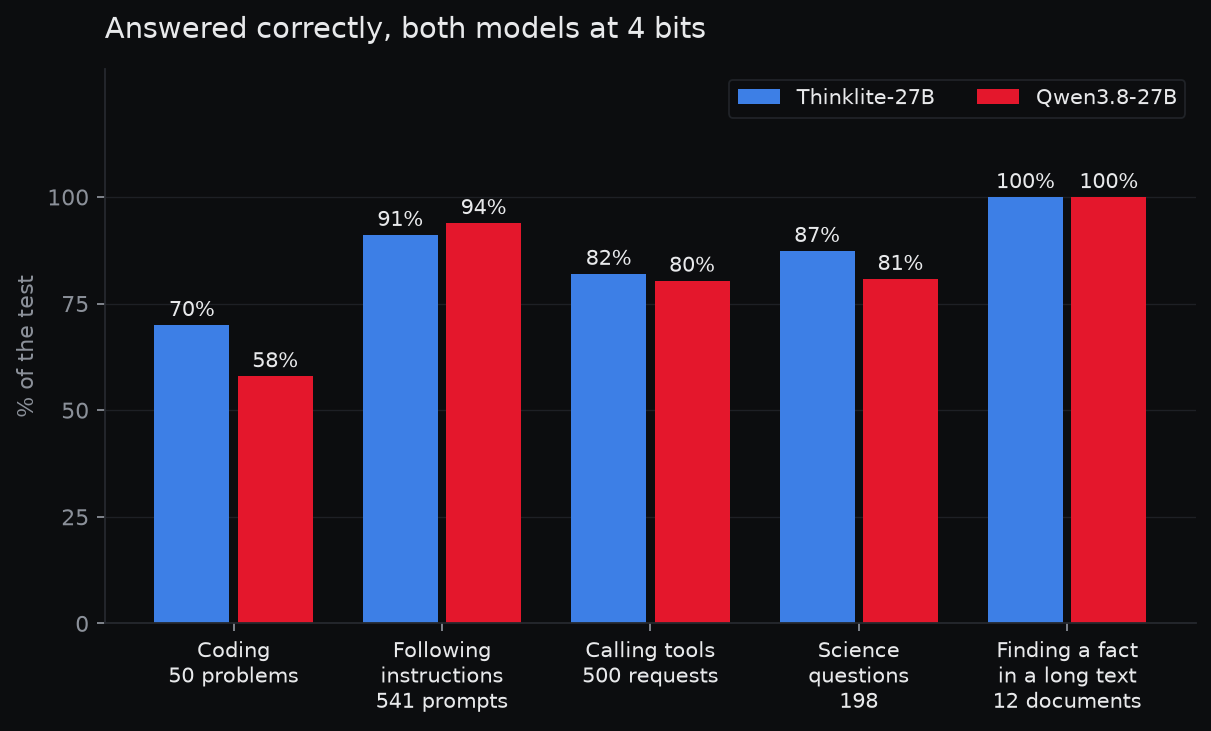
Nous avons fait passer nos cinq tests aux deux modèles avec les mêmes prompts, et chaque réponse pouvait utiliser jusqu'à 32 768 tokens, 8 192 pour le test du long texte.
Les questions scientifiques montrent ce que rapporte un chemin plus court quand la longueur est limitée. Sur GPQA Diamond, Thinklite a répondu juste à 173 questions sur 198, et Qwen à 160. Le raisonnement de Qwen a atteint notre limite sur 29 questions, contre 9 pour Thinklite, et une réponse coupée compte comme fausse. Sur les 169 questions où aucun des deux n'a manqué de place, ils obtiennent 158 et 160 : égalité.
C'est sur les consignes que l'entraînement a coûté quelque chose. Sur les 541 prompts d'IFEval, Thinklite a suivi toutes les consignes de 493 d'entre eux et Qwen de 508, un écart trop large pour le hasard.
La programmation penche du côté de Thinklite : il a résolu 35 des 50 problèmes de BigCodeBench, et Qwen 29, même si, sur 50 problèmes, le hasard pourrait encore produire un écart de cette taille.
Les appels d'outils sont à égalité, 410 sur 500 contre 402, et les deux ont retrouvé une phrase cachée dans des documents de 16 000 à 100 000 tokens 12 fois sur 12.
Notre méthode
Thinklite tournait depuis le fichier GGUF de Sparset, une version à 4 bits avec matrice d'importance, de 16.55 Go. Qwen3.8-27B tournait depuis la version UD-Q4_K_M d'unsloth, de 16.46 Go, la plus proche en taille.
Notre outil de bancs d'essai sert les modèles avec vLLM et ne prend pas les fichiers GGUF : nous avons donc lancé les mêmes tests à la main sur des RTX PRO 6000 Blackwell louées, avec llama.cpp v0.9.0 compilé pour elles. La vitesse vient d'une seule carte, chaque modèle seul. Les tests de qualité ont tourné sur deux cartes, et un score ne dépend pas de la carte.
Les deux modèles raisonnaient à leur effort par défaut, le plus élevé, avec l'échantillonnage que Sparset a utilisé pour les deux dans sa propre comparaison : température 1.0, top-p 0.95 et top-k 20.
La sonde de vitesse maintient de 1 à 16 requêtes en cours pendant 40 secondes, après 20 secondes de mise en route, et compte chaque token écrit dans cet intervalle. Le chiffre pour une requête est la moyenne de trois passages.
Les chiffres figurent aussi sur notre page Benchmarks, à côté de tous les autres modèles que nous avons mesurés. Voir les benchmarks.
Ce qui reste à mesurer
- Les efforts plus faibles. Les deux modèles acceptent un effort de raisonnement plus faible, qui raccourcit lui aussi la réflexion, et nous les avons testés tous deux au plus élevé.
- Une limite plus large. Avec plus de 32 768 tokens par réponse, Qwen terminerait davantage de ses réponses scientifiques.
- Les autres versions. Sparset publie aussi le modèle en pleine précision, que vLLM peut servir, et nous avons mesuré le fichier à 4 bits sur llama.cpp.
- Le travail par agents. Nos tests portent sur des requêtes isolées, et une longue session d'agent cumulerait à la fois l'économie et l'écart sur les consignes.