Clef et Strands Decider contre Kev-4B : benchmark sur un GB10
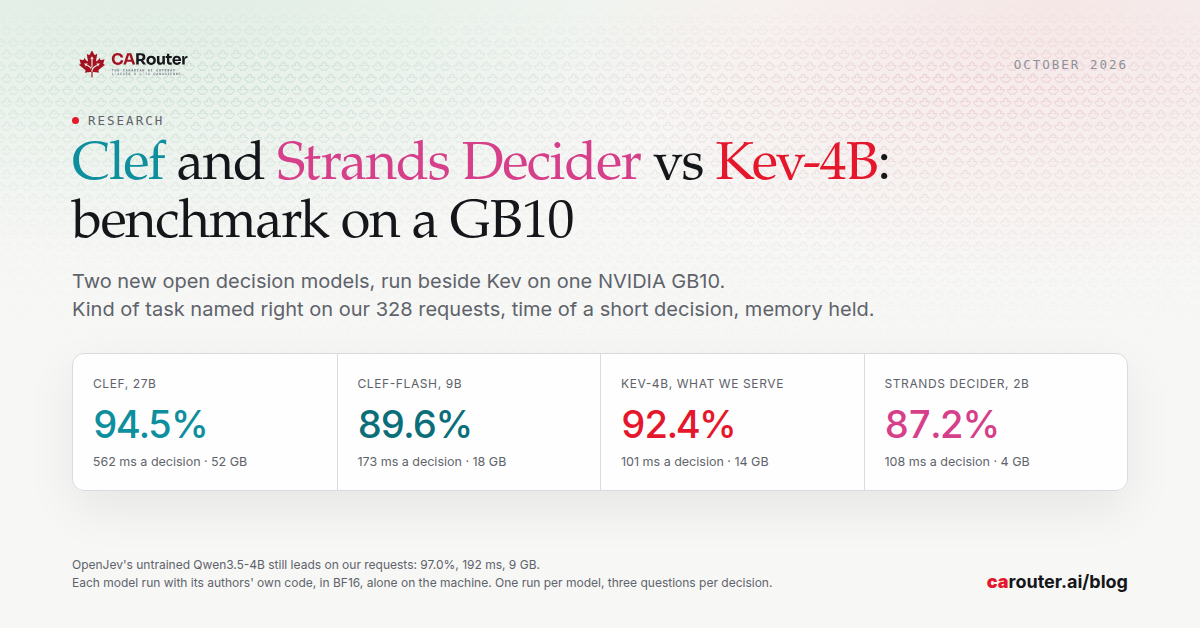
Clef, de Cloudflare, et Strands Decider, de Strands Labs, sont deux nouveaux modèles de décision ouverts. Sur un GB10, Clef a reconnu le bon type de tâche sur 94,5 % de nos 328 requêtes, contre 92,4 % pour Kev-4B, pour cinq fois plus de temps et près de quatre fois plus de mémoire. Le Qwen3.5-4B d'OpenJev, sans entraînement, reste en tête à 97,0 %.
Deux nouveaux modèles de décision ouverts viennent de sortir. Cloudflare a publié Clef et son petit frère Clef-flash, et Strands Labs a publié Strands Decider. Comme Jev et Kev, tous trois répondent à des questions typées sur un texte.
Nous les avons passés sur nos deux benchmarks à côté de Kev, sur un GB10 de NVIDIA, la machine qui sert Kev-4B à l'adresse /v1/decisions. Nous avons mesuré la justesse de chacun, la fréquence de ses erreurs commises avec assurance, le temps d'une décision et la mémoire qu'il occupe.
Lire le premier benchmark. Lire le deuxième, paru avec le lancement de Kev. Lire le troisième, sur OpenJev.
En bref
- Sur nos requêtes. Clef a reconnu le bon type de tâche sur 94,5 % de nos 328 requêtes, contre 92,4 % pour Kev-4B, 89,6 % pour Clef-flash et 87,2 % pour Strands Decider.
- Là où Clef prend l'avantage. L'écart est de sept requêtes, et il vient des étapes d'agent : Clef en a reconnu 28 sur 32, Kev-4B 16. Or CARouter reconnaît une étape d'agent à la requête elle-même. Notés de cette façon, Kev-4B est à 97,3 % et Clef à 95,7 %.
- Sur les requêtes publiques. Les trois nouveaux venus atteignent de 80 à 82 % en anglais, à égalité avec Jev, le service hébergé, et devant Kev-4B, à 76 %. En français, Clef-flash arrive en tête à 78 % et Strands Decider tombe à 68 %.
- L'assurance. Sur les requêtes publiques, Clef et Clef-flash se sont trompés en étant sûrs d'eux à 90 % ou plus sur 8 % et 9 % des requêtes, contre 12 % pour Jev, 3 % pour Kev-4B et 0,2 % pour Strands Decider.
- Vitesse. Pour une requête courte, une décision à trois questions prend 101 millisecondes avec Kev-4B, 108 avec Strands Decider, 173 avec Clef-flash et 562 avec Clef.
- Mémoire. Clef occupe 52 des 121 Go du GB10, Clef-flash 18, Kev-4B 14 et Strands Decider 4.
- Le modèle que personne n'a entraîné. Le Qwen3.5-4B d'OpenJev, repassé sur la même machine, reste en tête sur nos requêtes : 97,0 %, en 192 millisecondes et 9 Go.
Qui sont les nouveaux venus
Clef est la famille de modèles de décision de Cloudflare, publiée sous licence Apache 2.0, avec ses poids sur Hugging Face. Clef repose sur Qwen3.8-27B, et Clef-flash sur Qwen3.5-9B. L'annonce de Cloudflare. Les poids de Clef.
Cloudflare a ajouté une petite tête au-dessus de chaque modèle de conversation. Elle lit la dernière couche du modèle et note en un seul passage chaque option de chaque question. Clef accepte la même requête que Jev. Il sait aussi lire des images et de la vidéo, ce que nous n'avons pas testé.
Strands Decider vient de Strands Labs, le volet expérimental du projet Strands Agents, lui aussi sous licence Apache 2.0. Il compte 1,9 milliard de paramètres : un adaptateur et une petite tête posés sur Qwen3.5-2B-Base. Kev est construit de la même façon, et cette base se situe entre celles de Kev-0.8B et de Kev-4B. Code source.
Les trois ne lisent pas la même longueur de texte. La fenêtre de Strands Decider est de 4 096 tokens, celle de Kev de 8 192 tel que nous le servons, et celle de Clef de 16 384 tel qu'il est publié. Clef et Strands Decider coupent un texte trop long et n'en gardent que le début ; notre moteur Kev, lui, refuse la requête. Aucune de nos requêtes de test n'a atteint ces limites.
Comment nous avons testé
La machine de test est un GB10, le même modèle que celle qui sert Kev, avec 121 Go de mémoire que se partagent le processeur et le GPU. Chaque modèle y a tourné seul, une requête à la fois, avec le code de ses auteurs. Kev a tourné comme notre serveur le fait tourner.
Les deux benchmarks sont ceux des articles précédents. Sur les 1 020 requêtes publiques, chaque modèle répond à une seule question, avec neuf types de tâche. Sur nos 328 requêtes, il répond à trois questions : le type de tâche, sa difficulté, et si la réponse sera longue.
Un seul script a noté tous les modèles : celui de l'article précédent. Avant de noter quoi que ce soit de nouveau, il recalcule les chiffres publiés dans les articles précédents, et s'arrête si un seul diffère.
Nous avons vérifié notre montage de trois façons. Sur l'exemple de sa propre fiche, Strands Decider a donné les réponses qui y sont publiées, à 0,004 près. OpenJev a donné la réponse publiée par ses auteurs sur ses 144 décisions de test. Enfin, sur la machine de test, Kev-4B a choisi la même réponse qu'en production pour 1 015 des 1 020 requêtes publiques et pour 327 de nos 328 requêtes.
Cloudflare ne publie pas les réponses de Clef une à une : nous n'avons donc pas pu le vérifier de la même façon. Il s'est chargé comme le décrit sa fiche, et ses réponses aux exemples de cette fiche sont sensées.
Jev est un service hébergé payant, que nous n'avons pas rappelé. Ses chiffres sur les requêtes publiques sont ceux du premier benchmark, et il n'a jamais été passé sur nos requêtes.
Une chose a changé depuis l'article sur OpenJev. Nous avons reformulé deux options de la question sur le type de tâche, la conversation et la recherche. Une étape d'agent montre aussi désormais la tâche demandée par l'utilisateur, à côté du résultat de l'outil. Tous les modèles ont répondu ici à cette nouvelle formulation.
Les chiffres de cet article sur nos requêtes répondaient à l'ancienne formulation, et ne se comparent pas à ceux-ci. Avec la nouvelle, Kev-4B est passé de 88,7 % à 92,4 %, et le Qwen3.5-4B d'OpenJev de 95,7 % à 97,0 %.
Ce que nous avons trouvé : la justesse
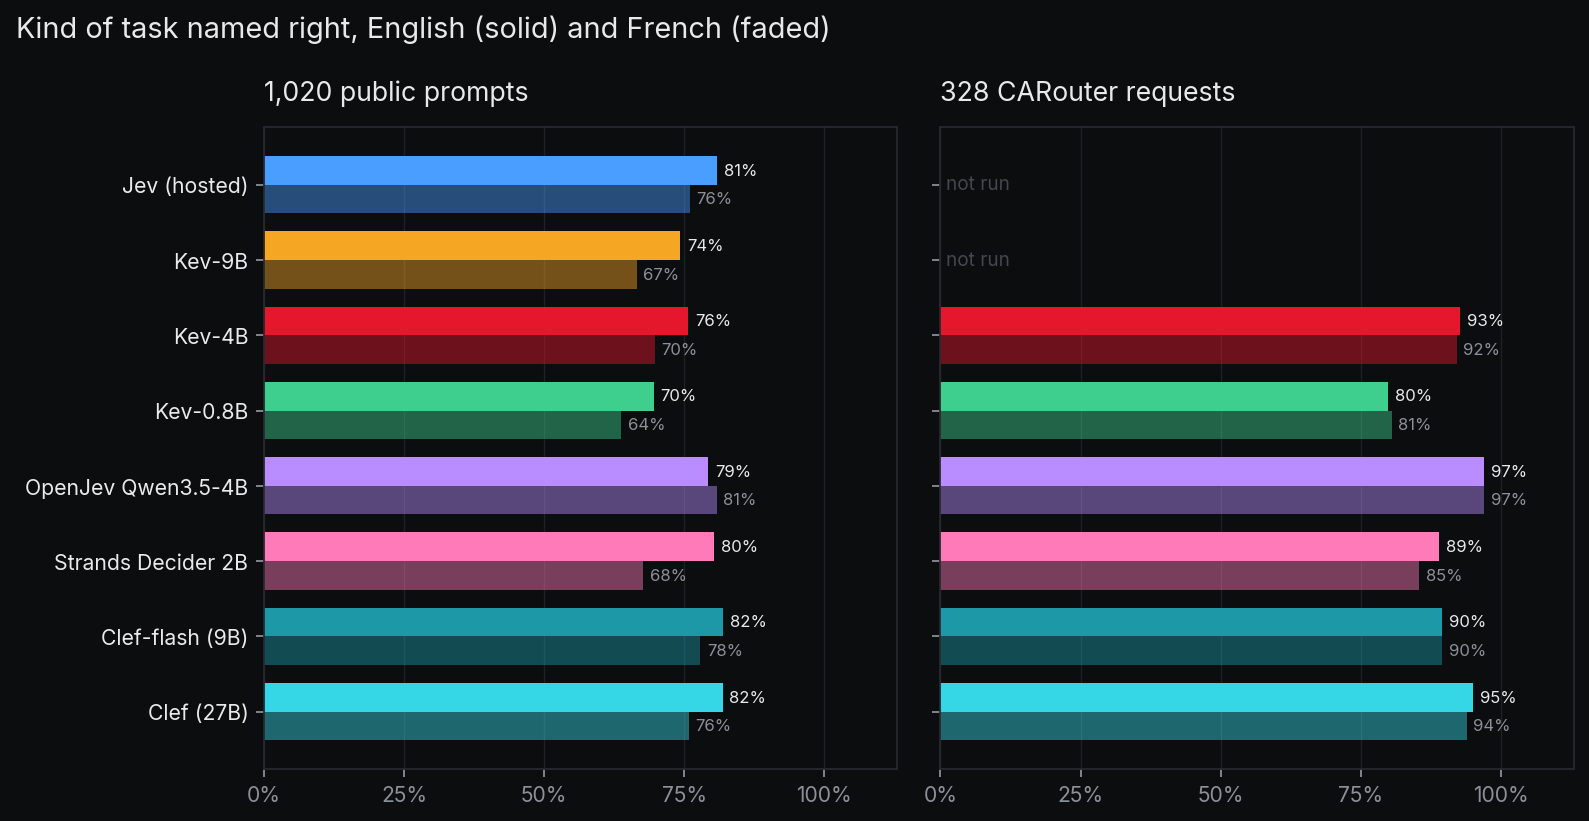
Sur nos requêtes, Clef est le plus juste des modèles entraînés : 310 bonnes réponses sur 328, contre 303 pour Kev-4B. Clef-flash en obtient 294, et Strands Decider 286.
Sur les requêtes publiques, l'ordre change. Clef-flash, Clef et Strands Decider atteignent 82 %, 82 % et 80 % en anglais, autour des 81 % de Jev, le service hébergé. Kev-4B reste à 76 %.
Le français les départage. Clef-flash garde 78 % et Clef 76 %, comme Jev. Strands Decider recule à 68 %, sous les 70 % de Kev-4B. Sur nos requêtes, il perd moins : 89 % en anglais et 85 % en français.
| Modèle | Requêtes publiques, anglais | Requêtes publiques, français | Erreurs assurées, publiques, anglais | Nos 328 requêtes | Décision courte | Mémoire |
|---|---|---|---|---|---|---|
| Jev (hosted) | 80,9 % | 76,0 % | 11,7 % | non testé | non testé | non testé |
| Kev-9B | 74,3 % | 66,5 % | 4,8 % | non testé | non testé | non testé |
| Kev-4B | 75,7 % | 69,8 % | 3,3 % | 92,4 % | 101 ms | 14 Go |
| Kev-0.8B | 69,6 % | 63,7 % | 0,0 % | 80,2 % | 23 ms | 4 Go |
| OpenJev Qwen3.5-4B | 79,3 % | 80,8 % | 19,3 % | 97,0 % | 192 ms | 9 Go |
| Strands Decider 2B | 80,4 % | 67,7 % | 0,2 % | 87,2 % | 108 ms | 4 Go |
| Clef-flash (9B) | 82,0 % | 77,9 % | 8,9 % | 89,6 % | 173 ms | 18 Go |
| Clef (27B) | 81,9 % | 75,8 % | 8,1 % | 94,5 % | 562 ms | 52 Go |
Nous avons rédigé les questions posées sur nos requêtes avec les réponses de Kev-4B sous les yeux, sur les trois cinquièmes des requêtes. Sur les 137 requêtes mises de côté, l'ordre reste le même : OpenJev 98,5 %, Clef 95,6 %, Kev-4B 93,4 %, Clef-flash 91,2 % et Strands Decider 88,3 %.
D'où viennent les écarts
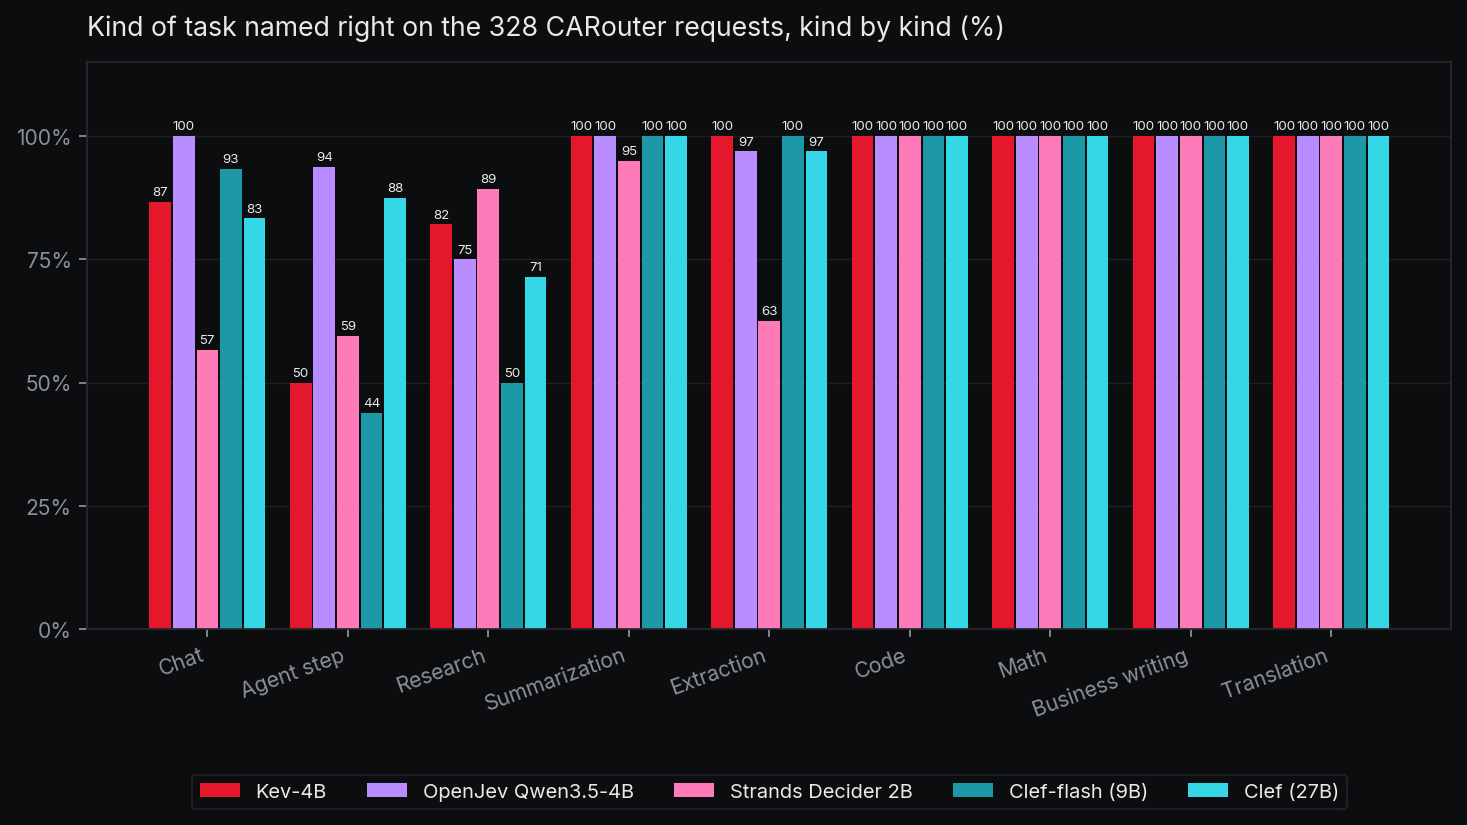
Tous les modèles font un sans-faute sur le code, les mathématiques, la rédaction d'affaires et la traduction. Les écarts tiennent à trois types de requêtes : les étapes d'agent, la conversation courante et la recherche.
C'est sur les étapes d'agent que Clef prend l'avantage. Il en a reconnu 28 sur 32, quand Strands Decider en reconnaît 19, Kev-4B 16 et Clef-flash 14. Le dernier message d'une étape d'agent est le résultat d'un outil, qui ressemble à du code ou à une page web.
C'est aussi le seul type que CARouter ne demande pas à un modèle. Une requête qui contient des définitions d'outils est une étape d'agent, et notre plateforme le voit comme elle voit la langue. Notés de cette façon, Kev-4B reconnaît 97,3 % des requêtes, Clef 95,7 %, Clef-flash 95,1 % et Strands Decider 91,2 %.
En recherche, Strands Decider et Kev-4B font mieux que les deux modèles Clef : 89 % et 82 %, contre 71 % pour Clef et 50 % pour Clef-flash, qui range une requête de recherche dans l'extraction ou le résumé. Les points faibles de Strands Decider sont la conversation, à 57 %, et l'extraction, à 63 %.
Ce que nous avons trouvé : l'assurance
Un modèle qui décide à la place de quelqu'un ne devrait agir que lorsqu'il est sûr de lui. Nous comptons donc les réponses fausses que chacun donne avec au moins 90 % d'assurance.
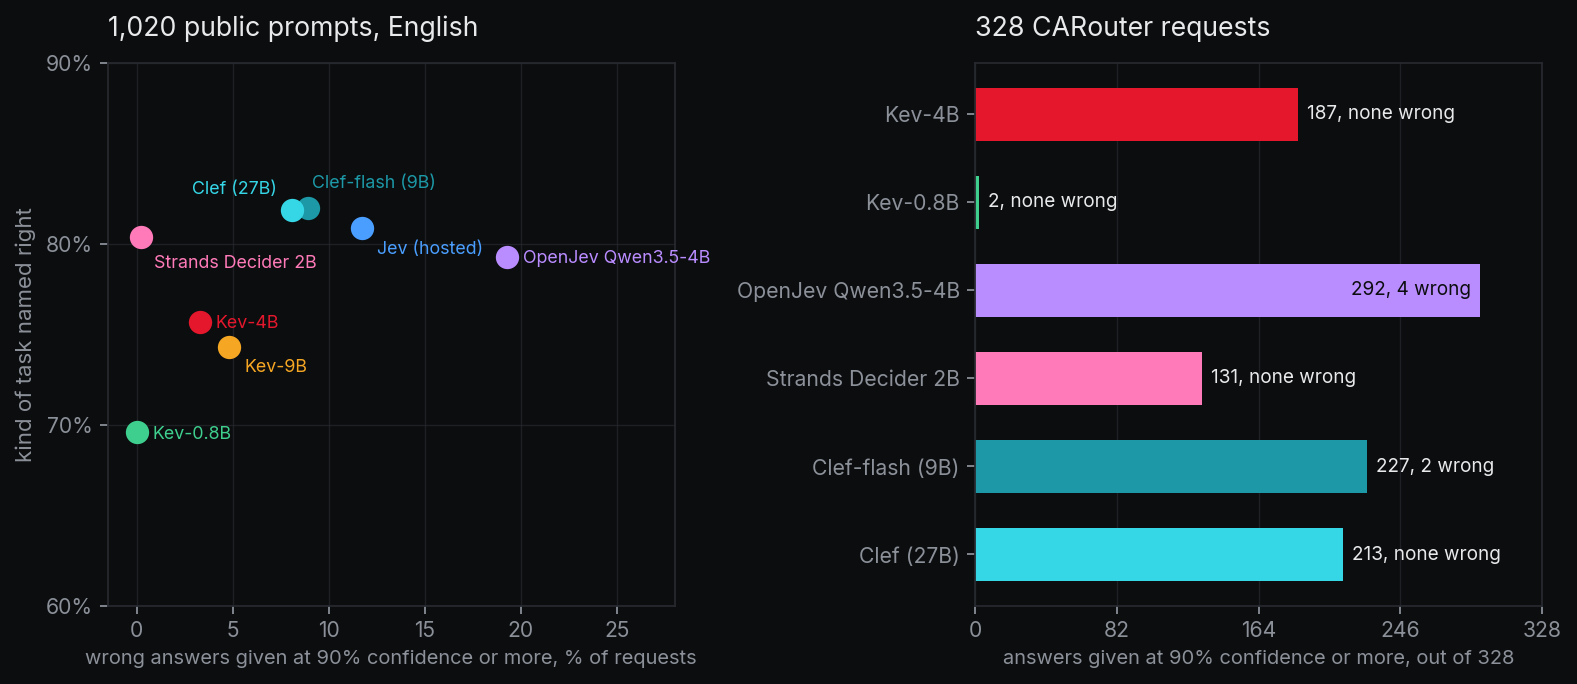
Sur les requêtes publiques, Clef et Clef-flash se trompent avec assurance sur 8 % et 9 % des requêtes en anglais. C'est mieux que Jev, à 12 %, et moins bien que Kev-4B, à 3 %. Strands Decider ne s'est trompé avec assurance qu'une fois sur 540 requêtes.
Sur nos requêtes, presque aucun modèle ne se trompe quand il est sûr de lui. Ce qui les distingue, c'est le nombre de fois où ils le sont. Clef-flash a donné 227 réponses à ce niveau d'assurance, dont deux fausses. Clef en a donné 213, Kev-4B 187 et Strands Decider 131, sans aucune erreur.
Chaque modèle calcule son assurance à sa façon. Kev et Strands Decider la corrigent selon le nombre d'options, alors que Clef donne la probabilité de son premier choix. Recalculée avec la formule de Kev, l'assurance de Clef atteint ce niveau pour 197 réponses, et celle de Clef-flash pour 218. L'ordre ne change pas.
Difficulté et réponses longues
Clef et Clef-flash sont les meilleurs pour évaluer la difficulté. Tous deux placent une requête à un niveau près du nôtre 98 % du temps, contre 90 % pour Strands Decider et 88 % pour Kev-4B. Ils tombent sur le niveau exact 46 % du temps, contre 41 % pour Kev-4B.
Dix de nos 328 requêtes demandent une réponse longue. Clef a repéré les dix, et en a signalé deux autres à tort. Kev-4B en a repéré sept, sans fausse alerte. Clef-flash a aussi trouvé les dix, avec 13 fausses alertes. Strands Decider en a trouvé huit, avec 58 fausses alertes.
Vitesse et mémoire sur un GB10
Nous avons chronométré la décision à trois questions des articles précédents, chaque fois sur une requête nouvelle, de la requête courte à celle de 4 000 tokens.
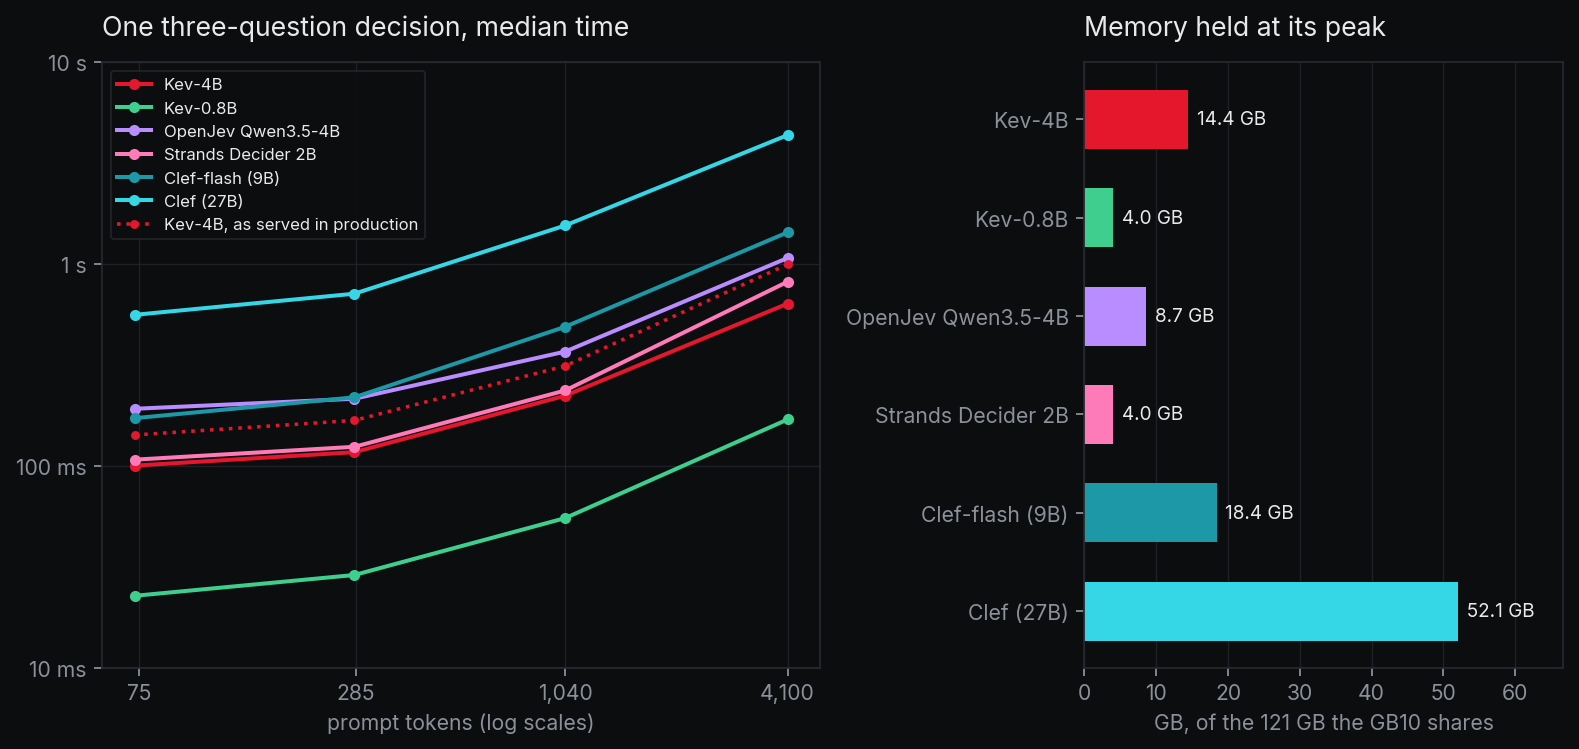
Kev-4B est le plus rapide des grands modèles : 101 millisecondes pour une requête courte, 639 pour une longue. Strands Decider, deux fois plus petit, prend 108 et 820 millisecondes. Le code qui sert Kev prépare ses calculs à l'avance, ce que ne fait pas le code de référence de Strands Decider.
Clef-flash prend 173 millisecondes et 1,4 seconde. Clef prend 562 millisecondes et 4,4 secondes, soit de cinq à sept fois plus que Kev-4B.
Dans ses propres tests, Cloudflare annonce un temps médian de 209 millisecondes pour Clef et de 39 pour Clef-flash. Sur le GB10, une décision à une seule question sur les requêtes publiques a pris 428 et 141 millisecondes en médiane. Un GB10 est une machine de bureau, pas un GPU de centre de données.
Sur cette machine, la mémoire compte davantage, parce que le processeur et le GPU puisent dans la même réserve. Clef en occupe 52 Go, plus des deux cinquièmes, et met environ six minutes à se charger. Clef-flash occupe 18 Go, Kev-4B 14 Go et Strands Decider 4 Go, autant que Kev-0.8B.
Ces temps sont le meilleur cas pour chaque modèle : seul sur la machine, sans réseau entre les deux. En production, Kev-4B partage son GB10 avec d'autres modèles et répond à travers une API : la même décision y prend 143 millisecondes et 1 seconde.
Le modèle que personne n'a entraîné
L'article précédent laissait une question ouverte : la vitesse du Qwen3.5-4B d'OpenJev sur le GPU qui sert Kev. OpenJev n'entraîne rien : il demande à un modèle de conversation ordinaire de choisir la lettre d'une option. Nous l'avons repassé sur la même machine, avec les questions reformulées.
Il reste le modèle le plus juste sur nos requêtes : 97,0 %, en anglais comme en français. Il reconnaît toutes les conversations courantes et 30 des 32 étapes d'agent. Quand les étapes d'agent sont lues dans la requête, il est à 97,6 % et Kev-4B à 97,3 % : une seule requête les sépare.
Il reste aussi le plus sûr de lui. Il a donné 292 réponses avec 90 % de confiance ou plus, dont quatre fausses. Sur les requêtes publiques, il se trompe avec assurance sur 19 % des requêtes, le chiffre le plus élevé du tableau.
Sur le GPU du GB10, sa décision à trois questions prend 192 millisecondes pour une requête courte et 1,1 seconde pour une longue, dans 9 Go. C'est environ le double de Kev-4B pour une requête courte, et plus rapide que Clef.
Ce que cela ne prouve pas
- Chaque modèle n'a tourné qu'une fois, sur deux ensembles de requêtes. Un type compte de 20 à 66 de nos requêtes : pour le plus petit, une seule erreur déplace le chiffre de cinq points.
- Nous avons rédigé et étiqueté les 328 requêtes, et réglé leurs questions sur Kev-4B. Les deux benchmarks ne demandent qu'une chose : de quel type de travail relève une requête. Les tableaux de Cloudflare couvrent une quarantaine d'autres tâches, du choix d'un outil à la lecture de contrats, et placent Clef devant Jev et Kev-9B sur la plupart d'entre elles.
- Clef et Strands Decider ont tourné avec le code publié par leurs auteurs. Le code qui sert Kev est optimisé pour la vitesse, et celui que Cloudflare exploite en production l'est sans doute aussi. Les écarts de temps en disent autant sur le logiciel que sur les modèles.
- Nous n'avons testé que du texte. Clef lit aussi des images et de la vidéo, ce que ne fait aucun autre modèle de cet article.
- Nous n'avons pas rappelé Jev. Ses chiffres viennent du premier benchmark, et il n'a jamais été passé sur nos requêtes.
Ce que cela change pour CARouter
Kev-4B reste derrière /v1/decisions. Clef n'est plus juste sur nos requêtes que là où notre plateforme connaît déjà la réponse. Sur une machine qui sert d'autres modèles, il prendrait 52 Go et cinq fois plus de temps.
Clef-flash est le plus pratique des deux. Il arrive en tête sur les requêtes publiques dans les deux langues et évalue mieux la difficulté que Kev, pour 18 Go et moins de 200 millisecondes sur une requête courte. Mais il prend la moitié de nos requêtes de recherche pour autre chose.
Du côté des petits modèles, Strands Decider est celui à suivre. Dans les 4 Go qu'occupe Kev-0.8B, il gagne sept points de justesse sur nos requêtes et onze sur les requêtes publiques en anglais, sans jamais se tromper avec assurance sur les nôtres. Il est aussi près de cinq fois plus lent que Kev-0.8B, et moins bon en français.
La question ouverte reste celle du dernier article. Un Qwen3.5-4B que personne n'a entraîné est celui qui comprend le mieux nos requêtes, et nous savons maintenant ce qu'il coûte sur le GPU : 192 millisecondes et 9 Go. Son assurance sur d'autres types de requêtes reste à vérifier, et le test de sélection complet reste à passer avec lui.
Toutes les mesures derrière cet article sont conservées, et nous les partagerons avec quiconque le demande.