Comment nous avons rendu nos modèles 79 % plus rapides sur les GPU Intel
Nos deux cartes Intel Arc Pro B60 servent Qwen3.6 35B-A3B. L'essentiel de chaque étape se passait dans Python, sur le processeur du serveur, et non sur les cartes. Le moteur enregistre maintenant le calcul du modèle une fois et le rejoue : avec deux requêtes sur une carte, chacune reçoit 64 tokens par seconde au lieu de 36, avec quatre 55 au lieu de 35, et avec huit 44 au lieu de 35, sur le même matériel.
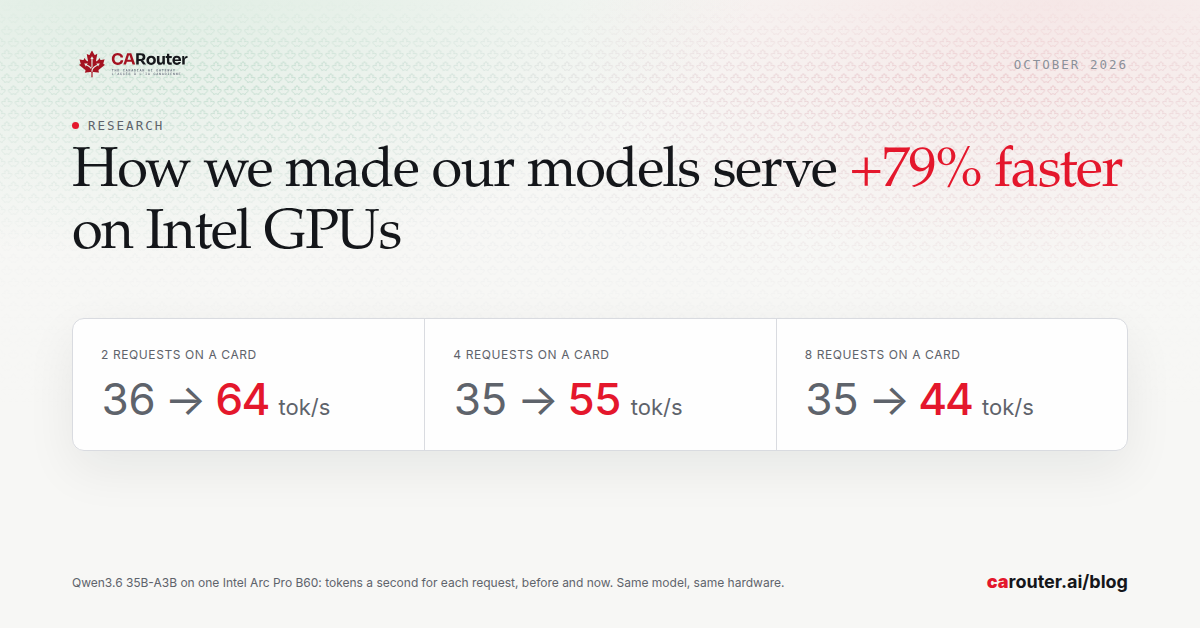
CARouter Cloud sert Qwen3.6 35B-A3B sur deux cartes graphiques Intel Arc Pro B60 à Ottawa, à côté de son GB10. Les mêmes cartes écrivent maintenant jusqu'à 79 % de tokens de plus par seconde pour chaque requête.
Le matériel, le modèle et sa forme à 4 bits n'ont pas changé. Le temps se perdait sur le processeur du serveur, pas sur les cartes.
L'article qui a présenté ce serveur : Qwen3.6 35B-A3B sur deux cartes Intel Arc Pro B60.
En bref
- Ce que voit un client. Avec deux requêtes sur une carte, chacune reçoit 64 tokens par seconde au lieu de 36. Avec quatre, 55 au lieu de 35. Avec huit, 44 au lieu de 35. Seule, 72 au lieu de 60.
- Ce que nous avons changé. Le moteur enregistre maintenant le calcul du modèle une fois et le rejoue. Avant, il faisait passer chaque étape par Python.
- Ce qui faisait obstacle. Deux appels de journalisation dans la version de vLLM d'Intel. Nous les retirons quand nous construisons notre propre image.
- Comment nous l'avons testé. 450 prompts dans les deux modes, un appel d'outil, une question de raisonnement, et des prompts de 29 000 et 101 000 tokens.
- Ce que ça coûte. Un premier démarrage plus long, et environ 6 % de place en moins pour les prompts que le moteur garde en mémoire.
Où passe le temps d'une requête
Nos moteurs comptent ce qu'ils font. Écrire la réponse représente environ neuf dixièmes du temps d'une requête, et une carte écrit le plus souvent pour environ deux requêtes à la fois.
C'est là que ce serveur était le plus faible. Une requête seule recevait 60 tokens par seconde. De deux à huit requêtes sur une carte, chacune en recevait environ 35.
La carte attendait Python
Notre premier article sur ce serveur notait qu'un seul fil d'exécution du processeur donne la cadence à chaque moteur. Cette fois, nous avons regardé ce que fait ce fil.
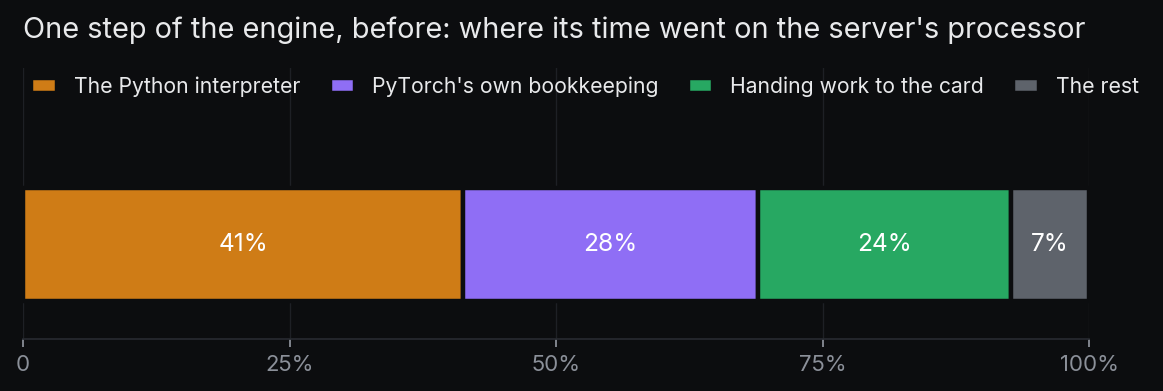
Environ 70 % de chaque étape allaient à l'interpréteur Python et à l'intendance propre à PyTorch, sur ce seul fil. Environ un quart servait à confier le travail à la carte. La carte elle-même avait du temps libre.
Cela explique ce 35 qui ne bougeait pas. L'essentiel du coût d'une étape était fixe, quel que soit le nombre de requêtes.
Enregistrer une fois, puis rejouer
vLLM peut enregistrer le calcul du modèle une fois, sous forme de graphe, et le rejouer à chaque étape. Rejouer évite l'essentiel du travail de Python.
La version de vLLM d'Intel est livrée avec ce mode désactivé, et pour ce modèle il ne démarrait pas. La cause était petite : deux appels de journalisation se trouvent dans du code que le compilateur de PyTorch doit suivre, et le compilateur s'arrête dessus.
Nous retirons ces deux appels quand nous construisons notre propre image. Le problème, tel qu'il a été signalé à Intel.
Ce que nous avons mesuré
Même carte, même jour, dans les deux modes, pendant que l'autre carte servait des clients.
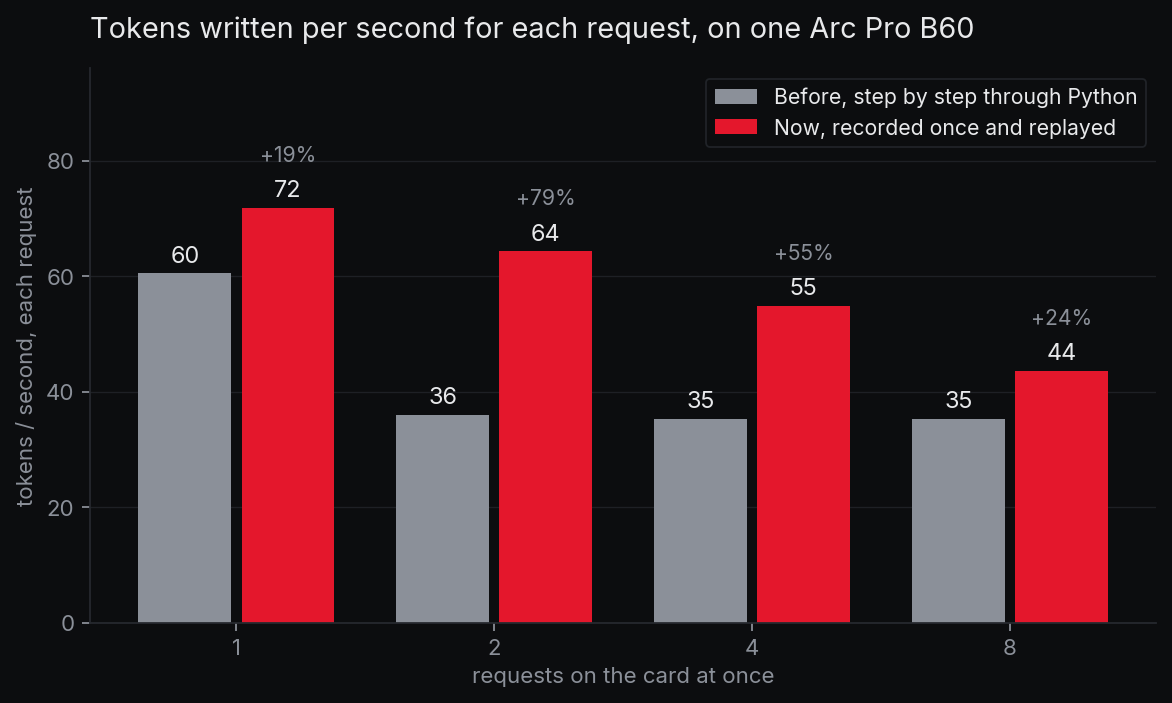
Avec deux requêtes sur une carte, chacune reçoit 64 tokens par seconde au lieu de 36, soit 79 % de plus. Avec quatre, c'est 55 au lieu de 35, et avec huit 44 au lieu de 35. Une requête seule reçoit 72 au lieu de 60.
Au total, une carte écrit 129 tokens par seconde avec deux requêtes au lieu de 72, et 349 avec huit au lieu de 282. La lecture d'un prompt est aussi rapide qu'avant, environ 5 900 tokens par seconde.
L'assistant intégré au modèle, qui n'était pas payant sur ce serveur, l'est maintenant pour une ou deux requêtes : 111 et 88 tokens par seconde chacune. À partir de quatre requêtes, il est plus lent que sans lui, donc il reste désactivé.
Ce que nous avons vérifié avant de le servir
Intel décrit ce mode comme pas encore pris en charge dans cette version. Nous n'avons donc pas cru la vitesse sur parole.
Nous avons envoyé 450 prompts différents aux deux modes et compté les réponses qui contiennent une longue suite d'un même caractère répété, un signe connu de défaut. Il y en avait 3 dans chaque mode, toutes des traits de tableau.
Un appel d'outil, une question de raisonnement, et un fait caché dans des prompts de 29 000 et 101 000 tokens sont revenus justes dans les deux modes. Un échantillon de cette taille montrerait un défaut fréquent, pas un défaut rare.
Nous avons ensuite basculé une carte à la fois, après avoir déplacé son trafic vers l'autre carte.
Ce que ça coûte
Le moteur met environ deux fois plus de temps à démarrer la première fois, parce qu'il prépare les graphes, et il les garde pour le démarrage suivant.
Il laisse aussi environ 6 % de place en moins pour les prompts qu'il garde en mémoire.
Sur une petite carte, la première chose à mesurer est le processeur qui se trouve à côté.